Kapitel 7: Sortieren
In diesem Kapitel werden bekannte Algorithmen zum Sortieren vorgestellt. Die Verfahren eignen sich gut, um grundsätzliche Programmierstrategien wie Greedy, Divide & Conquer und Rekursion zu behandeln. Eine Greedy-Strategie versucht durch gieriges Vorgehen das jeweils kurzfristig Bestmögliche zu erreichen. Bei Divide & Conquer wird zunächst das gegebene Problem in Teilprobleme zerlegt, dann deren Lösungen errechnet und diese dann anschließend zur Gesamtlösung zusammengeführt. Rekursive Verfahren lösen die ursprüngliche Aufgabenstellung auf einer reduzierten Problemgröße mit demselben Lösungsansatz und konstruieren aus dieser Teillösung die Gesamtlösung.
Motivation: Ein erheblicher Teil der Rechenzeit moderner Programme entfällt auf Such- und Sortieroperationen.
Vorbereitung
Um die folgenden Sortieralgorithmen konsistent testen zu können, schreiben wir uns ein Treiberprogramm. In ihm brauchen wir dann nur den Sortieraufruf in Zeile 17 modifizieren und können dadurch den zu verwendenden Sortier-Algorithmus austauschen.
 1import de.pakad.udemy.StdOut;
 2
 3/**
 4 * Treiberprogramm zum Testen der im Seminar behandelten
 5 * Sortieralgorithmen.
 6 * <ul>
 7 * <li>{@link BubbleSort}</li>
 8 * <li>{@link HeapSort}</li>
 9 * <li>{@link MergeSort}</li>
10 * <li>{@link QuickSort}</li>
11 * <li>{@link SelectionSort}</li>
12 * </ul>
13 */
14public class SortDriver {
15
16    /**
17     * Es werden Integer-Arrays verschiedener Größen sortiert und die
18     * jeweilige Zeitdauer gemessen.
19     * <p>
20     * Als Kommandozeilenparameter werden Mindestgröße, Maximalgröße
21     * und Schrittweite der Vergrößerung des zu sortierenden Arrays
22     * angegeben.
23     * </p>
24     *
25     * @param args <br>
26     * [0] - Mindestgröße des zu sortierenden Arrays<br>
27     * [1] - Maximalgröße des zu sortierenden Arrays<br>
28     * [2] - Schrittweite der Vergrößerung
29     */
30    public static void main(String[] args) {
31        int n = Integer.parseInt(args[0]); // Mindestgröße
32        int N = Integer.parseInt(args[1]); // Maximalgröße
33        int s = Integer.parseInt(args[2]); // Schrittweite
34
35        // absteigend sortierte Arrays zum Sortieren
36        for (int size = n; size <= N; size+=s) {
37            int[] a = new int[size];
38            for (int i = 0; i < size; i++) {
39                a[i] = size - i;
40            }
41            long startTime = System.nanoTime();
42            HeapSort.sort(a);  // Sortieralgorithmus austauschen
43            long endTime = System.nanoTime();
44            double elapsed_ms = (endTime - startTime) / 1000000.0;
45            StdOut.printf("%6d\t %9.4f\n", size , elapsed_ms); // MSec
46        }
47    }
48}
Listing 7.1: SortDriver.java
Das Programm generiert eine Reihe zu sortierender Arrays. Über Kommandozeilenargumente ist festlegbar, wie viele Testdaten wir generieren wollen.
Auch wenn Sie im vorangegangenen Kapitel gelernt haben, dass eine Zeitmessung kein geeignetes Instrument ist, um die Qualität eines Algorithmus zu beurteilen, gibt Sie uns doch Anhaltspunkte für unsere diesbezüglichen Überlegungen. Zudem können wir die ausgegebenen Messdaten verwenden, um entsprechende Laufzeitdiagramme anzufertigen, welche die Anzahl der verarbeiteten Daten zur gemessenen Laufzeit in Relation setzen.
Hinweis: Das Treiberprogramm generiert stets absteigend sortierte Daten. Das sichert uns zu, weil die hier besprochenen Algorithmen aufsteigend sortieren, immer sortieren zu müssen. Eine absteigende Sortierung heißt ausdrücklich nicht, jedem hier vorgestellten Algorithmus eine möglichst schlechte Vorgabe zu machen, die einen erhöhten Aufwand für ihn bedeutet.
SelectionSort
Grundidee: „Hole das kleinste Element nach vorne."
 1/** Sortierung eines {@code int}-Arrays mit SelektionSort */
 2public class SelectionSort {
 3
 4    /**
 5     * Sortiert ein {@code int}-Array {@code a} mithilfe des
 6     * SelectionSort-Algorithmus.
 7     *
 8     * @param a zu sortierendes Array
 9     */
10    public static void sort(int[] a) {
11        int i, j, pos, min;       // 2 Indizes, Position, Minimum
12
13        // durchlaufe Array
14        for (i = 0; i < a.length - 1; i++) {
15            pos = i;              // Position des bisher kleinsten
16            min = a[i];           // Wert des bisher kleinsten
17            // durchlaufe Rest des Arrays
18            for (j = i + 1; j < a.length; j++)
19                if (a[j] < min) { // falls kleineres gefunden
20                    pos = j;      // Position merken
21                    min = a[j];   // Wert merken
22                }
23            a[pos] = a[i];        // speichere kleineres um
24            a[i] = min;           // neues kleinstes nach vorn
25        }
26    }
27}
Listing 7.2: SelectionSort.java
Der Algorithmus ist in Form von Programmkommentaren dokumentiert.
Hier ein kurzes Zahlenbeispiel, welches zeigt, wie sich das Array in den einzelnen Iterationen sukzessive entwickelt.
Beispiel:
4  9  3  2  5
2  9  3  4  5
2  3  9  4  5
2  3  4  9  5
2  3  4  5  9
Test
Im Treiberprogramm SortDriver.java tragen wir in Zeile 42 SelectionSort als zu verwendenden Algorithmus für den Aufruf von sort() ein. Damit wählen Sie den zu verwendenden Sortieralgorithmus.
$ java SortDriver 500 100000 500
   500      1.1023
  1000      0.2723
  1500      2.1609
  2000      0.7135
  2500      1.0767
  3000      1.4663
   ...
 99500   2343.9386
100000   2379.0823
$ _
Hinweis: Die obigen Testdaten habe ich auf meinem System erstellt. Bei Ihnen werden Sie abweichen. Das Ergebnis ist auch davon abhängig, wie der Rechner durch andere Prozesse ausgelastet ist, was nochmals unterstreicht, dass Messdaten kein objektives Beurteilungskriterium für die Güte von Algorithmen darstellen.
Das Sortierprogramm wird mit dem eingestellten Sortieralgorithmus ausgeführt. Es beginnt mit einem zu sortierenden Array der Größe $500$. In Schritten von jeweils $500$ mehr zu sortierenden Elementen, sortiert es Arrays bis zu einer Größe von $100,000$ Elementen. Die Messdaten (Anzahl Elemente, Zeitdauer in Millisekunden) wird auf der Standardausgabe ausgegeben.
Beobachtung: Obgleich wir stets in $500$er-Schritten vorgehen, das zu sortierende Datenvolumen zu steigern, nimmt die Laufzeit überproportional zu. Sie erkennen auch Irritationen. Der erste Messwert ist größer als der zweite. Das ist der Initialisierung von Programm- und Laufzeitumgebung geschuldet.
Analyse
Worst Case, Best Case und Average Case:
Die zwei ineinander geschachtelten for-Schleifen resultieren in:
Dabei abstrahieren wir von den konkret auszuführenden Tauschoperationen. Wir konzentrieren und auf die Anzahl der erforderlichen Vergleiche.
Der Algorithmus profitiert nicht von bereits sortierten Zahlen.
Tipp
Alternativ zur einfachen Bildschirmausgabe können wir die Messdaten in einer Datei erfassen. Dazu leiten wir die Standardausgabe in eine Datei namens SelectionSort.tsv um.
$ java SortDriver 500 100000 500 > SelectionSort.tsv
$ _
Auf Unix-Systemen (macOS, Linux), können Sie den Programmaufruf modifizieren und während der Programmausführung die Messergebnisse gleichzeitig im Terminalfenster ausgeben.
$ java SortDriver 500 100000 500 | tee /dev/tty > SelectionSort.tsv
...
$ _
Die Datei mit den Messdaten können wir nutzen, um beispielsweise mit gnuplot, einem freien Programm zur Datenvisualisierung, eine grafische Darstellung zu erzeugen.
gnuplot -e 'plot "SelectionSort.tsv" with lines; pause -1'
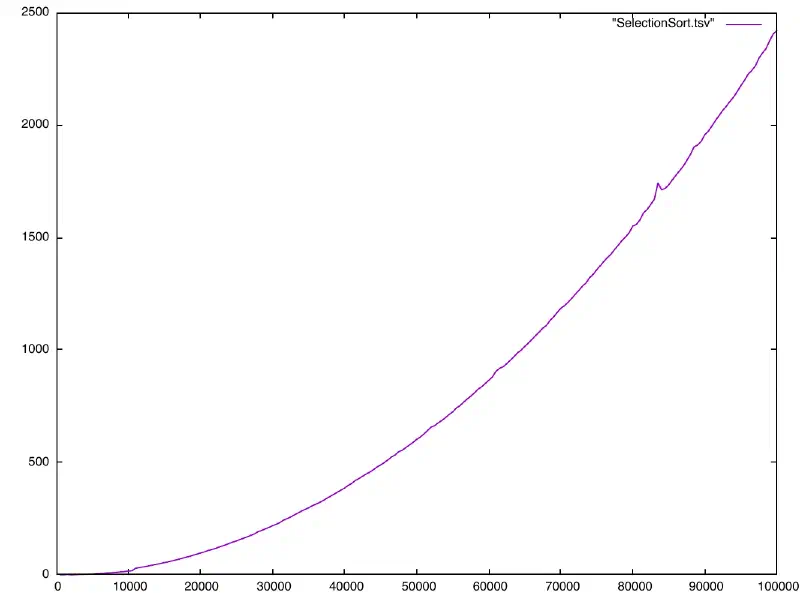
Der Kurvenverlauf bestätigt unsere Laufzeitanalyse.
SelectionSort ist nicht stabil, da beim Tauschen gleiche Elemente ihre relative Reihenfolge verlieren können, sofern nicht zusätzliche Maßnahmen getroffen werden.
BubbleSort
Grundidee: „Vertausche jeweils unsortierte Nachbarn."- Die großen Werte „steigen auf" wie Blasen.
 1/**
 2 * Implementierung des <i>BubbleSort</i>-Algorithmus
 3 * für ein Array von {@code int}-Werten.
 4 */
 5public class BubbleSort {
 6    /**
 7     * Sortierung des {@code int}-Arrays {@code a}.
 8     *
 9     * @param a {@code int}-Array
10     */
11    public static void sort(int[] a) {
12        int tmp;
13        boolean swapped;
14
15        do {
16            swapped = false;          // in aktueller Runde noch nicht getauscht
17            for (int i=0; i<a.length-1; i++) {
18                if (a[i] > a[i+1]) {  // falls aktuelles Element größer als rechter Nachbar,
19                    tmp = a[i];       // dann tauschen die beiden ihre Positionen
20                    a[i] = a[i+1];
21                    a[i+1] = tmp;
22                    swapped = true;   // merke: es wurde getauscht
23                }
24            }
25        } while (swapped);
26    }
27}
Listing 7.3: BubbleSort.java
Anmerkung: Die innere Schleife bezüglich des rechten Randes zu begrenzen, ist ein sicherlich richtiger Gedanke.
public class BubbleSort {
    public static void sort(int[] a) {
        ...
        int rgt = a.length;

        do {
            swapped = false;
            // Die Schleife läuft nur bis (rgt - 1).
            // Nach jeder Runde verringern wir rgt, da
            // das größte Element hinten sicher steht.
            for (int i=0; i<rgt-1; i++) {
                if (a[i] > a[i+1]) {
                    ...
                }
            }
            rgt--; // Rechter Rand verschiebt sich nach links
        } while (swapped);
    }
}
Der Effekt ist jedoch gering. Dafür macht er die Laufzeitanalyse schwieriger zu verstehen.
Beispiel:
    Array       |  Tausch  |  Tausch  |  Tausch  |
----------------+----------+----------+----------|
4  9  3  2  5   |   9  3   |   9  2   |   9  5   |
4  3  2  5  9   |   4  3   |   4  2   |          |
3  2  4  5  9   |   3  2   |          |          |
2  3  4  5  9   |          |          |          |
Test
Grundsätzlich profitiert der BubbleSort, so wie wir ihn implementiert haben, von bereits sortierten Daten. Die Statusvariable swapped sorgt dafür, das Vergleichen und Tauschen einzustellen, sobald das Array sortiert ist. Unsere Testdaten, absteigend geordnete Arrays, stellen für den Algorithmus jedoch den Worst Case dar. Er muss deshalb, um es umgangssprachlich zu formulieren, über die volle Distanz gehen, bevor swapped den Wert false annimmt und so das Ende signalisiert.
$ java SortDriver 500 100000 500 | tee /dev/tty > BubbleSort.tsv
   500       2.3272
  1000       1.1452
  1500       2.9478
  ...
100000   11035.6584
$ _
Beobachtung: Der BubbleSort sortiert hier, obgleich er „gewitzter" erscheint, deutlich langsamer als der SelectionSort.
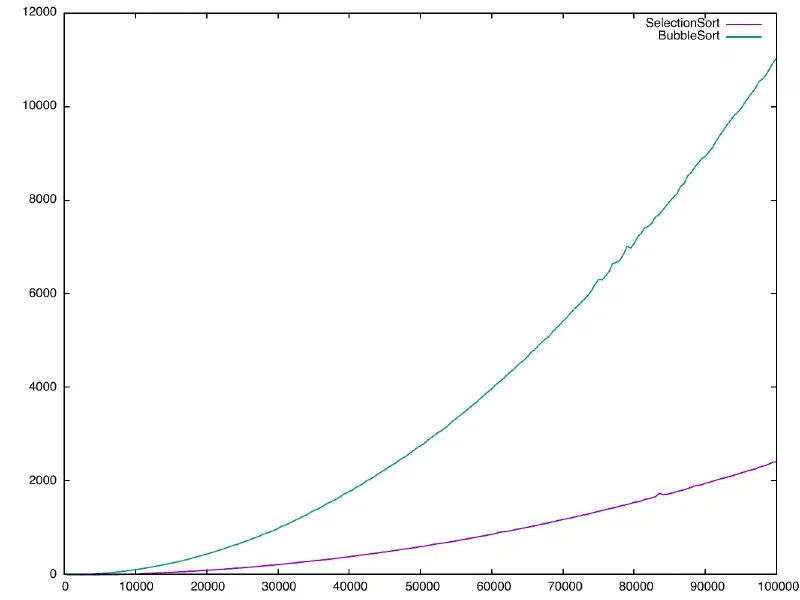
Ich habe die Messdaten von BubbleSort und SelectionSort einmal grafisch verglichen. Dazu habe ich die gespeicherten Messreihen, SelectionSort.tsv und BubbleSort.tsv in einer Datei gemischt. Unter macOS (aber auch Linux) geht das mit dem folgenden Kommando:
$ paste SelectionSort.tsv BubbleSort.tsv | \
> awk -F'\t' '{$3=""; print $0}' > Selection_vs_Bubble.tsv
$ _
Die Dateien werden gemischt, sodass die Messdaten zeilenweise korrespondierend nebeneinander stehen (paste). Die dritte Spalte, mit den dann doppelt aufgezeichneten Datenanzahlen, wird dann ausgeschnitten (awk). - Unter Microsoft Windows geht das so, wenn Sie keine weitere Software installiert haben, nicht. Vielleicht versuchen Sie es dann mit einem Tabellenkalkulationsprogramm, wie beispielsweise LibreOffice Calc oder Microsoft Excel, die Datenreihen nebeneinander zu stellen.
Für die grafische Aufbereitung habe ich wieder gnuplot verwendet.
Aus drucktechnischen Gründen breche ich das von mir verwendete Kommando hier um:
gnuplot -e 'plot
    "Selection_vs_Bubble.tsv" using 1:2 title "SelectionSort" with lines,
    "Selection_vs_Bubble.tsv" using 1:3 title "BubbleSort" with lines;
    pause -1'
Die beobachteten Resultate werfen die Frage auf, woran das liegt, woher die unterschiedlichen Laufzeiten resultieren. Unsere Testdaten provozieren die beobachteten Messergebnisse geradezu, liefern uns aber auch den entsprechenden Anhaltspunkt, über die Frage nachzudenken.
BubbleSort ist bei absteigend sortierten Daten (für aufsteigende Sortierung) extrem ineffizient. Er benötigt maximale Tauschoperationen, da jedes Element an das andere Ende wandern muss. Die formale Analyse wird zeigen, dass BubbleSort, ebenso wie SelectionSort eine $\mathcal{O}(n^{2})$-Laufzeit besitzt. SelectionSort führt aber deutlich weniger Tauschoperationen durch, da er pro Durchlauf nur einmal vertauscht. Diese Analyse ist wichtig zu bemerken. Das $\mathcal{O}$-Kalkül verwischt diese Differenzierung. Trotz dessen zwei Algorithmen in die gleiche $\mathcal{O}$-Kategorie fallen, können sie sich bezüglich realer Laufzeiten massiv unterscheiden.
Das $\mathcal{O}$-Kalkül sagt also nichts über reale Laufzeiten aus. Wir können daraus lediglich ableiten, wie sich eine Laufzeit bei zum Beispiel Verdoppelung der Eingabegröße verändert. Bezüglich beider Algorithmen stellen Sie fest, wenn Sie sich die Messdaten ansehen, dass sich bei einer Verdoppelung der Eingabe, die Laufzeit vervierfacht.
Analyse
Worst Case: Zwei ineinander geschachtelte Schleifen resultieren in $\mathcal{O}(n^2)$.
Best Case: Das Array wird nur einmalig durchlaufen, weil wir uns im Algorithmus gemerkt haben, ob getauscht wurde oder nicht. Das ergibt $\mathcal{O}(n)$.
Die kleinste Zahl wandert in der for-Schleife jeweils um eine Position nach links. Wenn Sie zu Beginn ganz rechts steht, sind $n-1$ Phasen notwendig. Die Austauschpositionen liegen zu eng beieinander, sodass im Endeffekt $\mathcal{O}(n^2)$ gilt. BubbleSort ist stabil, da beim Tauschen gleiche Elemente ihre relative Reihenfolge beibehalten. Der Algorithmus arbeitet in place, benötigt also keinen zusätzlichen Speicherplatz.
MergeSort
Grundidee: rekursive Formulierung
- sortiere die vordere Hälfte der Folge
- sortiere die hintere Hälfte der Folge
- mische die beiden sortierten Folgen zu einer sortierten Folge
Diese Vorgehensweise wird Divide & Conquer (teile und herrsche) genannt, da das ursprüngliche Problem zunächst in unabhängige Teilprobleme zerlegt wird. Danach werden die Teillösungen wieder zusammengeführt.
Das Mischen bedarf der Erläuterung. Betrachten Sie die folgende Darstellung, die die Mischvorgänge zeigt.
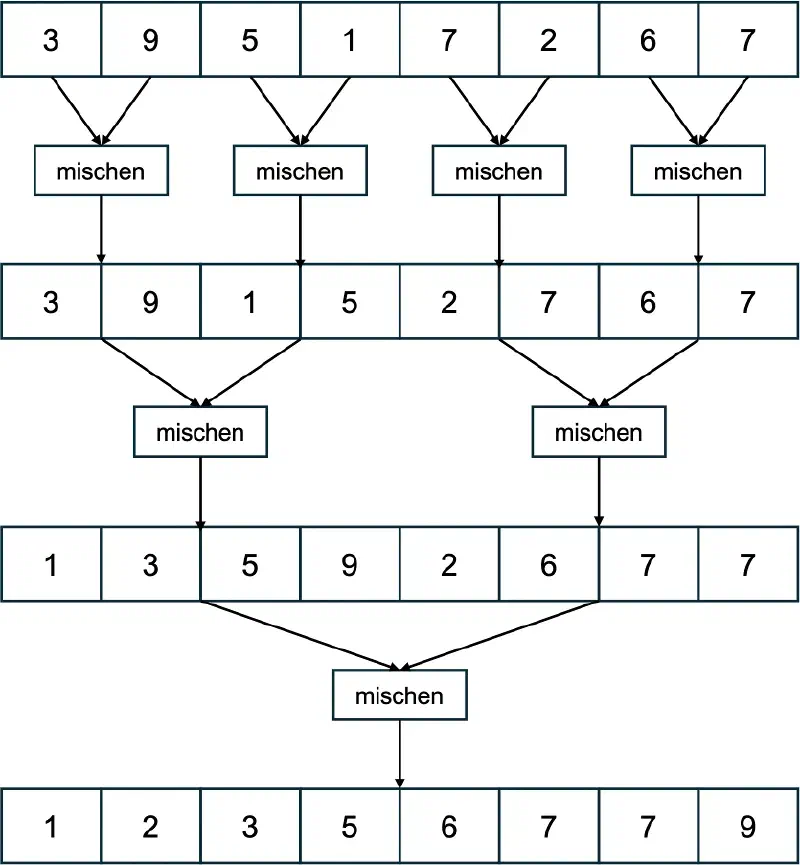
Zuerst wird das Array in der Mitte geteilt. Das wiederholt sich rekursiv, sowohl für die linke als auch die rechte Hälfte des Arrays. Der Basisfall, die Rekursionsbremse, tritt ein, wenn die Array-Länge kleiner als 2 wird. Bei nur einem Element gibt es nichts zu sortieren. - Jetzt betrachten wir also eine Vielzahl 1-elementiger Teil-Arrays. Diese werden jetzt dergestalt zusammengemischt, dass das kleinste Element beider Arrays in das Ziel-Array übertragen wird, dann das zweit-kleinste, das dritt- und am Ende das viert-kleinste Element. So geht das weiter, den gesamten durch die Rekursion aufgebauten Stapel abwärts. Am Ende ist das ursprüngliche Array sortiert.
 1/** Sortierung eines {@code int}-Arrays mit MergeSort */
 2public class MergeSort {
 3    /**
 4     * Sortiert ein {@code int}-Array {@code a} mithilfe des
 5     * MergeSort-Algorithmus.
 6     *
 7     * @param a zu sortierendes Array
 8     */
 9    public static void sort(int[] a) {
10        int n = a.length;
11        if (n < 2) {
12            return;
13        }
14        // Array in der Mitte teilen (Divide)
15        int mid = n / 2;
16        // Hilfs-Array für linke Hälfte von a
17        int[] lftArray = new int[mid];
18        // Hilfs-Array für rechte Hälfte von a
19        int[] rgtArray = new int[n - mid];
20
21        // linkes und rechts Hilfs-Array füllen
22        System.arraycopy(a, 0, lftArray, 0, mid);
23        System.arraycopy(a, mid, rgtArray, 0, n - mid);
24        sort(lftArray);  // linke Hälfte rekursiv sortieren (Divide)
25        sort(rgtArray);  // rechte Hälfte rekursiv sortieren (Divide)
26
27        // Array-Hälften mischen (Conquer)
28        merge(a, lftArray, rgtArray, mid, n - mid);
29    }
30
31    /**
32     * Mischen zweier jeweils sortierter Arrays, lftArray und
33     * rgtArray, in das Ziel-Array a.
34     *
35     * @param a        Ziel-Array in das gemischt wird
36     * @param lftArray linkes Quell-Array
37     * @param rgtArray rechtes Quell-Array
38     * @param lftIndex max. linker Index des Ziel-Arrays
39     * @param rgtIndex max. rechter Index des Ziel-Arrays
40     */
41    private static void merge(int[] a,
42                              int[] lftArray, int[] rgtArray,
43                              int lftIndex, int rgtIndex) {
44        int i = 0, j = 0, k = 0;
45        // linkes und rechts Array mischen
46        while (i < lftIndex && j < rgtIndex) {
47            if (lftArray[i] <= rgtArray[j]) {
48                a[k++] = lftArray[i++];
49            } else {
50                a[k++] = rgtArray[j++];
51            }
52        }
53
54        // wenn vorhanden, Rest von links an a anfügen
55        while (i < lftIndex)
56            a[k++] = lftArray[i++];
57
58        // wenn vorhanden, Rest von rechts an a anfügen
59        while (j < rgtIndex)
60            a[k++] = rgtArray[j++];
61    }
62}
Listing 7.4: MergeSort.java
Der Algorithmus folgt dem Divide-and-Conquer-Prinzip: Der Divide-Schritt erfolgt rekursiv, indem das Array immer wieder in zwei Hälften aufgeteilt wird, bis die Basisgröße erreicht ist. Der anschließende Conquer-Schritt (merge()) wird iterativ über Schleifen ausgeführt, um die sortierten Teil-Arrays effizient und stabil wieder zusammenzuführen.
Test
Mit dem Testen sind Sie bereits vertraut. Führen Sie eigene Tests durch, notieren Sie Ihre Beobachtungen, bereiten Sie sie gegebenenfalls grafisch auf und versuchen Sie sie zu erklären.
Hinweis: Das vermutlich zackige Aussehen der Kurve (das sogenannte „Rauschen“ oder „Jitter“) ist bei Performance-Messungen in Java völlig normal. Es liegt nicht an einer ungleichmäßigen Auslastung Ihres Prozessors durch andere Programme, sondern an der Funktionsweise der Java Virtual Machine (JVM) und modernen Betriebssystemen.
Hier sind die drei Hauptgründe, warum die Kurve so zackig ist:
-
Der Garbage Collector (GC)
Das Problem: MergeSort benötigt bei jedem Sortiervorgang zusätzlichen Speicherplatz (typischerweise temporäre Arrays). Da wir in der Schleife fortlaufend neue Arrays erzeugen und verwerfen, sammelt sich im Heap-Speicher schnell Datenmüll an.
Die Auswirkung: Der Garbage Collector der JVM springt in unregelmäßigen Abständen im Hintergrund an, um diesen Speicher wieder freizugeben. Selbst extrem kurze GC-Pausen (Bruchteile von Millisekunden) führen bei den ohnehin sehr kurzen Laufzeiten von MergeSort zu sichtbaren Ausschlägen (nach oben) in einer Grafik.
-
JIT-Kompilierung und JVM-Optimierung
Das Problem: Die JVM führt Java-Code anfangs als interpretierten Bytecode aus. Erst wenn eine Methode sehr oft aufgerufen wird („Hotspot“), optimiert der Just-In-Time (JIT) Compiler den Code im Hintergrund und übersetzt ihn in hoch optimierten Maschinencode.
Die Auswirkung: Während des Profilings optimiert, de-optimiert und re-optimiert die JVM den Code dynamisch. Diese Hintergrundaktivität des JIT-Compilers benötigt CPU-Zeit und sorgt für Leistungsschwankungen in den ersten Phasen der Messung.
-
Betriebssystem-Schedules und Cache-Effekte
Das Problem: Auch wenn der Rechner im Leerlauf zu sein scheint, führt das Betriebssystem im Hintergrund Tausende kleinste Aufgaben aus (z. B. Netzwerk-Polling, Thread-Wechsel). Zudem misst
System.nanoTime()die exakte Wanduhrzeit, nicht die reine CPU-Zeit, die dem Java-Prozess zugewiesen wurde.Die Auswirkung: Wird der Thread genau während einer Messung für ein paar Mikrosekunden unterbrochen oder fliegt der Code aus dem schnellen CPU-Cache (Cache Miss), schnellt der Messwert für diesen spezifischen Durchlauf nach oben.
Den MergeSort dürfen Sie gerne auch mit Arrays von einer Million Daten und mehr beauftragen. Auf meinem System beträgt die gemessene Laufzeit für eine Million Daten etwa $22.3979$ Millisekunden, also nur den Bruchteil einer Sekunde. - Das ist eine erhebliche Performance-Steigerung gegenüber den bislang betrachteten Algorithmen.
Aufschluss über die Ursache dieser Verbesserung liefert uns ein Blick auf die schematische Darstellung des Mischens. Die Problemgröße wird bei jeder Rekursion halbiert. Das bedeutet: Für eine Million Daten sind das gerade etwa $20$ Durchläufe. Beim Mischen werden dann alle $n$ Datenelemente je einmal angefasst. Sodass wir insgesamt ca. $20$ Millionen Schritte machen. Das ist bedeutend weniger als ${1,000,000}^2$ bei Algorithmen der Kategorie $\mathcal{O}(n^2)$.
Analyse
Die formale Analyse von MergeSort ist schon einigermaßen anspruchsvoll. Für Interessierte skizziere ich sie dennoch, da sie sich für ähnlich gelagerte Rekursionen adaptieren lässt. Um die mathematische Kernidee sauber zu zeigen, nehmen wir an, dass $n$ eine Zweierpotenz ist ($n = 2^k$).
$$ f(n) = \left\{ \begin{array}{lcl} c_1 & , & n = 1 \\ 2 \cdot f(\frac{n}{2}) + c_2 \cdot n & , & n \in \mathbb{N}: n > 1 \\ \end{array} \right. $$Behauptung: $f \in \mathcal{O}(n\cdot \log_2(n))$
Zeige: $f(n) \leq (c_1 + c_2) \cdot n \cdot \log_2(n) + c_1$
Verankerung:
$$ \begin{array}{ll} n = 1 \Rightarrow & f(1) \leq c_1 \text{ nach Rekursion} \\ & f(1) \leq (c_1 + c_2) \cdot 1 \cdot \log_2(1) + c_1 \quad (\text{da } \log_2(1) = 0) \\ \end{array} $$Induktionsschluss:
Wir nehmen an, die Behauptung gilt für alle Werte kleiner als $n$ (Induktionsvoraussetzung). Wir zeigen nun den Schritt für $n$ unter Verwendung der Logarithmeneigenschaft $\log_2(\frac{n}{2}) = \log_2(n) - 1$:
$$\begin{array}{ll} f(n) & \leq 2 \cdot f(\frac{n}{2}) + c_2 \cdot n \\ & \uparrow \\ & \text{laut Definition der Rekursion} \\ & \leq 2 \cdot \left[ (c_1 + c_2) \cdot \frac{n}{2} \cdot (\log_2(n)-1) + c_1 \right] + c_2 \cdot n \\ & = (c_1 + c_2) \cdot n \log_2(n) - (c_1+c_2)\cdot n + 2 \cdot c_1 + c_2 \cdot n \\ & = [(c_1 + c_2) \cdot n \cdot \log_2(n) + c_1] + [c_1-c_1 \cdot n] \\ & \leq (c_1 + c_2)n \cdot \log_2(n) + c_1 \\ \end{array}$$Erklärung zum letzten Beweisschritt: An der vorletzten Stelle der Gleichung taucht der zusätzliche Term $[c_1 - c_1 \cdot n]$ auf. Warum darf dieser im letzten Schritt einfach weggelassen werden? Da wir uns im Induktionsschritt befinden, gilt für die Problemgröße immer $n \geq 2$. Setzt man nun eine beliebige Zahl größer oder gleich 2 für $n$ in den Term ein, wird das Ergebnis wegen des Abzugs von $c_1 \cdot n$ immer negativ (oder bei $n=1$ exakt Null) sein.
Da wir eine obere Schranke ($\leq$) beweisen wollen, gilt mathematisch: Wenn wir einen Term weglassen, der garantiert kleiner oder gleich Null ist, wird die rechte Seite der Gleichung dadurch im schlechtesten Fall nur größer oder gleich dem vorherigen Zustand. Die Ungleichung bleibt also absolut gültig.
Damit ist die obere Schranke formal bewiesen. Es gilt: $\mathcal{O}(n \cdot \log_2(n))$
Aber: MergeSort ist im Gegensatz zu Algorithmen wie QuickSort oder BubbleSort kein In-Place-Verfahren und benötigt $\mathcal{O}(n)$ zusätzlichen Speicherplatz! In unserer didaktischen Implementierung in der Klasse MergeSort verwenden wir zum Mischen je zwei Hilfsarrays, deren Speicherplatz wir dort in den Zeilen 17 und 19 reservieren.
QuickSort
Grundidee: Partitioniere die zu sortierende Folge in eine elementweise kleinere und eine elementweise größere Hälfte; sortiere diese nach demselben Verfahren.
Auch QuickSort arbeitet nach dem Prinzip Divide & Conquer. Das ursprüngliche Problem wird auch hier zunächst in unabhängige Teilprobleme zerlegt. Das Vorgehen ist jedoch gänzlich anders als beim MergeSort.
 8         3         9        (6)        5         4         7  (Ausgangsdaten)
[4        (3)        5]        6        [9         8         7]
]3[      [(4)        5]        6         9         8         7
]3         4[       ]5[        6         9        (8)        7
 3         4         5         6        ]7[        8        ]9[
 3         4         5         6         7         8         9  (fertig sortiert)
Abbildung 7.4: Visualisierung des Teilens und Mischens beim QuickSort
Der QuickSort verwendet ein sogenanntes Pivot-Element. Das ist quasi der Dreh- und Angelpunkt des Algorithmus.
In der hier implementierten Version ist es das mittlere Element des Arrays. Nachdem es ausgewählt ist, werden alle Elemente, die kleiner sind als das Pivot-Element auf die linke Seite des Arrays umgelagert. Die größeren Elemente wandern auf die rechte Seite. Im Idealfall, wenn das Pivot-Element der Median der zu sortierenden Daten war, haben wir zwei gleich große linke und rechte Hälften. Nimmt man, so wie wir hier, einfach das mittlere Element, unterscheiden sich linke und rechte Hälfte in der Regel bezüglich ihrer Größe. Ungeachtet dessen, wird dieser Vorgang nun wiederholt rekursiv ausgeführt, bis wir nur noch 1-elementige Teil-Arrays betrachten. Dann endet die Rekursion.
 1/**
 2 * Implementierung des <i>QuickSort</i>-Algorithmus
 3 * für ein Array von {@code int}-Werten.
 4 */
 5public class QuickSort {
 6
 7    /**
 8     * Sortierung eines {@code int}-Arrays mithilfe
 9     * des QuickSort-Algorithmus.
10     *
11     * @param a {@code int}-Array
12     */
13    public static void sort(int[] a) {
14        quicksort(a, 0, a.length-1);
15    }
16
17    /**
18     * Rekursives Sortieren mit QuickSort. Als Pivot-Element
19     * wird das mittlere Element des jeweils zu sortierenden
20     * Teil-Arrays verwendet.
21     *
22     * @param a        zu sortierender {@code int}-Array-Teil
23     * @param lftIndex linker Index des Teil-Arrays
24     * @param rgtIndex rechter Index Teil-Arrays
25     */
26    private static void quicksort(int[] a, int lftIndex, int rgtIndex) {
27        int tmp;                              // Hilfsvariable
28        int i = lftIndex;                     // untere Intervallgrenze
29        int j = rgtIndex;                     // obere Intervallgrenze
30        int mid = (lftIndex + rgtIndex) / 2;  // mittlere Position
31        int x = a[mid];                       // Pivot-Element
32
33        // alle Elemente kleiner als x nach links, alle Elemente
34        // größer als x nach rechts -> zwei Partitionen
35        do {
36            while (a[i] < x) i++;             // fungiert als Bremse
37            while (a[j] > x) j--;             // fungiert als Bremse
38
39            if (i <= j) {
40                tmp = a[i];
41                a[i] = a[j];
42                a[j] = tmp;
43                i++;
44                j--;
45            }
46        } while (i <= j);
47        // alle Elemente der linken Array-Hälfte sind kleiner
48        // oder gleich allen Elementen der rechten Array-Hälfte
49        if (lftIndex < j) quicksort(a, lftIndex, j);
50        if (i < rgtIndex) quicksort(a, i, rgtIndex);
51    }
52}
Listing 7.5: QuickSort.java
Anmerkung: Mathematisch ideal wäre der Median als Pivot-Element. Den zu bestimmen ist in einem unsortierten Array nicht möglich. Optimierte QuickSort-Implementierungen versuchen daher zumindest eine Näherung an diesen Wert zu ermitteln. Der Grund für diesen Aufwand ist leicht aufzuzeigen. Ist die zu sortierende Datensequenz so aufgebaut, dass das gewählte Pivot-Element immer das kleinste oder größte Datenelement ist, verringert sich das ursprüngliche Problem immer nur um jeweils 1. Dann entartet der QuickSort zu einem $\mathcal{O}(n^2)$-Algorithmus. - In der Praxis ist das aber sehr unwahrscheinlich.
In der Analyse erfahren Sie, welches Laufzeitverhalten QuickSort hat.
Übung:
Betrachten Sie derweil die schematische Darstellung. Bei sieben Datenelementen werden in der Darstellung vier Durchläufe benötigt.
Frage: Können Sie daraus bereits eine Vermutung über das Laufzeitverhalten äußern?
Test
Führen Sie eigene Tests durch, notieren Sie Ihre Beobachtungen und versuchen Sie sie zu erklären. - Den QuickSort dürfen Sie, wie auch den MergeSort, gerne auch mit Arrays von einer Million und mehr Daten beauftragen.
Analyse
Die Analyse der Laufzeit von Quicksort stützt sich auf folgende Rekursionsungleichung für die Anzahl der Schritte $f(n)$ bei $n$ zu sortierenden Daten im günstigsten Fall (Partitionen immer gleich groß):
$$ f(n) \leq \left\{ \begin{array}{lcl} c_1 & , & n = 1 \\ c_2 \cdot n + 2 \cdot f(\frac{n}{2}) & , & n \in \mathbb{N}: n > 1 \\ \end{array} \right. $$Daraus ergibt sich $f \in \mathcal{O}(n \cdot log_2(n))$. Diese Komplexität gilt auch für den durchschnittlichen Fall; es lässt sich zeigen, dass die Zahl der Schritte nur um den konstanten Faktor $1.4$ wächst.
Im ungünstigsten Fall (bei entarteten Partitionen) gilt $f \in \mathcal{O}(n^2)$.
Anmerkung: QuickSort ist nicht stabil und arbeitet in place. Er benötigt dennoch zusätzlichen Speicher in der Größenordnung $\mathcal{O}(\log_2(n))$.
Der logarithmische zusätzliche Platzbedarf beim Quicksort-Algorithmus wird verursacht durch das Zwischenspeichern der Intervallgrenzen für die noch zu sortierenden Array-Abschnitte, die jeweils nach dem Aufteilen anhand des Pivot-Elements entstehen.
HeapSort
Ein binärer Baum ist entweder leer oder besteht aus einem Knoten, dem zwei binäre Bäume zugeordnet sind. Dieser heißt dann Vater des linken beziehungsweise rechten Teilbaums. Ein Knoten ohne Vater heißt Wurzel. Die Knoten, die $x$ zum Vater haben, sind seine Söhne. Knoten ohne Söhne heißen Blätter.
Ebene $0 =$ Wurzel, Ebene $i + 1 =$ Söhne von Ebene $i$.
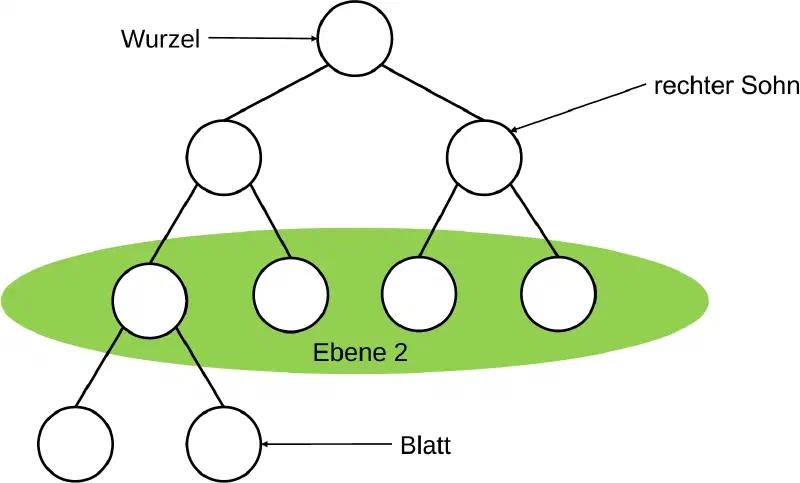
Ein Heap ist ein binärer Baum mit $h$ Ebenen, in dem die Ebenen $0, 1, \dots , h-2$ vollständig besetzt sind; die letzte Ebene $h-1$ ist von links beginnend bis zum so genannten letzten Knoten vollständig besetzt. Die Knoten enthalten Schlüssel. Der Schlüssel eines Knotens ist größer oder gleich den Schlüsseln seiner Söhne (MaxHeap).
Anmerkung: Für eine absteigende Sortierung ist der Knoten des Vaters kleiner oder gleich den Schlüsseln seiner Söhne (MinHeap).
Betrachten wir das Ganze an einem Beispiel. Zu sortieren sei $a = {2, 9, 5, 8, 1, 7, 3, 6, 4}$. Zu Beginn sieht unser Array, als Baum interpretiert, wie folgt aus, wenn wir die Werte der Reihe nach einlesen.
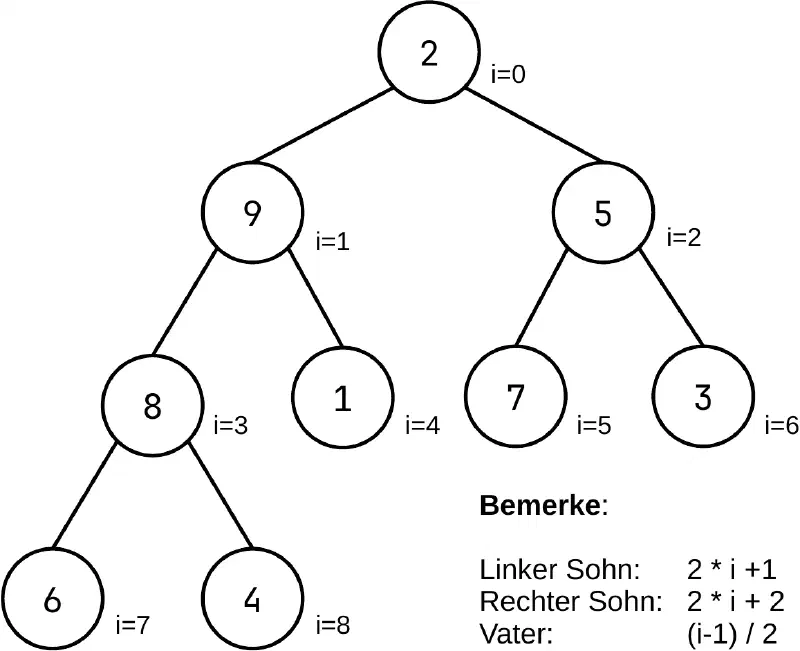
Dann können wir anfangen den Heap zu konstruieren und zu sortieren, sprich die Knoten umzuordnen. Geprüft wird von den Blättern beginnend in Richtung Wurzel.
- Ist ein Sohn größer als sein Vater, tauschen die beiden Ihre Positionen.
- Sind beide Söhne größer als ihr Vater, so übernimmt der größere die Position des Vaters, der seinerseits die Position des tauschenden Sohne einnimmt.
So arbeiten wir uns durch den Baum. Das vorläufige Ende ist erreicht, wenn auf diese Weise der größte Wert die Wurzelposition eingenommen hat.
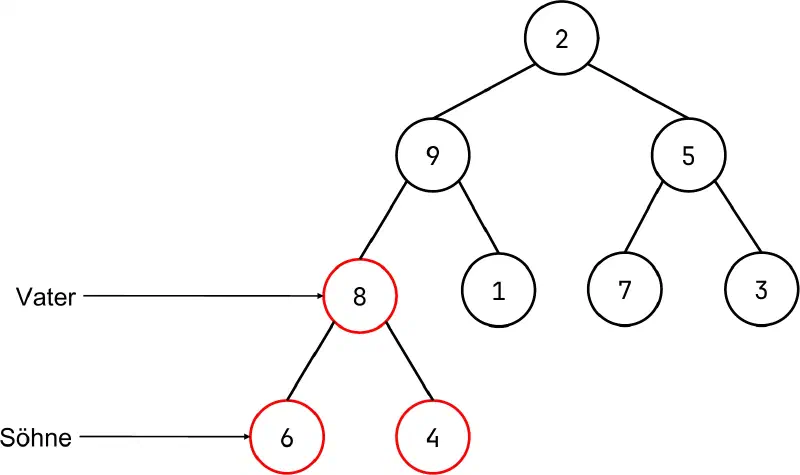
Wir beginnen beim letzten Blatt. Annahme: Darunter besteht ein valider Heap. Zwischen den Knoten 4, 6 und 8 ist die Ordnung korrekt.
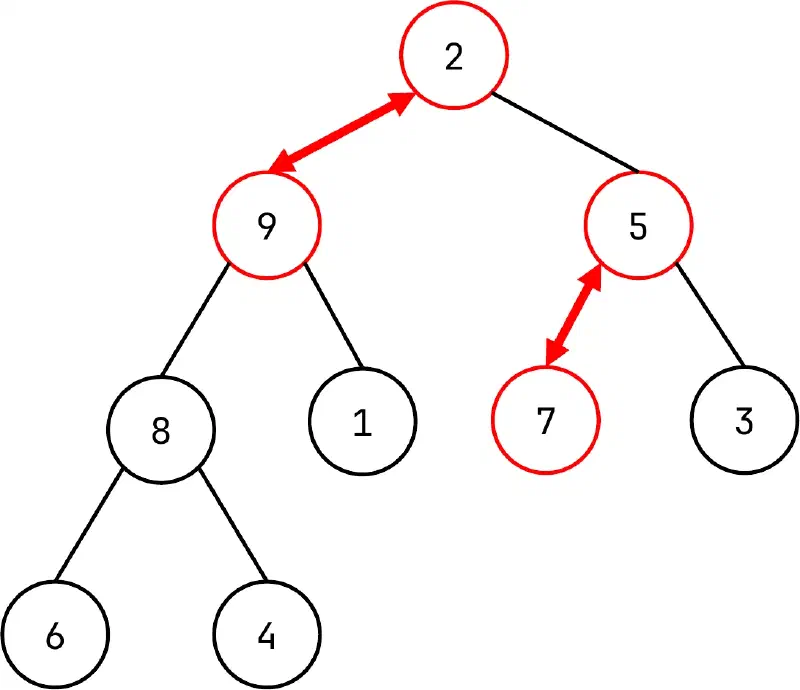
Nicht so jedoch bei Knoten 5. Der tauscht mit der 7. Selbiges gilt dann für die 2 und die 9. Unser Array hat dann die folgende Gestalt: $a = {9, 2, 7, 8, 1, 5, 3, 6, 4}$
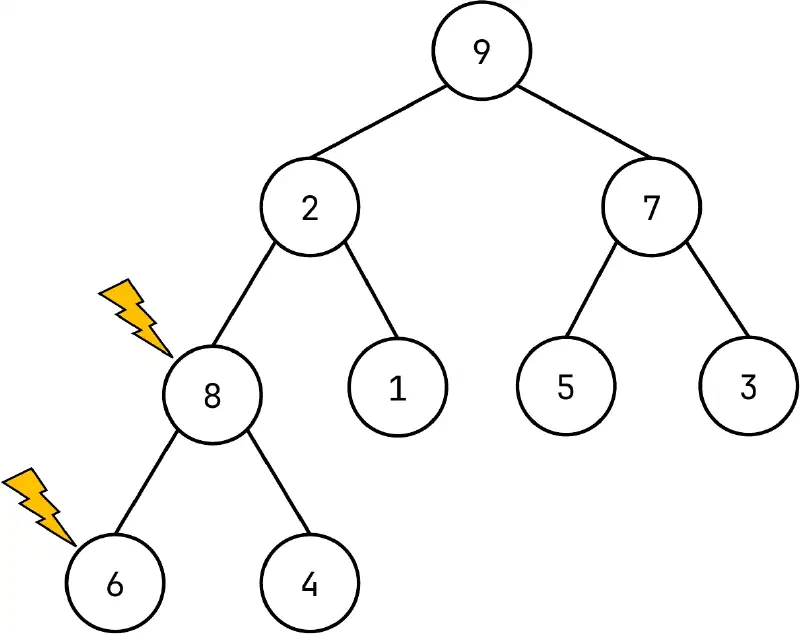
Jetzt sind aber die Bedingungen im unteren Teil des Baumes verletzt. Wir müssen sie uns nochmals ansehen.
Es geht den Baum abwärts. Die 2 tauscht mit der 8. Da hierdurch die 2 zum Vater von 4 und 6 wird, tauscht die 2 mit der 6, dem größeren Sohn.
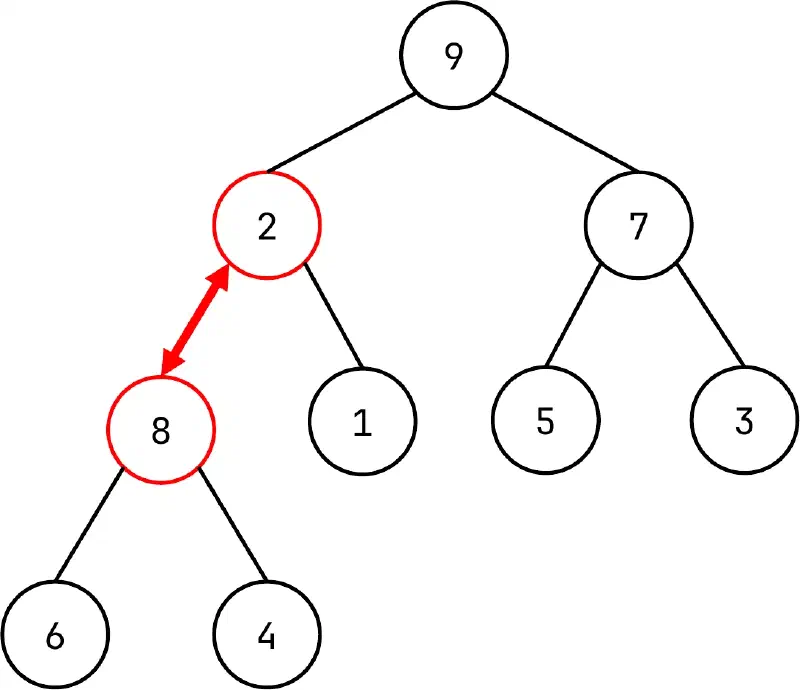
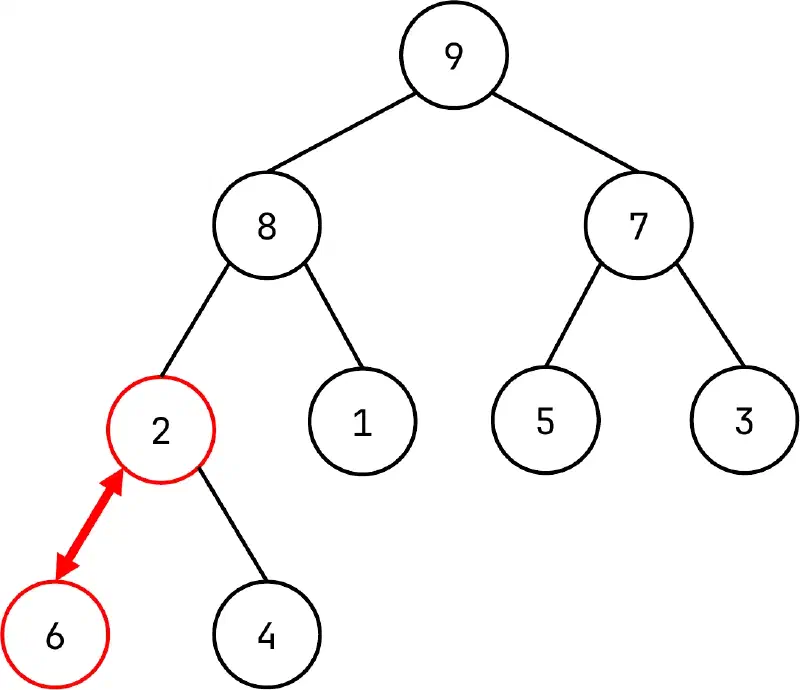
Jetzt ist der Baum den Regeln entsprechend aufgebaut.
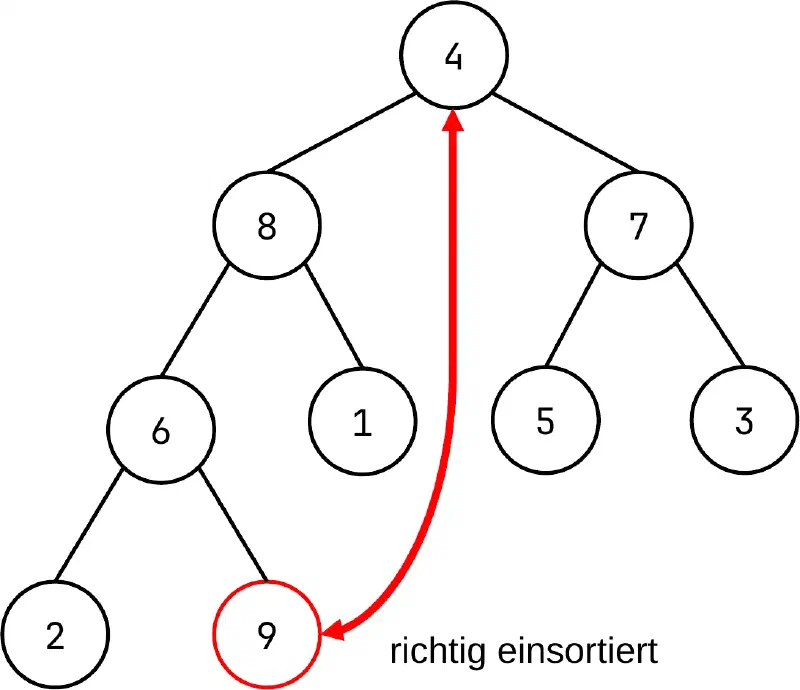
Wir tauschen nun die Wurzel mit dem letzten Blatt, also 4 und 9. Damit können wir die 9 aus dem Baum „entfernen". Das Array ist bis dahin, vom rechten Rand aus betrachtet, aufsteigend sortiert. In den folgenden Schritten wird nur noch der links verbleibende Rest des Arrays betrachtet und bearbeitet.
Das Array hat bis hierhin folgende Modifikationen durchgemacht:
Ausgangssituation: 2, 9, 5, 8, 1, 7, 3, 6, 4
Heap organisieren: 9, 2, 7, 8, 1, 5, 3, 6, 4
                   9, 8, 7, 2, 1, 5, 3, 6, 4
                   9, 8, 7, 6, 1, 5, 3, 2, 4
                   4, 8, 5, 6, 1, 7, 3, 2, 9 -> die 9 ist fertig

                   // jetzt wird nur noch der Rest betrachtet
                   4, 8, 5, 6, 1, 7, 3, 2
                   ...
 1/** Sortierung eines {@code int}-Arrays mit HeapSort */
 2public class HeapSort {
 3
 4    /**
 5     * Sortiert ein {@code int}-Array {@code a} mithilfe des
 6     * HeapSort-Algorithmus.
 7     *
 8     * @param a zu sortierendes Array (int)
 9     */
10    public static void sort(int[] a) {
11        buildMaxHeap(a);   // baue initialen Heap auf
12        // Sortierung:
13        for (int i = a.length - 1; i > 0; i--) {
14            swap(a, i, 0);
15            sift(a, 0, i);
16        }
17    }
18
19    // erstelle im Array einen MaxHeap Baum
20    private static void buildMaxHeap(int[] a) {
21        for (int i = (a.length / 2) - 1 ; i >= 0; i--)
22            sift(a, i, a.length);
23    }
24
25    // Wenn einer der Söhne größer als der Vater ist,
26    // dann größeren Sohn nach oben ziehen, Vater sinkt ab
27    private static void sift(int[] a, int i, int j) {
28        while (i <= (j / 2) - 1) {
29            // linkes Kind
30            int childIndex = ((i + 1) * 2) - 1;
31            // rechtes Kind
32            if (childIndex + 1 <= j - 1) {
33                if (a[childIndex] < a[childIndex + 1]) {
34                    childIndex++;
35                }
36            }
37
38            // Test, ob weiteres versickern notwendig ist
39            if (a[i] < a[childIndex]) {
40                swap(a, i, childIndex);
41                i = childIndex;
42            } else break;
43        }
44    }
45
46    // tauschen
47    private static void swap(int[] a, int i, int childIndex) {
48        int tmp = a[i];
49        a[i] = a[childIndex];
50        a[childIndex] = tmp;
51    }
52}
Listing 7.6: HeapSort.java
Test
Führen Sie eigene Tests durch, notieren Sie Ihre Beobachtungen und versuchen Sie sie zu erklären.
Auch den HeapSort dürfen Sie mit großen Datenmengen betrauen.
Analyse
Es ist kaum zu glauben, auf diese Weise sortieren zu können. Fast noch unglaublicher ist, dass der Algorithmus trotz der komplizierten Vertauschungen schnell ist. Tatsächlich fällt er in die Klasse $\mathcal{O}(n\cdot log_2(n))$. Die stringente Baumstruktur begründet den Faktor $\log_2(n)$.
Der HeapSort hat den Charme, keinen zusätzlichen Speicherplatz zu benötigen!
Die Knoten sind wie folgt nummeriert: Die Wurzel hat den Index $0$, der linke Sohn von Knoten $i$ hat den Index $(2 \cdot i + 1)$ und der rechte Sohn von Knoten $i$ den Index $(2 \cdot i + 2)$. Der Vater ist dann jeweils $(i-1)/2$ (ganzzahlig). - Zeichnen Sie sich den HeapSort als Baum auf, dann ist er leichter zu verstehen. Allein das Array zu betrachten, ist eher verwirrend.
Der HeapSort ist nicht stabil. Die relative Ordnung gleicher Elemente kann sich ändern.
Zusammenfassung und Vergleich der Sortieralgorithmen
Es gibt noch deutlich mehr Sortieralgorithmen, als hier behandelt. Dennoch sollten Sie mit den besprochenen Algorithmen in der Lage sein, andere Sortieralgorithmen einigermaßen einschätzen zu können.
Tabelle 7.1: Vergleich wichtiger Sortieralgorithmen
| Algorithmus | Best | Average | Worst | zus. Speicher |
|---|---|---|---|---|
| SelectionSort | $\mathcal{O}(n^2)$ | $\mathcal{O}(n^2)$ | $\mathcal{O}(n^2)$ | $\mathcal{O}(1)$ |
| BubbleSort | $\mathcal{O}(n)$ | $\mathcal{O}(n^2)$ | $\mathcal{O}(n^2)$ | $\mathcal{O}(1)$ |
| MergeSort | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n)$ |
| QuickSort | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n^2)$ | $\mathcal{O}(\log_2(n))$ |
| HeapSort | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(n\cdot\log_2(n))$ | $\mathcal{O}(1)$ |
Integrierte Sortiermethoden in Java
Arrays.sort(): Für Arrays; sortiert primitive Typen (wieint[]) und Objekte (z.B.String[]).Collections.sort(): Für List-Implementierungen (wieArrayList).List.sort(): In Java 8 eingeführt, sortiert Listen direkt.
Java verwendet intern für primitive Datentypen und Objekte in Arrays.sort() und auch in Collections.sort() einen optimierten Algorithmus, der je nach Version und Typ eine Mischung aus TimSort (eine Hybrid-Sortierung aus MergeSort und InsertionSort) für Objekte und Dual-Pivot QuickSort für primitive Datentypen ist, um hohe Effizienz zu gewährleisten.
Alle am Markt verfügbaren Programmiersprachen bringen entsprechende Bibliotheken mit stark optimierten Sortieralgorithmen mit. Sie brauchen also in der Praxis keine Sortieralgorithmen zu implementieren, egal mit welcher Programmiersprache Sie arbeiten.
Es lässt sich übrigens mathematisch nachweisen, das ein schnelleres Sortieren beim Sortieren mit Vergleichen als $\mathcal{O}(n \cdot \log_2(n))$ nicht möglich ist. Es gibt aber, das will ich hier nicht verschweigen, auch Sortieralgorithmen, die ohne Vergleichen auskommen (Beispiel: BucketSort).