Bisher haben wir konkrete Klassen modelliert, wie Date, Person oder Student. Dabei haben Sie gelernt, dass wir mithilfe der OOP, im Gegensatz zu Arrays, Strukturen modellieren, die nicht nur aus einem Datentypen bestehen, wie beispielsweise ein Array von ganzen Zahlen. Mithilfe von Klassen können wir Dinge modellieren, die verschiedene Datentypen in einer Struktur zusammenfassen. So haben wir Vorname, Nachname und Geburtsdatum als beschreibende Attribute in der Klasse Person zusammengefasst. Dabei können wir nicht nur auf primitive Datentypen zurückgreifen, wir können sämtliche in Java verfügbaren Datentypen nutzen, um den Gegenstand unseres Interesses zu modellieren. Insbesondere können wir dazu auch Klassen nutzen, die wir selbst implementiert haben, wie Date in Person. Auf diese Weise gelingt es uns, Beziehungen zwischen Objekten auszudrücken.
Nun wenden wir uns der Frage zu, welche Eigenschaften und Operationen eine Datenstruktur haben muss, unabhängig von ihrer internen Implementierung.
Ein abstrakter Datentyp (ADT) ist eine Datenstruktur zusammen mit darauf definierten Operationen.
Java unterstützt den Umgang mit ADTs durch die Bereitstellung von Klassen und Interfaces.
Interfaces enthalten nur Methodenköpfe und Konstanten. Ein Interface stellt eine Schnittstelle dar und legt damit die Funktionalität seiner Methoden fest, ohne diese zu implementieren. Dies geschieht in einer beliebigen Klasse, die dies zuerst in einer implements-Klausel deklariert und die dann eine Implementation aller Methoden des Interface bereitstellen muss.
Die implements-Klausel etabliert damit quasi einen Vertrag zwischen einem Interface und der Klasse, die verspricht, dieses Interface zu implementieren. Der Nutzer einer Klasse darf dann darauf vertrauen, dass die Klasse diesen Vertrag einhält und sich der Methoden, die das Interface deklariert, bedienen.
Verwendet werden kann ein Interface als Typdeklaration auch ohne Kenntnis der konkreten Implementierung.
Wir betrachten die Datenstrukturen Liste (List), Schlange (Queue), Kellerspeicher (Stack) und Baum (Tree).
Diese Datenstrukturen deklarieren jeweils eine Menge von Operationen, die für den Gebrauch der jeweiligen Datenstruktur typisch sind. Diese Operationen deklarieren wir in Form von Interfaces. Verschiedene Klassen stellen dann konkrete Implementierungen dieser Interfaces dar.
Die Auswahl der Datenstrukturen spiegelt grundsätzliche Strukturen wider, die in der Informatik eine zentrale Rolle spielen. Anhand von Beispielanwendungen werden wir uns verschiedene Einsatzzwecke ansehen und implementieren.
List
Definition: Eine Liste (engl. List) ist eine (ggf. leere) Folge von Elementen zusammen mit einem (ggf. undefinierten) aktuellen Element.
Schnittstelle des ADT List
Tabelle 10.1 Listen-Schnittstelle
Methode
Objekte
Ergebnis
Beschreibung
empty()
:
Liste
→
boolean
true, wenn Liste leer
endpos()
:
Liste
→
boolean
true, wenn Liste abgearbeitet
reset()
:
Liste
→
Liste
erstes Listenelement wird aktuelles
forward()
:
Liste
→
Liste
nächstes Listenelement wird aktuelles
content()
:
Liste
→
Objekt
liefert Inhalt des aktuellen Elements
insert()
:
Liste $\times$ Objekt
→
Liste
fügt neues Element vor aktuellem ein
delete()
:
Liste
→
Liste
löscht das aktuelle Element
Die Ankündigung einer Schnittstelle verwendet das Schlüsselwort interface. Das Interface definiert eine generische Liste. Die Liste kann grundsätzlich Elemente beliebigen Datentyps beinhalten. Jedoch soll der Datentyp festgelegt und vom Compiler geprüft werden können. <T> ist der Platzhalter für einen beliebigen Datentypen.
Bezüglich der Methoden, die von einer späteren Implementierung erwartet werden, werden lediglich die Methodenköpfe notiert.
1packageadt;
2 3/**
4 * Interface für den generischen ADT {@code List}.
5 *
6 * @param <T> Datentyp
7 */ 8publicinterfaceList<T> {
910/**
11 * Prüfung, ob Liste leer.
12 *
13 * @return {@code true}, wenn Liste leer, sonst {@code false}
14 */15publicbooleanempty();
1617/**
18 * Prüfung, ob Liste am Ende.
19 *
20 * @return {@code true}, wenn Liste am Ende, sonst {@code false}
21 */22publicbooleanendpos();
2324/**
25 * An den Anfang der Liste rücken.
26 */27publicvoidreset();
2829/**
30 * Eine Position in der Liste weiter rücken.
31 */32publicvoidforward();
3334/**
35 * Objekt des aktuellen Listenelements liefern.
36 *
37 * @return Objekt
38 */39publicTcontent();
4041/**
42 * Objekt vor dem aktuellen Listenelement einfügen.
43 * Eingefügtes Element wird aktuelles Listenelement.
44 *
45 * @param obj Objekt
46 */47publicvoidinsert(Tobj);
4849/**
50 * Aktuelles Element aus Liste entfernen.
51 */52publicvoiddelete();
53}
Listing 10.1: adt.List.java
Konzept zur Implementierung einer einfach verketteten Liste
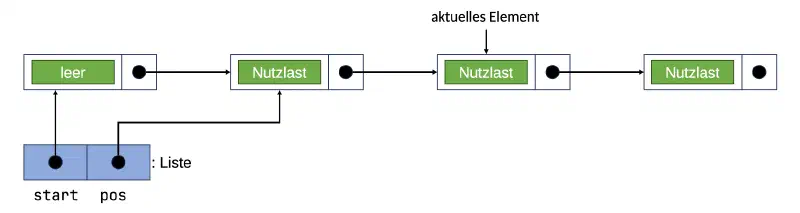
Bei einer einfach verketteten Liste besitzt ein Element eine Nutzlast, einen Wert beliebigen Datentyps, und einen Verweis auf das nächste Listenelement der Liste. Der Verweis des letzten Listenelements ist null.
Die Verwaltungsstruktur der einfach verketteten Liste hat zwei Attribute. Das sind eine Referenz auf den Listenanfang und das Element, welches vor dem aktuellen Element steht. – Es gibt hiervon abweichende Implementierungen.
Abbildung 10.1: Konzept der einfach verketteten Liste
Der Nutzer einer Liste braucht von diesen internen Implementierungsdetails nichts zu wissen. Wir implementieren den Datentyp des erforderlichen Listenelements daher als innere Klasse von SingleLinkedList. Das ist die Listenimplementierung, die wir hier realisieren wollen.
1packageadt;
2 3/**
4 * {@code SingleLinkedList} implementiert eine einfach verkettete
5 * generische Liste ({@link List}).
6 *
7 * @param <T> Datentyp
8 */ 9publicclassSingleLinkedList<T>implementsList<T> {
10 11privateclassElement {
12privateTcontent;
13privateElementnext;
14 }
15 16privatefinalElementstart; // Zeiger auf Listenanfang 17privateElementpos; // Zeiger auf aktuellen Listeneintrag 18 19/** Konstruktor für eine leere Liste. */ 20publicSingleLinkedList() {
21pos=start=newElement();
22start.next=null;
23 }
24 25 26/**
27 * Prüfung, ob Liste leer.
28 *
29 * @return {@code true}, wenn Liste leer, sonst {@code false}
30 */ 31@Override 32publicbooleanempty() {
33returnstart.next==null;
34 }
35 36 37/**
38 * Prüfung, ob Liste am Ende.
39 *
40 * @return {@code true}, wenn Liste am Ende, sonst {@code false}
41 */ 42@Override 43publicbooleanendpos() { returnpos.next==null; }
44 45 46/**
47 * An den Anfang der Liste rücken.
48 */ 49@Override 50publicvoidreset() { pos=start; }
51 52 53/**
54 * Eine Position in der Liste weiter rücken.
55 *
56 * @throws RuntimeException Ende der Liste
57 */ 58@Override 59publicvoidforward() {
60if (endpos())
61thrownewRuntimeException("Ende der Liste.");
62pos=pos.next;
63 }
64 65 66/**
67 * Objekt des aktuellen Listenelements liefern.
68 *
69 * @throws RuntimeException Ende der Liste
70 * @return Objekt
71 */ 72@Override 73publicTcontent() {
74if (endpos())
75thrownewRuntimeException("Ende der Liste.");
76returnpos.next.content;
77 }
78 79 80/**
81 * Objekt vor dem aktuellen Listenelement einfügen.
82 * Eingefügtes Element wird aktuelles Listenelement.
83 *
84 * @param obj Objekt
85 */ 86@Override 87publicvoidinsert(Tobj) {
88Elementtmp=newElement();
89tmp.content=obj;
90tmp.next=pos.next;
91pos.next=tmp;
92 }
93 94 95/**
96 * Aktuelles Element aus Liste entfernen.
97 *
98 * @throws RuntimeException Ende der Liste
99 */100@Override101publicvoiddelete() {
102if (endpos())
103thrownewRuntimeException("Ende der Liste.");
104pos.next=pos.next.next;
105 }
106107108/**
109 * Ausgabe der Liste als Zeichenkette.
110 * <p>
111 * <i>Anmerkung</i>: einfacher Nachbau von
112 * {@link java.util.Arrays#toString(Object[])}
113 *
114 * @return Zeichenkettendarstellung der Liste
115 */116@Override117publicStringtoString() {
118StringBuilders=newStringBuilder();
119Elementindex=start;
120s.append('[');
121while (index.next!=null) {
122s=s.append(index.next.content);
123s=s.append(", ");
124index=index.next;
125 }
126s.deleteCharAt(s.length() -1); // letztes Leerzeichen löschen127s.deleteCharAt(s.length() -1); // letztes Komma löschen128s.append(']');
129returns.toString();
130 }
131}
Listing 10.2: adt.SingleLinkedList.java
Die Liste kann sich selbst darstellen. Das ist keine Standardfunktionalität einer Liste, weshalb sie auch nicht im Listen-Interface aufgeführt ist.
1importadt.List;
2importadt.SingleLinkedList;
3importde.pakad.udemy.StdOut;
4importoop.Date;
5importoop.Student;
6 7/**
8 * Testclient für die Klasse {@link adt.SingleLinkedList}.
9 */10publicclassSingleLinkedListTest {
1112/**
13 * Hauptprogramm.
14 *
15 * @param args nicht genutzt
16 */17publicstaticvoidmain(String[]args) {
1819Students; // Student20List<Student>l=newSingleLinkedList<>(); // Studentenliste2122// neuen Studenten erzeugen und am Listenende anfügen23s=newStudent("Wilhelm", "Wulf", newDate(13, 10, 2006),
24"BWL");
25l.insert(s); l.forward();
2627// neuen Studenten erzeugen und am Listenende anfügen28s=newStudent("Sabine", "Kittler", newDate(3, 4, 2006),
29"BWL");
30l.insert(s); l.forward();
3132// neuen Studenten erzeugen und am Listenende anfügen33s=newStudent("Wolfgang", "Bauer", newDate(2, 1, 2005),
34"Informatik");
35l.insert(s); l.forward();
3637// neuen Studenten erzeugen und am Listenende anfügen38s=newStudent("Viola", "Sauer", newDate(10, 12, 2005),
39"Rechtswissenschaften");
40l.insert(s);
4142StdOut.println(l);
4344// Liste auf Anfang und alle Elemente ausgeben45l.reset();
46while (!l.endpos()) {
47StdOut.println(l.content());
48l.forward();
49 }
5051// Liste auf Anfang und alle Elemente löschen52l.reset();
53while (!l.empty())
54l.delete();
55 }
56}
Listing 10.3: SingleLinkedListTest.java
Üblicherweise deklariert man, um eine Schnittstelle zu nutzen, die Schnittstelle als Datentyp, Zeile 20. Instanziiert wird dann eine konkrete Implementierung, hier SingleLinkedList. Beziehen sich Schnittstelle und konkrete Implementierung auf denselben Datentypen, reicht es, diesen bei der Datentypangabe der Variablen anzugeben.
Stack
Definition: Ein Stack (Keller) ist eine (gegebenenfalls leere) Folge von Elementen zusammen mit einem sogenannten (gegebenenfalls leeren) Top-Element.
Ein Stack arbeitet nach den LIFO-Prinzip (Last In First Out).
Schnittstelle des ADT Stack
Tabelle 10.2 Stack-Schnittstelle
Methode
Objekte
Ergebnis
Beschreibung
empty()
:
Stack
→
boolean
true, wenn Stack leer
push()
:
Stack $\times$ Objekt
→
Stack
legt Element auf Stack
top()
:
Stack
→
Objekt
liefert oberstes Element
pop()
:
Stack
→
Stack
liefert und entfernt oberstes Element
Semantik der Stack-Operationen
Ein neu generierter Stack ist leer.
Nach einer push()-Operation ist ein Stack nicht leer.
Nach einer push()-pop()-Operation ist ein Stack unverändert.
Nach einer push()-Operation mit Element $x$ liefert die top()-Operation $x$.
1packageadt;
2 3/**
4 * Interface für den generischen ADT {@code Stack}.
5 *
6 * @param <T> Datentyp
7 */ 8publicinterfaceStack<T> {
910/**
11 * Prüfung, ob Stack leer.
12 *
13 * @return {@code true}, wenn Stack leer, sonst {@code false}
14 */15booleanempty();
1617/**
18 * Objekt vom Typ {@code T} auf den Stapel legen.
19 *
20 * @param obj Objekt
21 */22voidpush(Tobj);
2324/**
25 * Objekt des obersten Stack-Elements liefern.
26 *
27 * @return Objekt
28 */29Ttop();
3031/**
32 * Liefern und entfernen des obersten Stack-Elements.
33 *
34 * @return Objekt
35 */36Tpop();
37}
Listing 10.4: adt.Stack.java
Konzept zur Implementierung eines Stacks mithilfe von Verweisen
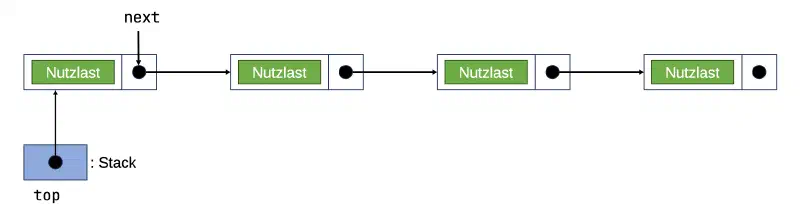
Das Konzept ist dem der einfach verketteten Liste sehr ähnlich. Es ist jedoch insofern einfacher, als das neue Elemente jeweils immer als Top-Element eingefügt werden. Ebenso erfolgt das Lesen und Löschen auch nur beim jeweiligen Top-Element, welches auf dem Stack oben liegt.
Die Verwaltungsstruktur eine Verweis-Stacks kommt mit einem Attribut aus, einem Zeiger auf das Top-Element.
Das Konzept der hier angestrebten Implementierung können wir wie folgt visualisieren:
Abbildung 10.2: Konzept des Verweis-Stacks
1packageadt;
2 3/**
4 * {@code ReferenceStack} implementiert einen generischen
5 * {@link adt.Stack} mithilfe von Verweisen.
6 *
7 * @param <T> Datentyp
8 */ 9publicfinalclassReferenceStack<T>implementsStack<T> {
1011privateclassElement {
12privateTcontent;
13privateElementnext;
14 }
1516privateElementtop; // Zeiger auf Top-Element1718/** Konstruktor für einen leeren Stack. */19publicReferenceStack() {
20top=null;
21 }
222324/**
25 * Prüfung, ob Stack leer.
26 *
27 * @return {@code true}, wenn Stack leer, sonst {@code false}
28 */29@Override30publicbooleanempty() {
31returntop==null;
32 }
333435/**
36 * Objekt vom Typ {@code T} auf den Stapel legen.
37 *
38 * @param obj Objekt
39 */40@Override41publicvoidpush(Tobj) {
42Elementtmp=newElement();
43tmp.content=obj;
44tmp.next=top;
45top=tmp;
46 }
474849/**
50 * Objekt des obersten Stack-Elements liefern.
51 *
52 * @throws RuntimeException Stack ist leer
53 * @return Objekt
54 */55@Override56publicTtop() throwsRuntimeException {
57if (empty())
58thrownewRuntimeException("Stack ist leer.");
59returntop.content;
60 }
616263/**
64 * Liefern und entfernen des obersten Stack-Elements.
65 *
66 * @throws RuntimeException Stack ist leer
67 * @return Objekt
68 */69@Override70publicTpop() throwsRuntimeException {
71if (empty())
72thrownewRuntimeException("Stack ist leer.");
73Tdata=top.content;
74top=top.next;
75returndata;
76 }
77}
Listing 10.5: adt.ReferenceStack.java
Beispielanwendungen für den Gebrauch eines Stacks
Die Formulierung Stack<Integer> im folgenden Beispiel legt nahe, dass zum Speichern von Werten primitiver Datentypen zunächst das Verpacken der Werte mithilfe der bereits erwähnten Wrapper-Klassen erforderlich ist. So würde durch new Integer(i) ein Integer-Objekt erzeugt mit dem (nicht mehr veränderbaren) Wert i. Diese Form gilt allerdings als veraltet. Manche Entwicklungsumgebungen warnen deshalb. Die moderne Variante ruft den Konstruktor nicht direkt auf. Sie lautet: Integer.valueOf(i). Der Wert dieses Objekts kann über die Methode intValue() ermittelt werden.
Tatsächlich kann aber auf diese Umwege verzichtet werden. Java unterstützt seit geraumer Zeit ein automatisches Boxing und Unboxing, sodass wir primitive Datentypen nicht mehr explizit in deren Wrapper-Klassen ver- und entpacken müssen. – Das nutzen wir hier.
Reversierung einer Zahlenfolge mithilfe eines Stacks:
Das pop() den Wert des obersten Stack-Elements liefert, könnten wir top() durch pop() ersetzen und so das Erfragen und Löschen des obersten Stack-Elements in einem Schritt erledigen. Zur Demonstration aller Methoden des Stacks wird das hier jedoch in zwei Schritten vorgenommen.
1importadt.Stack;
2importadt.ReferenceStack;
3importde.pakad.udemy.StdIn;
4importde.pakad.udemy.StdOut;
5 6/**
7 * Ein einfacher Klammer-Prüfer.
8 * <p>
9 * Es wird geprüft, ob runde und/oder eckige Klammern korrekt
10 * paarweise in Programmcodes verwendet werden.
11 * <p>
12 * <strong>Hinweis</strong>: Wenn Klammern in Strings verwendet
13 * werden, zeigt {@code Brackets} einen
14 * Fehler an, wenn dadurch die paarweise
15 * Anordnung der Klammern gestört wird.
16 * Einen Fehler im Code muss das jedoch
17 * nicht bedeuten.
18 */19publicclassBrackets {
2021/**
22 * Hauptprogramm. Die Eingabe wird von der Standardeingabe gelesen.
23 *
24 * @param args nicht genutzt
25 */26publicstaticvoidmain(String[]args) {
27char[]chars;
28booleanerror=false;
29Stack<Character>s=newReferenceStack<>();
3031// komplette Standardeingabe lesen und als Array von32// Zeichen speichern33chars=StdIn.readChars();
34for (charch : chars) { // for-each-Schleife35switch (ch) {
36case'(', '['->s.push(ch);
37case')'-> {
38if (!s.empty() &&s.top() =='(') s.pop();
39elseerror=true;
40 }
41case']'-> {
42if (!s.empty() &&s.top() =='[') s.pop();
43elseerror=true;
44 }
45 }
46 }
47if (!error&&s.empty())
48StdOut.println("Korrekt geklammert.");
49else50StdOut.println("Nicht korrekt geklammert.");
51 }
52}
Listing 10.7: Brackets.java
Das Programm berücksichtigt nicht, dass Klammern im Text oder als konstante Zeichen nicht zwingend korrekt, im Sinne der Java-Syntax, geklammert sein müssen. Auf sich selbst angewendet meldet das Programm daher einen Fehler bezüglich der Klammer-Symbole.
Das folgende Programm liest einen arithmetischen Ausdruck in der üblichen Infix-Notation und wandelt ihn in einen Postfix-Ausdruck um. Computer arbeiten intern damit. D. h., erst kommen die Operanden und darauf folgt die Operation, die für die zwei vorausgegangenen Operanden ausgeführt werden soll. Auf diese Weise, die sich auch „Umgekehrt polnische Notation" nennt, kann man sich Klammern grundsätzlich sparen.
1importadt.ReferenceStack;
2importadt.Stack;
3importde.pakad.udemy.StdIn;
4importde.pakad.udemy.StdOut;
5 6/**
7 * {@code Postfix} konvertiert einen einfachen Infix-Ausdruck nach
8 * Postfix.
9 * <p>
10 * Eine syntaktisch korrekte Eingabe wird vorausgesetzt. Zulässig sind
11 * die Operatoren +, -, * und /. Als Operanden sind ausschließlich die
12 * Kleinbuchstaben a-z zulässig. Ein Ausdruck ist lückenlos einzugeben.
13 */14publicclassPostfix {
1516/**
17 * Hauptprogramm. Der Ausdruck für die Infix2Postfix-Umwandlung
18 * wird interaktiv eingegeben.
19 * <p>
20 * <strong>Achtung</strong>: Eine Eingabeaufforderung erfolgt nicht!
21 * <p>
22 * Das Programm kann in einer Pipe verwendet werden.
23 *
24 * @param args nicht genutzt
25 */26publicstaticvoidmain(String[]args) {
27Stack<Character>s=newReferenceStack<>();
28char[]expression=StdIn.readlnChars();
2930for (charch : expression) {
31switch (ch) {
32case'('->s.push(ch); // auf den Stapel33// Keller bis vor '(' ausgeben und leeren34case')'-> {
35while (s.top() !='(')
36StdOut.print(s.pop());
37s.pop(); // '(' entfernen38 }
39// Keller bis vor die erste öffnende Klammer ausgeben40// und leeren41case'+', '-'-> {
42while (!s.empty() &&s.top() !='(')
43StdOut.print(s.pop());
44s.push(ch); // letztes Zeichen merken45 }
46// solange Keller '*' oder '/' enthält, ausgeben47// und entfernen48case'*', '/'-> {
49if (!s.empty() && (
50s.top() =='*'||s.top() =='/' )
51 )
52StdOut.print(s.pop());
53s.push(ch); // letztes Zeichen merken54 }
55// falls Operand vorliegt, direkt ausgeben56default-> {
57if (ch>='a'&&ch<='z')
58StdOut.print(ch);
59 }
60 }
61 }
62// wenn beim Eingabeende noch Zeichen auf dem Stack liegen, 63// dann ausgeben64while (!s.empty())
65StdOut.print(s.pop());
66 }
67}
Achtung: Fehlerhaft gesetzte Klammern können zu einem Programmabbruch führen.
Queue
Definition: Eine Queue (Schlange) ist eine (gegebenenfalls leere) Folge von Elementen zusammen mit einem sogenannten (gegebenenfalls undefinierten) Front-Element.
Eie Queue arbeitet nach den FIFO-Prinzip (First In First Out).
Schnittstelle des ADT Queue
Tabelle 10.3 Queue-Schnittstelle
Methode
Objekte
Ergebnis
Beschreibung
empty()
:
Schlange
→
boolean
true, wenn Schlange leer
enqueue()
:
Schlange $\times$ Objekt
→
Schlange
fügt Element hinten an
front()
:
Schlange
→
Objekt
liefert vorderstes Element
dequeue()
:
Schlange
→
Schlange
entfernt vorderstes Element
1packageadt;
2 3/**
4 * Interface für den generischen ADT {@code Queue}.
5 *
6 * @param <T> Datentyp
7 */ 8publicinterfaceQueue<T> {
910/**
11 * Prüfung, ob Schlange leer.
12 *
13 * @return {@code true}, wenn Schlange leer, sonst {@code false}
14 */15booleanempty();
1617/**
18 * Anfügen eines Objekts vom Typ {@code T} an das
19 * Ende der Schlange.
20 *
21 * @param obj Wert
22 */23voidenqueue(Tobj);
2425/**
26 * Erstes Element aus der Schlange liefern.
27 *
28 * @return Objekt
29 */30Tfront();
3132/**
33 * Erstes Element aus Schlange liefern und entfernen.
34 *
35 * @return Objekt
36 */37Tdequeue();
38}
Listing 10.9: adt.Queue.java
Konzept zur Implementierung einer Queue mithilfe von Verweisen
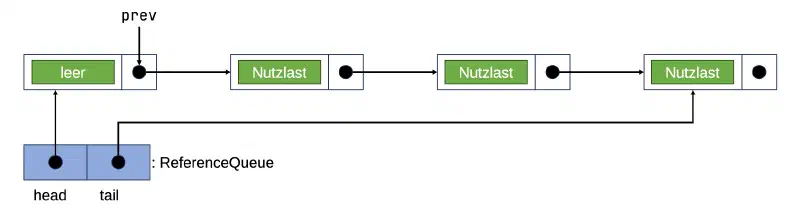
Das Konzept ist dem der einfach verketteten Liste sehr ähnlich. Es ist jedoch insofern einfacher, als das neue Elemente immer am Ende eingefügt werden. Dann erfolgt das Lesen und Löschen erfolgt jeweils am Beginn der verketteten Elemente, die in die Schlange eingereiht sind.
Die Verwaltungsstruktur einer Verweis-Queue benötigt zwei Attribute, einen Zeiger auf Kopf und einen auf das Ende der Schlange.
Das Konzept der hier angestrebten Implementierung können wir wie folgt visualisieren:
Abbildung 10.3: Konzept der Verweis-Queue
1packageadt;
2 3/**
4 * Eine mittels Referenzen implementierte Warteschlange, die das Interface
5 * {@link adt.Queue} implementiert.
6 *
7 * @param <T> Datentyp
8 */ 9publicclassReferenceQueue<T>implementsQueue<T> {
1011privateclassElement {
12privateTcontent;
13privateElementprev;
14 }
1516privateElementhead; // Zeiger auf den Kopf der Schlange17privateElementtail; // Zeiger auf das Ende der Schlange1819/**
20 * Konstruktor für eine leere Queue.
21 */22publicReferenceQueue() {
23head=tail=null;
24 }
252627/**
28 * Prüfung, ob Schlange leer.
29 *
30 * @return {@code true}, wenn Schlange leer, sonst {@code false}
31 */32@Override33publicbooleanempty() {
34returnhead==null;
35 }
363738/**
39 * Anfügen eines Objekts Typ {@code T} an das
40 * Ende der Schlange.
41 *
42 * @param obj Objekt
43 */44@Override45publicvoidenqueue(Tobj) {
46Elementtmp=newElement();
47tmp.content=obj;
48if (empty())
49// wenn Schlange leer, dann Element gleich Kopf-Element50head=tmp;
51else52// sonst hinten anfügen53tail.prev=tmp;
54tail=tmp; // neues Element bildet das Ende der Schlange55 }
565758/**
59 * Erstes Element aus der Schlange liefern.
60 *
61 * @throws RuntimeException Schlange ist leer
62 * @return Objekt
63 */64@Override65publicTfront() throwsRuntimeException {
66if (empty())
67thrownewRuntimeException("Schlange ist leer.");
68returnhead.content;
69 }
707172/**
73 * Erstes Element aus Schlange liefern und entfernen.
74 *
75 * @throws RuntimeException Schlange ist leer
76 * @return Objekt
77 */78@Override79publicTdequeue() throwsRuntimeException {
80if (empty())
81thrownewRuntimeException("Schlange ist leer.");
82Tdata=head.content;
83head=head.prev;
84returndata;
85 }
86}
Listing 10.10: adt.ReferenceQueue.java
1importadt.Queue;
2importadt.ReferenceQueue;
3importde.pakad.udemy.StdOut;
4importoop.Date;
5importoop.Student;
6 7/**
8 * Testclient für {@link adt.ReferenceQueue}.
9 */10publicclassReferenceQueueTest {
11/**
12 * Hauptprogramm.
13 *
14 * @param args nicht genutzt
15 */16publicstaticvoidmain(String[]args) {
1718Students; // Student19// Schlange von Studenten20Queue<Student>q=newReferenceQueue<>();
2122// neuen Studenten erzeugen und am Listenende anfügen23s=newStudent("Wilhelm", "Wulf", newDate(13, 10, 2006),
24"BWL");
25q.enqueue(s);
2627// neuen Studenten erzeugen und am Listenende anfügen28s=newStudent("Sabine", "Kittler", newDate(3, 4, 2006),
29"BWL");
30q.enqueue(s);
3132// neuen Studenten erzeugen und am Listenende anfügen33s=newStudent("Wolfgang", "Bauer", newDate(2, 1, 2005),
34"Informatik");
35q.enqueue(s);
3637// neuen Studenten erzeugen und am Listenende anfügen38s=newStudent("Viola", "Sauer", newDate(10, 12, 2005),
39"Rechtswissenschaften");
40q.enqueue(s);
41StdOut.println(q.dequeue());
4243// restliche Schlange ausgeben und Elemente löschen44while (!q.empty()) {
45StdOut.println(q.dequeue()); // lesen/löschen 46 }
47 }
48}
Listing 10.11: ReferenceQueueTest.java
Konzept zur Implementierung eines Ringpuffers
Ein Ringpuffer (engl. Ringbuffer) stellt eine spezielle Art von Warteschlange dar, die gewöhnlich nur eine begrenzte Kapazität zur Verfügung stellt, wie beispielsweise der Pufferspeicher unserer Tastatur.
Weil ein RingBuffer eine Queue ist, implementiert er das Interface Queue. Ich verwende hier intern, um die eingereihten Elemente zu speichern ein Array. Das dabei genutzte Prinzip, einen Ring zu modellieren, kennen Sie bereits aus der Implementierung des Abzählreims Josephus.java (Kreisaufstellung der Kinder), Seite .
1packageadt;
2 3/**
4 * Implementierung einer {@link adt.Queue} als {@code RingBuffer}, einem
5 * Ring-Speicher.
6 *
7 * @param <T> Datentyp der zu speichernden Elemente
8 */ 9publicclassRingBuffer<T>implementsQueue<T> {
1011privatefinalObject[]data; // T[] ist in Java nicht erlaubt12privatefinalintcapacity;
13privateintcount;
14privateinthead;
1516/**
17 * Konstruktor für einen {@code RingBuffer}. Die Kapazität
18 * muss mindestens 10 betragen. Sie ist, nachdem der Puffer
19 * erstellt wurde, fix.
20 *
21 * @throws RuntimeException Kapazität kleine als 10
22 * @param capacity Anzahl der zu speichernden Elemente
23 */24publicRingBuffer(intcapacity) throwsRuntimeException {
25if (capacity<10)
26thrownewRuntimeException("Mindestkapazität ist 10.");
27this.capacity=capacity;
28this.data=newObject[capacity];
29this.head=0;
30this.count=0;
31 }
323334/**
35 * Prüfung, ob Puffer leer.
36 *
37 * @return {@code true}, wenn Puffer leer, sonst {@code false}
38 */39@Override40publicbooleanempty() {
41returncount==0;
42 }
434445/**
46 * Anfügen eines Objekts vom Typ {@code T} an das
47 * Ende des Puffers.
48 *
49 * @throws RuntimeException Puffer ist voll
50 * @param obj Objekt
51 */52@Override53publicvoidenqueue(Tobj) throwsRuntimeException {
54if (count==capacity)
55thrownewIndexOutOfBoundsException("RingBuffer ist voll.");
56data[(head+count) %capacity]=obj;
57count++;
58 }
596061/**
62 * Erstes Element aus dem Puffer liefern.
63 *
64 * @throws RuntimeException Puffer ist leer
65 * @return Objekt
66 */67@Override68publicTfront() throwsRuntimeException {
69if (empty())
70thrownewIndexOutOfBoundsException("RingBuffer ist leer.");
71@SuppressWarnings("unchecked")
72Tvalue= (T)data[head];
73returnvalue;
74 }
757677/**
78 * Erstes Element aus Puffer liefern und entfernen.
79 *
80 * @throws RuntimeException Puffer ist leer
81 * @return Objekt
82 */83@Override84publicTdequeue() throwsRuntimeException {
85if (empty())
86thrownewIndexOutOfBoundsException("RingBuffer ist leer.");
87@SuppressWarnings("unchecked")
88Tvalue= (T)data[head];
89data[head]=null; // Referenz zu alten Objekten lösen90head= (head+1) %capacity;
91count--;
92returnvalue;
93 }
94}
Listing 10.12: adt.RingBuffer.java
Der Testclient zeigt die Anwendung eines Ringpuffers.
Konzept zur Implementierung einer Prioritätswarteschlange
Eine Prioritätswarteschlange (engl. Priority Queue) ist eine weitere spezielle Art vom Datentyp Queue. Bei Ihr steht nicht die Reihenfolge des Einreihens im Vordergrund. Eine Prioritätswarteschlange liefert als nächstes Element stets das Element mit der höchsten Priorität. Das bedeutet, wir müssen beim Einreihen eines neuen Elements darauf achten, das Element mit der höchsten Priorität am Kopf der Schlange zu positionieren.
Wir unterscheiden Min- und Max-Prioritätswarteschlangen. Bei einer Min-Prioritätswarteschlange hat das Element mit dem kleinsten Wert die höchste Priorität. Bei Max-Warteschlangen ist es genau umgekehrt.
Das soeben Gesagte impliziert die Notwendigkeit, die verschiedenen Elemente ordnen zu können. Dazu müssen sie vergleichbar sein. Unsere Prioritätswarteschlange akzeptiert daher ausschließlich Objekte, die dieser Anforderung direkt oder indirekt (über Vererbung) genügen.
Eine sehr einfache Art und Weise, Objekte vergleichbar zu machen, ist es, das Interface Comparable zu implementieren. Alle Objekte, die dieses Interface implementieren sind vergleichbar.
Als Beispiel betrachten wir eine Klasse PrintJobs. Diese dient ausschließlich zu Demonstrationszwecken. In einer Helpdesk-Anwendung werden Druckaufträge verwaltet. Jeder Druckauftrag erhält eine Priorität und wird in eine Warteschlange eingefügt. Dabei steht 0 für die höchste Priorität.
Das Interface Comparable verlangt danach, eine Methode compareTo() zu implementieren. Ist die eigene Instanz anhand des Vergleichskriteriums kleiner als das Vergleichsobjekt, liefert die Methode einen negativen Rückgabewert. Bei Gleichheit wird 0 zurückgegeben, andernfalls ein positiver Wert.
Die Klasse PrintJob, rudimentär implementiert, implementiert das Interface Comparable in der oben erläuterten Art und Weise. Druckjobs können anhand ihrer jeweiligen Priorität verglichen werden. Wir können Sie in der folgenden Prioritätswarteschlange verwalten.
1packageadt;
2 3/**
4 * {@code ListPriorityQueue} implementiert eine generische
5 * Prioritätswarteschlange auf Basis einer einfach verketteten
6 * Liste (@link adt.SingleLinkedList).
7 *
8 * Das Element mit dem niedrigsten Wert hat die höchste Priorität.
9 * Haben zwei Elemente die gleiche Priorität, dann wird das zuerst
10 * eingestellte Element auch zuerst zurückgeliefert.
11 *
12 * @param <T> Datentyp
13 */ 14publicclassListPriorityQueue<TextendsComparable<?superT>> 15implementsQueue<T> {
16 17privatefinalSingleLinkedList<T>list=newSingleLinkedList<>();
18privateintsize=0;
19 20 21/**
22 * Prüfung, ob Schlange leer.
23 *
24 * @return {@code true}, wenn Schlange leer, sonst {@code false}
25 */ 26@Override 27publicbooleanempty() { returnsize==0; }
28 29 30/**
31 * Rückgabe der Größe (Anzahl möglicher Elemente) der Queue.
32 *
33 * @return Größe
34 */ 35publicintgetSize() { returnsize; }
36 37 38/**
39 * Einfügen eines Objekts {@code obj} vom Typ {@code T} in die
40 * Schlange.
41 *
42 * Hohe Priorität (kleiner Wert) wird vorn eingefügt. Bei gleicher
43 * Priorität entscheidet die Einfügereihenfolge.
44 *
45 * @param obj Objekt
46 */ 47@Override 48publicvoidenqueue(Tobj) {
49// Position vor dem ersten Element 50list.reset();
51 52// Wir suchen die erste Stelle, wo element "höher priorisiert" 53// ist (kleiner = höhere Priorität): element < aktuelles 54// -> davor einfügen 55while (!list.endpos()) {
56Tcurrent=list.content();
57if (obj.compareTo(current) <0) {
58break;
59 }
60list.forward();
61 }
62list.insert(obj);
63size++;
64 }
65 66 67/**
68 * Erstes Element aus der Schlange liefern.
69 *
70 * @return Objekt
71 */ 72@Override 73publicTfront() {
74if (empty()) {
75thrownewIllegalStateException("Queue ist leer.");
76 }
77list.reset();
78returnlist.content();
79 }
80 81 82/**
83 * Erstes Element aus Schlange liefern und entfernen.
84 *
85 * @return Objekt
86 */ 87@Override 88publicTdequeue() {
89if (empty()) {
90thrownewIllegalStateException("Queue ist leer.");
91 }
92list.reset();
93Tfirst=list.content(); // erstes Element 94list.delete(); // erstes Element löschen 95size--;
96returnfirst;
97 }
98 99100/**
101 * Liefert eine Zeichenkettendarstellung der Schlange
102 * mit den darin enthaltenen Elementen.
103 *
104 * @return Zeichenkettendarstellung
105 */106@Override107publicStringtoString() { returnlist.toString(); }
108}
Listing 10.15: adt.ListPriorityQueue.java
Die Beispielanwendung zeigt, wie Aufträge in die Warteschlange eingereiht und in welche Reihenfolge sie wieder ausgegeben werden, geordnet nach ihren jeweiligen Prioritäten. Bei Aufträgen gleicher Priorität wird der zuerst eingereihte Auftrag auch zuerst ausgegeben.
Die verschiedenen Beispiele haben unterschiedlichste Schlangen implementiert. Hierbei haben Sie gelernt, wie mächtig und flexibel das Konzept der Interfaces in Java ist. Alle drei vorgestellen ADTs, ReferenceQueue, RingBuffer und ListPriorityQueue implementieren das Interface Queue. Sie sind daher alle Schlangen. Allerdings implementieren sie jeweils unterschiedliche Anwendungslogiken. Wie sie das realisieren, bleibt dem Anwender verborgen. Dieser verlangt einfach nach einer Queue, spezifiziert deren Typ je nach Anwendungsfall und kann sie dann auf standardisierte Art und Weise nutzen. Diese Standardisierung, die wir auch bezüglich Comparable genutzt haben, stellt einen nicht zu unterschätzenden Gewinn für unsere eigenen Programm- und Datentypentwürfe dar.
Tree
Definition: Ein Binary Tree (binärer Baum) ist entweder leer oder besteht aus einem Knoten, dem ein Datenelement und zwei binäre Bäume zugeordnet sind.
Tabelle 10.4 Tree-Schnittstelle
Methode
Objekte
Ergebnis
Beschreibung
empty()
:
Baum
→
bool
true, wenn Baum leer
left()
:
Baum
→
Baum
linken (Teil-)Baum liefern
right()
:
Baum
→
Baum
rechten (Teil-)Baum liefern
content()
:
Baum
→
Objekt
liefert aktuellen Wurzelinhalt
1packageadt;
2 3/**
4 * Interface für den generischen ADT {@code Tree}.
5 *
6 * @param <T> Datentyp
7 */ 8publicinterfaceTree<T> {
910/**
11 * Prüfung, ob der Baum leer ist.
12 *
13 * @return {@code true}, wenn Baum leer, sonst {@code false}
14 */15booleanempty();
16/**
17 * Rückgabe des linken Teilbaums.
18 *
19 * @return linker Teilbaum
20 */21Tree<T>left();
22/**
23 * Rückgabe des rechten Teilbaums.
24 *
25 * @return rechter Teilbaum
26 */27Tree<T>right();
28/**
29 * Rückgabe des in der Wurzel gespeicherten Datenobjekts.
30 *
31 * @return Wert
32 */33Tcontent();
34}
Listing 10.17: adt.Tree.java
Achtung: Verdeutlichen Sie sich, dass die Operationen left() und right() jeweils wieder einen Baum liefern, nicht nur einen einzelnen Knoten.
Konzept zur Implementierung eines binären Baumes mithilfe von Verweisen
Ein Baum besteht, mithilfe von Verweisen implementiert, aus Knotenelementen, die neben einer Datenlast je zwei Verweise besitzen, einen Verweis auf den linken Sohn und einen Verweis auf den rechten Sohn. Diese können auch leer sein. Zur Konstruktion eines Baumes dienen verschiedene Konstruktoren.
1packageadt;
2 3importjava.util.NoSuchElementException;
4 5/**
6 * Referenz-basierter binärer Baum.
7 *
8 * <p>Hinweis: Der Konstruktor {@code ReferenceTree(l, content, r)}
9 * verlinkt die Teilbäume (keine Kopie). Dadurch können mehrere
10 * Baumobjekte dieselben Knoten teilen.</p>
11 *
12 * <p>Teilbäume werden verlinkt. Das spart Kopien, bedeutet aber:
13 * mehrere Tree-Objekte können dieselben Knoten referenzieren.
14 * Mutierende Operationen müssen daher sorgfältig implementiert
15 * werden.</p>
16 *
17 * @param <T> Datentyp der Elemente
18 */ 19publicclassReferenceTree<T>implementsTree<T> {
20 21/**
22 * Baumknoten (gekapselt, für Nachfolger zugreifbar)
23 */ 24protectedstaticclassNode<T> {
25/** Knoteninhalt */ 26protectedTcontent;
27/** linker Teilbaum oder {@code null} */ 28protectedNode<T>left;
29/** rechter Teilbaum oder {@code null} */ 30protectedNode<T>right;
31 32/** Konstruktor für einen neuen Knoten.
33 *
34 * @param content Inhalt
35 */ 36protectedNode(Tcontent) {
37this.content=content;
38 }
39 }
40 41/** Wurzelknoten */ 42protectedNode<T>root;
43 44/**
45 * Erzeugt einen leeren Baum.
46 */ 47publicReferenceTree() {
48root=null;
49 }
50 51 52/**
53 * Erzeugt einen Baum mit genau einem Element als Wurzel.
54 *
55 * @param obj Wert (nicht {@code null})
56 */ 57publicReferenceTree(Tobj) {
58if (obj==null) {
59thrownewIllegalArgumentException("Kein Wert angegeben");
60 }
61root=newNode<>(obj);
62 }
63 64 65/**
66 * Erzeugt einen Baum aus linkem Teilbaum, Wurzelinhalt und
67 * rechtem Teilbaum. Teilbäume werden verlinkt (keine Kopie).
68 *
69 * @param l linker Teilbaum (oder {@code null})
70 * @param content Wurzelinhalt (nicht {@code null})
71 * @param r rechter Teilbaum (oder {@code null})
72 */ 73publicReferenceTree(ReferenceTree<T>l,
74Tcontent,
75ReferenceTree<T>r) {
76if (content==null) {
77thrownewIllegalArgumentException("Kein Wert angegeben");
78 }
79root=newNode<T>(content);
80if (l!=null)
81root.left=l.root;
82if (r!=null)
83root.right=r.root;
84 }
85 86 87/**
88 * Interner Konstruktor, um eine Teilbaum-View aus einem
89 * Knoten zu erzeugen.
90 *
91 * @param node Knoten
92 */ 93privateReferenceTree(Node<T>node) {
94this.root=node;
95 }
96 97/* ------------------------------------------------------------
98 * ADT-Methoden (öffentlich, wie im Interface Tree<T>)
99 * ------------------------------------------------------------ */100101/**
102 * Prüfung, ob der Baum leer ist.
103 *
104 * @return {@code true}, wenn Baum leer, sonst {@code false}
105 */106@Override107publicbooleanempty() {
108returnroot==null;
109 }
110111112/**
113 * Rückgabe des linken Teilbaums.
114 *
115 * @throws RuntimeException wenn Baum leer
116 * @return linker Teilbaum
117 */118@Override119publicTree<T>left() {
120if (empty())
121thrownewRuntimeException("Baum ist leer.");
122returnnewReferenceTree<>(root.left);
123 }
124125126/**
127 * Rückgabe des rechten Teilbaums.
128 *
129 * @throws RuntimeException wenn Baum leer
130 * @return rechter Teilbaum
131 */132@Override133publicTree<T>right() {
134if (empty())
135thrownewRuntimeException("Baum ist leer.");
136returnnewReferenceTree<>(root.right);
137 }
138139140/**
141 * Rückgabe des in der Wurzel gespeicherten Datenobjekts.
142 *
143 * @return Objet
144 */145@Override146publicTcontent() throwsNoSuchElementException {
147if (empty())
148thrownewNoSuchElementException("Baum ist leer.");
149returnroot.content;
150 }
151}
Listing 10.18: adt.ReferenceTree.java
Traversierungen
Zur Ausgabe eines Baumes, müssen wir die einzelnen Knoten abwandern können. Das nennen wir Traversierung. Eine Traversierung eines binären Baumes besteht aus dem systematischen Besuchen aller Knoten in einer bestimmten Reihenfolge.
Preorder: Vater, linker Sohn, rechter Sohn
Inorder: linker Sohn, Vater, rechter Sohn
Postorder: linker Sohn, rechter Sohn, Vater
D. h., dass für jeden besuchten Knoten stets in derselben Art weiter traversiert wird, die Traversierungen also rekursiv definiert sind.
Abbildung 10.4: Konzept des Verweis-Baums
Für den Baum in der obigen Abbildung ergeben sich dann die folgenden Traversierungen:
Preorder:   / + F * A  B - X Y
Inorder:    F + A * B  / X - Y
Postorder:  F A B * +  X Y - /
Bevor wir zum Test einen Baum konstruieren, benötigen wir eine Möglichkeit, die Baumknoten abzuschreiten und auszugeben. Wir implementieren einfache Traversen.
Wir brauchen nur die Definition der einzelnen Traversierungen 1:1 in Code umsetzen. Ein leerer Baum stellt die jeweilige Rekursionsbremse, den Basisfall, dar.
1packageadt;
2 3importde.pakad.udemy.StdOut;
4 5/** Einfache Traversierungen für binäre Bäume. */ 6publicclassTraverse {
7 8/**
9 * Preorder-Baumtraverse.
10 *
11 * @param tree Baum
12 * @param <T> Datentyp der Elemente im Baum
13 */14publicstatic<T>voidpreorder(Tree<T>tree) {
15if (!tree.empty()) {
16StdOut.print(tree.content());
17preorder(tree.left());
18preorder(tree.right());
19 }
20 }
212223/**
24 * Inorder-Baumtraverse.
25 *
26 * @param tree Baum
27 * @param <T> Datentyp der Elemente im Baum
28 */29publicstatic<T>voidinorder(Tree<T>tree) {
30if (!tree.empty()) {
31inorder(tree.left());
32StdOut.print(tree.content());
33inorder(tree.right());
34 }
35 }
363738/**
39 * Inorder-Baumtraverse mit Klammern.
40 *
41 * @param tree Baum
42 * @param <T> Datentyp der Elemente im Baum
43 */44publicstatic<T>voidbracketinorder(Tree<T>tree) {
45if (!tree.empty()) {
46if (!tree.left().empty()) IO.print('(');
47bracketinorder(tree.left());
48StdOut.print(tree.content());
49bracketinorder(tree.right());
50if (!tree.right().empty()) IO.print(')');
51 }
52 }
535455/**
56 * Postorder-Baumtraverse mit Klammern.
57 *
58 * @param tree Baum
59 * @param <T> Datentyp der Elemente im Baum
60 */61publicstatic<T>voidpostorder(Tree<T>tree) {
62if (!tree.empty()) {
63postorder(tree.left());
64postorder(tree.right());
65StdOut.print(tree.content());
66 }
67 }
68}
Listing 10.19: adt.Traverse.java
Das Programm TraverseTest.Java konstruiert mithilfe der Konstruktoren den Baum aus Abbildung 1.4.
Der Vorteil der Rekursion ist es, als Programmierer kein eigenes Protokoll darüber führen zu müssen, welche Knoten des zu traversierenden Baums noch nicht vollständig behandelt worden sind. Diese Aufgabe übernimmt, ganz automatisch, der Aufrufstapel der noch nicht vollständig abgearbeiteten rekursiven Methodenaufrufe.
Mit der Tiefen- und Breitensuche (nächster Unterabschnitt, Seite ), stelle ich Ihnen zwei Traversierungsstrategien vor, die iterativ vorgehen. Die Protokollierung über die Schritte, die jeweils noch zu tun sind, führen wir selbst Protokoll. Dazu nutzen wir die bereits besprochenen Datentypen, Stack und Queue.
Die Tiefensuche (DFS = Depth-First Search) besucht in einer Preorder-Reihenfolge. Zuerst wird der Vater eines (Teil-)Baums verarbeitet, dann der linke und am Ende der jeweils rechte Sohn.
Der Vater kann problemlos verarbeitet werden. Wir haben uns aber zu merken, dass es eventuell einen rechten Sohn gibt, bevor wir zur Verarbeitung eines potenziell linken Sohns schreiten. Andernfalls kommen wir an den nicht mehr heran. Die dafür geeignete Datenstruktur, das Protokoll zu führen, ist der Stack.
1packageadt;
2 3importde.pakad.udemy.StdOut;
4 5/** Tiefensuche auf binärem Bäumen */ 6publicfinalclassDFS {
7/**
8 * Tiefensuche auf Baum {@code tree}.
9 *
10 * @param tree Baum
11 * @param <T> Datentyp der Elemente im Baum
12 */13publicstatic<T>voiddfs(Tree<T>tree) {
14Tree<T>t;
15Stack<Tree<T>>stack=newReferenceStack<>();
1617// initial wird der gesamte Baum auf den Stack gelegt18if (!tree.empty())
19stack.push(tree);
2021// jetzt beginnt die Traversierung22while (!stack.empty()) { // solange Keller nicht leer23t=stack.pop(); // hole Baum vom Keller24do {
25StdOut.print(t.content()); // Wurzel ausgeben26if (!t.right().empty()) // wenn rechter Sohn existiert27stack.push(t.right()); // rechten Sohn merken28t=t.left(); // gehe zum linken Sohn29 } while (!t.empty()); // solange es linken Sohn gibt30 }
31 }
32}
Listing 10.21: adt.DFS.java
Breitensuche
Die Breitensuche (BFS = Breadth-First Search) traversiert einen Baum, von der Wurzel ausgehend, Ebene für Ebene. Dabei wird in jeder Ebene von links nach rechts vorgegangen. Die geeignete Datenstruktur, das erforderliche Protokoll zu verwalten, ist die Queue.
1packageadt;
2 3importde.pakad.udemy.StdOut;
4 5/** Breitensuche auf binärem Bäumen */ 6publicfinalclassBFS {
7/**
8 * Breitensuche auf Baum {@code tree}.
9 *
10 * @param tree Baum
11 * @param <T> Datentyp der Elemente im Baum
12 */13publicstatic<T>voidbfs(Tree<T>tree) {
14Tree<T>t;
15Queue<Tree<T>>queue=newReferenceQueue<>();
1617// initial wird der gesamte Baum in die Schlange eingefügt18if (!tree.empty())
19queue.enqueue(tree);
2021// jetzt beginnt die Traversierung22while (!queue.empty()) { // solange Schlange nicht leer23t=queue.dequeue(); // hole Baum aus Schlange24StdOut.print(t.content()); // Wurzel ausgeben25if (!t.left().empty()) // wenn linker Sohn existiert26queue.enqueue(t.left()); // linken Sohn merken27if (!t.right().empty()) // wenn linker Sohn existiert28queue.enqueue(t.right()); // linken Sohn merken29 }
30 }
31}
Das Programm BuildPostfixTree.java liest interaktiv einen Postfix-Ausdruck ein und generiert daraus einen binären Baum. Dieser kann dann mittels entsprechender Traversen ausgeben werden, zum Beispiel als Infix-Ausdruck.
1importadt.*;
2importde.pakad.udemy.StdIn;
3importde.pakad.udemy.StdOut;
4 5/**
6 * Interaktives Einlesen eines Postfix-Ausdrucks, Generierung
7 * eines binären Baums und dessen Traversierung.
8 */ 9publicclassBuildPostfixTree {
1011/**
12 * Aufbau eines Postfix-Baums.
13 *
14 * @param Postfix-Ausdruck
15 * @return Baum
16 */17publicstaticReferenceTree<Character>buildTree(char[]expression) {
18ReferenceTree<Character>t, l, r;
19Stack<ReferenceTree<Character>>s=newReferenceStack<>();
2021for (inti=0; i<expression.length; i++) {
22charch=expression[i];
23if (ch!='+'&&ch!='-'&&ch!='*'&&ch!='/')
24// ch ist Operand -> Blatt erzeugen25t=newReferenceTree<>(ch);
26else {
27// ch ist Operator -> Baum erzeugen28r=s.pop(); // rechter Sohn29l=s.pop(); // linker Sohn30t=newReferenceTree<>(l, ch, r);
31 }
32s.push(t); // Baum auf Stapel ablegen33 }
34returns.top(); // Ergebnisbaum liefern35 }
363738/**
39 * Treiber liest einen Postfix-Ausdruck ein und
40 * generiert einen entsprechenden Baum.
41 *
42 * @param args nicht genutzt
43 */44publicstaticvoidmain(String[]args) {
45char[]ex=StdIn.readlnChars("Postfix-Ausdruck: ");
46Tree<Character>tree=buildTree(ex);
47StdOut.print("Inorder.........: ");
48Traverse.inorder(tree); StdOut.println();
49 }
50}
Mit den bisher besprochenen Traversierungen haben wir uns ein Problem eingehandelt. Wir vermengen in Ihnen die Traversierung mit der Verarbeitung der Daten. Die bestand lediglich aus einer Ausgabe der jeweiligen Daten eines Baumknotens. Wollen wir jedoch etwas anderes tun, müssen wir die Traversen neu implementieren. – Gesucht ist also ein Verfahren, welches Traversierung und Datenverarbeitung trennt.
Eine Enumeration ist ein Objekt, das den sequentiellen Zugriff auf die Elemente einer Sammlung erlaubt, ohne deren interne Struktur offenzulegen.
Sie realisiert damit das Iterator-Prinzip:
Ein Objekt stellt schrittweise seine Elemente bereit, ohne preiszugeben, wie diese intern gespeichert sind.
Beachte: Während einer Traversierung sollte die Datenstruktur nicht verändert werden.
Interface Enumeration<E>
In Java ist eine Enumeration durch das Interface
java.util.Enumeration<E>
definiert. Es besitzt genau zwei Methoden:
hasMoreElements()
Liefert true, wenn noch mindestens ein weiteres Element vorhanden ist.
Liefert false, wenn die Enumeration erschöpft ist.
nextElement()
Liefert das nächste Element der Enumeration.
Wirft NoSuchElementException, falls kein weiteres Element existiert.
Die Verantwortung für die korrekte Reihenfolge und den internen Zustand liegt vollständig bei der Implementierung.
Grundprinzip der Implementierung
Eine Enumeration besteht konzeptionell aus zwei Teilen:
Interner Zustand
Merkt sich, wo sich die Enumeration aktuell befindet.
Beispiele:
ein Index
ein Stack
ein aktueller Knoten
mehrere Hilfsstrukturen
Zugriffslogik
Bestimmt, welches Element als Nächstes geliefert wird.
Aktualisiert den internen Zustand entsprechend.
Initialisierung im Konstruktor
Beim Erzeugen der Enumeration wird der Startzustand vorbereitet:
Anfangsposition setzen
Hilfsdatenstrukturen initialisieren
ggf. erste Elemente vorberechnen
Beispielhafte Aufgaben:
Index auf 0 setzen
Startknoten eines Baums festlegen
Anfangspfad auf einen Stack legen
hasMoreElements()
Diese Methode prüft nur, ob noch Elemente vorhanden sind.
Typische Implementierungen:
Prüfen, ob ein Index das Ende erreicht hat.
Prüfen, ob ein Stack leer ist.
Prüfen, ob ein vorberechnetes „nächstes Element" existiert.
Wichtig:
Keine strukturellen Änderungen.
Keine Zustandsveränderung, außer ggf. Vorbereitung (lazy evaluation).
nextElement()
Prüft, ob noch ein Element existiert. Wenn nicht, wird eine eine Ausnahme NoSuchElementException geworfen.
Liefert das aktuelle Element.
Aktualisiert den internen Zustand so, dass beim nächsten Aufruf das folgende Element geliefert wird.
nextElement() ist die zentrale Methode der Enumeration.
Enumerator für SingleLinkedList
1packageadt;
2 3importjava.util.Enumeration;
4importjava.util.NoSuchElementException;
5 6/**
7 * Enumerator für {@link adt.SingleLinkedList}.
8 *
9 * @param <T> Datentyp der Elemente in der Liste.
10 */11publicfinalclassEnumList<T>implementsEnumeration<T>{
1213privatefinalList<T>list;
1415/**
16 * Konstruktor - erzeugt den Enumerator.
17 *
18 * @param l Liste
19 */20publicEnumList(List<T>l) {
21list=l;
22list.reset();
23 }
242526/**
27 * Prüft, ob noch weitere Elemente vorhanden sind.
28 *
29 * @return {@code true}, wenn noch mindestens ein Element vorhanden;
30 * {@code false}, wenn alle Elemente durchlaufen wurden.
31 */32@Override33publicbooleanhasMoreElements() { return!list.endpos(); }
343536/**
37 * Gibt das nächste Element der Liste zurück.
38 *
39 * @return Das nächste Element (der Inhalt des Elements).
40 * @throws NoSuchElementException wenn keine weiteren Elemente mehr vorhanden sind.
41 */42@Override43publicTnextElement() {
44if (list.endpos())
45thrownewNoSuchElementException("Kein weiteres Element in Liste.");
46To=list.content();
47list.forward();
48returno;
49 }
50}
Listing 10.25: adt.EnumList.java
Zur Demonstration, wie wir mit einem Enumerator arbeiten, nutzen wir das Programm zum Testen der einfach verketteten Liste SingleLinkedListTest.java (Listing SingleLinkedListTest.java) und modifizieren dessen Ausgabe.
Aus
// Liste auf Anfang und alle Elemente ausgebenl.reset();
while (!l.endpos()) {
StdOut.println(l.content());
l.forward();
}
wird:
// alle Elemente ausgebenEnumList<Student>e=newEnumList<>(l);
while (e.hasMoreElements())
StdOut.println(e.nextElement());
Enumeratoren für einen binären Baum
Preorder-Traverse
Der Enumerator ist nicht allzu schwer zu implementieren. Seine Logik haben wir bereits bei der Tiefensuche, Seite , implementiert. Im Grunde trennen wir nur die while-Schleife in hasMoreElements() und nextElement() auf.
1packageadt;
2 3importjava.util.Enumeration;
4importjava.util.NoSuchElementException;
5 6/**
7 * Implementierung einer Preorder-Traversierung für einen binären Baum
8 * als {@link Enumeration}.
9 * <p>
10 * Die Traversierung erfolgt iterativ unter Verwendung eines Stacks.
11 * </p>
12 * <p>
13 * Reihenfolge: Wurzel -> linker Teilbaum -> rechter Teilbaum.
14 * </p>
15 * @param <T> Datentyp der Elemente im Baum.
16 */17publicfinalclassPreorderTraverse<T>implementsEnumeration<T> {
1819privatefinalStack<Tree<T>>s;
2021/**
22 * Initialisiert die Traversierung für den angegebenen Baum.
23 * Wenn der Baum nicht leer ist, wird die Wurzel auf den Stack
24 * gelegt.
25 *
26 * @param tree Der zu traversierende Baum.
27 * @throws IllegalArgumentException wenn der übergebene Baum
28 * {@code null} ist.
29 */30publicPreorderTraverse(Tree<T>tree)
31throwsIllegalArgumentException {
32if (tree==null)
33thrownewIllegalArgumentException(
34"Es darf nicht null übergeben werden.");
35s=newReferenceStack<>();
36if (!tree.empty())
37s.push(tree);
38 }
394041/**
42 * Prüft, ob noch weitere Elemente in der Traversierung vorhanden
43 * sind.
44 *
45 * @return {@code true}, wenn noch mindestens ein Element besucht
46 * werden muss;<br>
47 * {@code false}, wenn alle Knoten des Baums bereits
48 * durchlaufen wurden.
49 */50@Override51publicbooleanhasMoreElements() {
52return!s.empty();
53 }
545556/**
57 * Gibt das nächste Element der Preorder-Traversierung zurück.
58 * Dabei wird der aktuelle Knoten vom Stack genommen und seine
59 * Kinder (zuerst rechts, dann links) auf den Stack gelegt,
60 * um die korrekte Preorder-Reihenfolge einzuhalten.
61 *
62 * @return Das nächste Element (der Inhalt des aktuellen Knotens).
63 * @throws NoSuchElementException wenn keine weiteren Elemente
64 * mehr vorhanden sind.
65 */66@Override67publicTnextElement() {
68if (s.empty())
69thrownewNoSuchElementException("nextElement: Keller ist leer.");
70Tree<T>tree=s.pop();
71if (!tree.right().empty()) s.push(tree.right());
72if (!tree.left().empty()) s.push(tree.left());
73returntree.content();
74 }
75}
Listing 10.26: adt.PreorderTraverse.java
Inorder-Traverse
Die Enumeration für eine Inorder-Traverse ist nicht viel schwieriger zu implementieren als die Preorder-Traverse. Initial legen wir hierbei alle linken Söhne auf den Stack.
1packageadt;
2 3importjava.util.Enumeration;
4importjava.util.NoSuchElementException;
5 6/**
7 * Implementierung einer Inorder-Traversierung für einen binären Baum
8 * als {@link Enumeration}.
9 * <p>
10 * Die Traversierung erfolgt iterativ unter Verwendung eines Stacks.
11 * </p>
12 * <p>
13 * Reihenfolge: linker Teilbaum -> Wurzel -> rechter Teilbaum.
14 * </p>
15 * @param <T> Datentyp der Elemente im Baum.
16 */17publicfinalclassInorderTraverse<T>implementsEnumeration<T> {
1819privatefinalStack<Tree<T>>s;
2021/**
22 * Initialisiert die Traversierung für den angegebenen Baum.
23 * Wenn der Baum nicht leer ist, werden die Wurzel und alle
24 * linken Söhne auf den Stack gelegt.
25 *
26 * @param tree Der zu traversierende Baum.
27 * @throws IllegalArgumentException wenn der übergebene Baum
28 * {@code null} ist.
29 */30publicInorderTraverse(Tree<T>tree)
31throwsIllegalArgumentException {
32if (tree==null)
33thrownewIllegalArgumentException("Es darf nicht null übergeben werden.");
34s=newReferenceStack<>();
35while (!tree.empty()) {
36s.push(tree);
37tree=tree.left();
38 }
39 }
404142/**
43 * Prüft, ob noch weitere Elemente in der Traversierung vorhanden
44 * sind.
45 *
46 * @return {@code true}, wenn noch mindestens ein Element besucht
47 * werden muss;<br>
48 * {@code false}, wenn alle Knoten des Baums bereits
49 * durchlaufen wurden.
50 */51@Override52publicbooleanhasMoreElements() {
53return!s.empty();
54 }
555657/**
58 * Gibt das nächste Element der Inorder-Traversierung zurück.
59 * Nach der Entnahme eines Knotens vom Stack wird dessen rechter
60 * Teilbaum besucht und alle Knoten entlang dessen linkem Pfad
61 * auf den Stack gelegt.
62 *
63 * @return Das nächste Element
64 * (der Inhalt des aktuell besuchten Knotens).
65 * @throws NoSuchElementException wenn der Stack leer ist und
66 * keine weiteren Elemente existieren.
67 */68@Override69publicTnextElement() {
70if (s.empty())
71thrownewNoSuchElementException("nextElement: Keller ist leer.");
72Tree<T>t=s.pop();
73Tresult=t.content();
74if (!t.right().empty()) {
75t=t.right();
76do {
77s.push(t);
78t=t.left();
79 } while (!t.empty());
80 }
81returnresult;
82 }
83}
Listing 10.27: adt.InorderTraverse.java
Postorder-Traverse
Die Enumeration für die Postorder-Traversierung ist etwas komplexer als die vorigen Enumerationen. Es gibt verschiedene Möglichkeiten sie zu implementieren. Ich habe mich hier für eine 2-Stack-Lösung entschieden. Hierbei wird der zweite Stack (s2), über den dann nextElement() die Elemente ausliefert, initial mit allen Baumelementen in umgekehrter Postorder-Reihenfolge befüllt. Hierfür wird der Stack s1 als Hilfsstapel verwendet, um die umgekehrte Postorder-Reihenfolge zu generieren.
1packageadt;
2 3importjava.util.Enumeration;
4importjava.util.NoSuchElementException;
5 6/**
7 * Implementierung einer Postorder-Traversierung für einen binären Baum
8 * als {@link Enumeration}. Die Traversierung erfolgt iterativ unter
9 * Verwendung von zwei Stacks (Zwei-Stack-Algorithmus).
10 * <p>
11 * Reihenfolge: linker Teilbaum -> rechter Teilbaum -> Wurzel.
12 * </p>
13 * @param <T> Datentyp der Elemente im Baum.
14 */15publicfinalclassPostorderTraverse<T>implementsEnumeration<T> {
1617privatefinalStack<Tree<T>>s2;
1819/**
20 * Initialisiert die Traversierung für den angegebenen Baum.
21 * Nutzt einen Hilfsstack (s1), um die Knoten in der umgekehrten
22 * Postorder-Reihenfolge in den Ergebnisstack (s2) zu überführen.
23 *
24 * @param tree Der zu traversierende Baum.
25 * @throws IllegalArgumentException wenn der übergebene Baum
26 * {@code null} ist.
27 */28publicPostorderTraverse(Tree<T>tree) {
29if (tree==null)
30thrownewIllegalArgumentException("Es darf nicht null übergeben werden.");
31Stack<Tree<T>>s1=newReferenceStack<>();
32s2=newReferenceStack<>();
3334if (!tree.empty()) s1.push(tree);
3536// baut Stack in umgekehrte PostorderReihenfolge37while (!s1.empty()) {
38Tree<T>cur=s1.pop();
39s2.push(cur);
4041// Für Postorder: Erst links, dann rechts in s1 pushen,42// damit s2 die Reihenfolge Links-Rechts-Wurzel abbildet.43if (!cur.left().empty()) s1.push(cur.left());
44if (!cur.right().empty()) s1.push(cur.right());
45 }
46 }
474849/**
50 * Prüft, ob noch weitere Elemente in der Traversierung vorhanden
51 * sind.
52 *
53 * @return {@code true}, wenn noch mindestens ein Element auf dem
54 * Ergebnisstack liegt;<br>
55 * {@code false}, wenn alle Knoten bereits zurückgegeben
56 * wurden.
57 */58@Override59publicbooleanhasMoreElements() {
60return!s2.empty();
61 }
6263/**
64 * Gibt das nächste Element der Postorder-Traversierung zurück.
65 * Die Elemente werden direkt vom vorbefüllten Ergebnisstack
66 * entnommen.
67 *
68 * @return Das nächste Element (der Inhalt des aktuell besuchten
69 * Knotens).
70 * @throws NoSuchElementException wenn keine weiteren Elemente
71 * mehr vorhanden sind.
72 */73@Override74publicTnextElement() {
75if (s2.empty())
76thrownewNoSuchElementException("nextElement: Keller ist leer.");
77returns2.pop().content();
78 }
79}
Listing 10.28: adt.PostorderTraverse.java
Suchbaum
Definition: Ein SearchTree (binärer Suchbaum, Binary Search Tree – BST) ist eine spezielle Form eines binären Baums, bei dem die gespeicherten Elemente geordnet sind.
Diese Ordnung erlaubt es, Such-, Einfüge- und Löschoperationen effizient durchzuführen.
Der SearchTree ist eine Mengen-Datenstruktur:
Jedes Element kommt höchstens einmal vor.
Die Reihenfolge der Elemente wird implizit durch die Baumstruktur repräsentiert.
Die Baumstruktur hängt von der Einfüge-Reihenfolge ab.
Tabelle 10.5 Set-Schnittstelle
Methode
Objekte
Ergebnis
Beschreibung
empty()
:
Menge
→
bool
true, wenn Menge leer
lookup()
:
Menge
→
Objekt
Objekt, wenn gefunden, sonst null
insert()
:
Menge
→
Objekt
eingefügtes/gefundenes Objekt
Anmerkung: In vielen Lehrbüchern liefert insert() lediglich einen Wahrheitswert. In dieser Implementierung gibt insert() das im Baum gespeicherte Objekt zurück. Dadurch lassen sich typische Anwendungen (z. B. Zählstatistiken) ohne zusätzliche Suchoperation formulieren.
1packageadt;
2/**
3 * Schnittstelle für Mengen-Operationen.
4 *
5 * @param <T> Datentyp der gespeicherten Werte
6 */ 7publicinterfaceSet<TextendsComparable<?superT>> {
8/**
9 * Prüft, ob Menge leer ist.
10 *
11 * @return {@code true}, wenn leer, sonst {@code false}
12 */13booleanempty();
14/**
15 * Sucht {@code x} in Menge.
16 * @param x gesuchtes Element
17 * @return {@code x}, wenn gefunden, sonst {@code null}
18 */19Tlookup(Tx);
20/**
21 * {@code x} einfügen, wenn noch nicht vorhanden.
22 *
23 * @param x einzufügendes Element
24 * @return eingefügtes/gefundenes Element
25 */26Tinsert(Tx);
27/**
28 * {@code x} aus Menge löschen.
29 *
30 * @param x zu löschendes Element
31 * @return {@code true} bei Erfolg, sonst {@code false}
32 */33booleandelete(Tx);
34}
Listing 10.29: adt.Set.java
Der „klassische" Suchbaum trennt den Schlüssel und den zu speichernden Wert, unterscheidet also zwischen ihnen. Es muss dann lediglich der Schlüssel vergleichbar sein. Insofern stellt der hier gezeigte Suchbaum eine vereinfachte Form des klassischen Suchbaums dar. In unserer Implementierung bildet der Wert gleichzeitig des Schlüssel, weshalb ausschließlich vergleichbare Werte in ihm gespeichert werden können.
Ordnungseigenschaft (Suchbaum-Invariante)
Für jeden Knoten mit dem gespeicherten Wert x gilt:
Alle Werte im linken Teilbaum sind kleiner als x.
Alle Werte im rechten Teilbaum sind größer als x.
Diese Eigenschaft gilt rekursiv für alle Teilbäume. Sie ist die zentrale Invariante des Suchbaums und muss nach jeder Operation (einfügen, löschen) erhalten bleiben.
Voraussetzung: Vergleichbarkeit der Elemente
Damit die Ordnung definiert ist, müssen die gespeicherten Elemente vergleichbar sein. Daher gilt für den Datentyp T:
T implements Comparable<? super T>
Das bedeutet:
Zwei Elemente vom Typ T können miteinander verglichen werden.
Die Vergleichslogik darf auch in einer Oberklasse von T definiert sein.
Der Vergleich erfolgt über: x.compareTo(y) mit:
< 0 : x < y
= 0 : x == y
> 0 : x > y
Suche (lookup)
Die Suche nutzt die Ordnungseigenschaft:
Prinzip:
Beginne an der Wurzel.
Vergleiche den gesuchten Wert x mit dem aktuellen Knotenwert k.
Falls x == k, dann Element gefunden.
Falls x < k, dann suche im linken Teilbaum.
Falls x > k, dann suche im rechten Teilbaum.
Wiederhole, bis das Element gefunden wird oder ein leerer Teilbaum erreicht ist.
Eigenschaften:
Es wird immer nur ein Pfad vom Wurzelknoten nach unten verfolgt.
Keine vollständige Durchsuchung des Baums nötig.
Das Suchen in einem Suchbaum erfordert im Durchschnitt eine Laufzeit der Ordnung $\log_2(n)$, wenn der Baum nicht entartet ist. Das passiert nur, wenn das Einfügen in den Suchbaum in auf- oder absteigender Reihenfolge der Elemente erfolgt. Dann mutiert der Baum zu einer Liste. Ist er dagegen ausgewogen, beträgt die Höhe des Baumes $\log_2(n)$ in Bezug auf die Anzahl der in ihm gespeicherten Elemente.
Einfügen (insert)
Prinzip:
Das Einfügen folgt exakt dem gleichen Pfad wie die Suche:
Starte an der Wurzel.
Vergleiche das neue Element x mit dem aktuellen Knoten.
Gehe links oder rechts entsprechend der Ordnung.
Erreiche einen leeren Teilbaum.
Füge dort einen neuen Knoten mit x ein.
Duplikate:
Falls beim Vergleich x == k gilt:
Das Element ist bereits im Baum.
und wird nicht erneut eingefügt.
Dadurch bleibt die Mengen-Eigenschaft erhalten.
Löschen (delete)
Das Löschen ist die komplexeste Operation, da die Baumstruktur sowie die Invariante erhalten bleiben müssen.
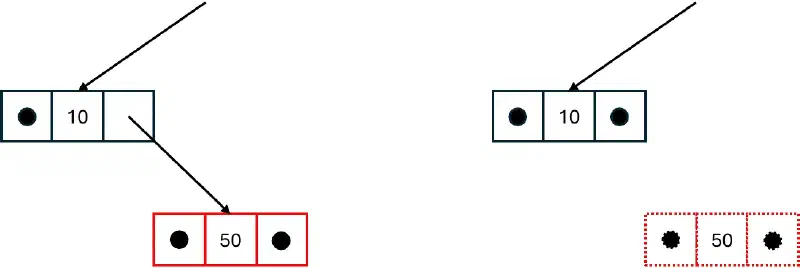
Fall 1: Knoten ohne Kinder (Blatt)
Der Knoten wird einfach entfernt.
Abbildung 10.5: Löschen eine Knotens ohne Sohn
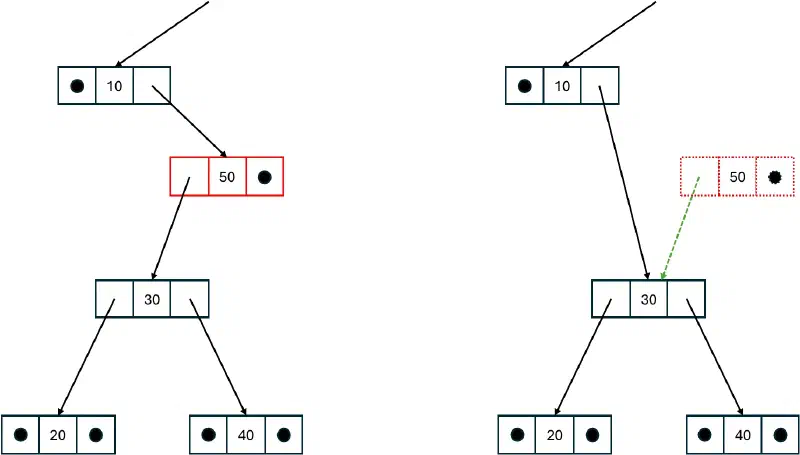
Fall 2: Knoten mit genau einem Kind
Der Knoten wird entfernt.
Sein Kind rückt an seine Stelle.
Abbildung 10.6: Löschen eine Knotens mit einem Sohn
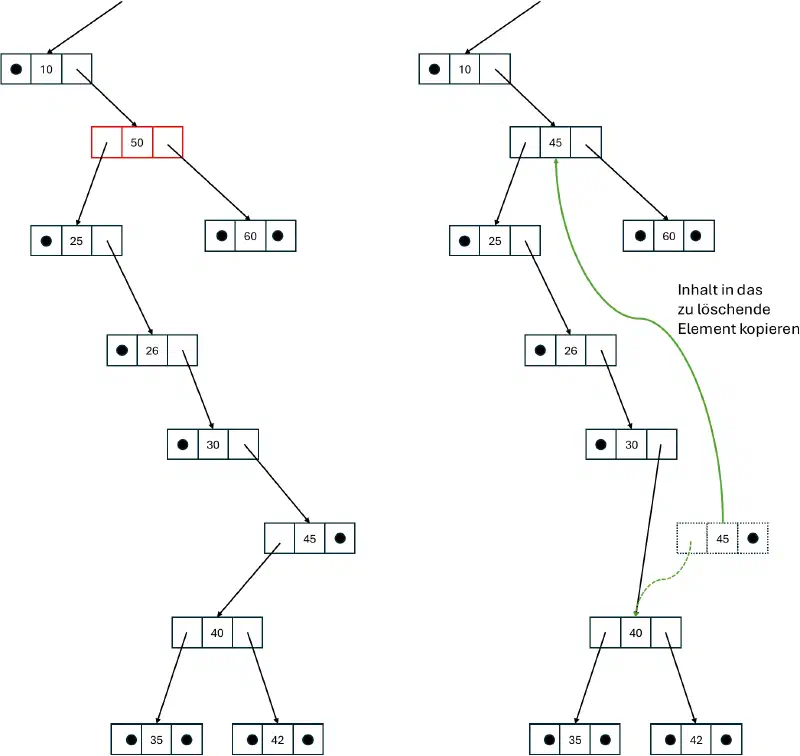
Fall 3: Knoten mit zwei Kindern
Der Knoten wird nicht direkt entfernt.
Stattdessen wird sein Wert ersetzt durch:
suche das größte Kind des linken Unterbaums
tausche dessen Inhalt mit dem des zu löschenden Knotens, der de facto im Baum verbleibt
lösche das größte Kind des linken Unterbaums
Abbildung 10.7: Löschen eine Knotens mit 2 Söhnen
So bleibt die Suchbaum-Invariante erhalten.
1packageadt;
2 3/**
4 * Ein binärer Suchbaum, der das Interface {@link Set} implementiert.
5 * Die Elemente werden basierend auf ihrer natürlichen Ordnung sortiert
6 * gespeichert. Duplikate sind nicht erlaubt.
7 *
8 * @param <T> Elementtyp, muss vergleichbar sein
9 */ 10publicclassSearchTree<TextendsComparable<?superT>> 11extendsReferenceTree<T> 12implementsSet<T> {
13 14// Hilfsmethode, um das Maximum in einem 15// linken Teilbaum zu suchen (muss rechts sein) 16privateNode<T>findMax(Node<T>n) {
17while (n.right!=null)
18n=n.right;
19returnn;
20 }
21 22/**
23 * Entfernt ein Element aus dem Suchbaum.
24 * Dabei werden drei Fälle unterschieden:
25 * 1. Der Knoten ist ein Blatt: Er wird einfach entfernt.
26 * 2. Der Knoten hat ein Kind: Das Kind rückt an die Stelle des
27 * Knotens nach.
28 * 3. Der Knoten hat zwei Kinder: im linken Kind-Baum den größten
29 * Knoten suchen, dessen Inhalt in den aktuellen Knoten
30 * übernehmen und löschen
31 *
32 * @param x Das zu löschende Element.
33 * @return {@code true}, wenn das Element gefunden und
34 * gelöscht wurde;
35 * {@code false}, falls das Element nicht im Baum
36 * enthalten war.
37 * @throws IllegalArgumentException wenn {@code x} {@code null} ist.
38 */ 39@Override 40publicbooleandelete(Tx) {
41if (x==null) thrownewIllegalArgumentException("x ist null");
42 43// Knoten suchen 44Node<T>parent=null; // Hilfsknoten Vater 45Node<T>child=root; // Hilfsknoten Sohn (init. mit Wurzel) 46 47// solange Knoten vorhanden und zu löschendes Element 48// nicht gefunden ... 49while (child!=null&&x.compareTo(child.content) !=0) {
50// Baum absteigen 51parent=child;
52if (x.compareTo(child.content) <0)
53child=child.left;
54else 55child=child.right;
56 }
57 58if (child!=null) {
59// Element wurde gefunden -> Ersatzknoten suchen 60Node<T>substitute;
61 62// nur einen Sohn oder keine Söhne (Blatt -> übernimm null) 63if (child.left==null)
64// wenn linker Sohn leer -> rechter Sohn wird Ersatz 65substitute=child.right;
66else 67if (child.right==null)
68// wenn rechter Sohn leer -> linker Sohn wird Ersatz 69substitute=child.left;
70else {
71// 2-Söhne-Fall 72// Ersatzknoten ist Sohn selbst 73substitute=child;
74// Inhalt des größten linken Knotens ermitteln und merken 75Ttmp=findMax(substitute.left).content;
76// größten linken Knoten aus Baum löschen 77delete(tmp);
78// Ersatzknoten übernimmt Inhalt 79substitute.content=tmp;
80 }
81// Setze Ersatzknoten in Baum ein 82// 83// Sonderfall: Element war Wurzel 84if (parent==null)
85// Ersatzknoten wird neuer Wurzelknoten 86root=substitute;
87// andernfalls prüfe, ob ... 88else 89if (x.compareTo(root.content) <0)
90// Ersatzknoten neuer linker Knoten 91parent.left=substitute;
92else 93// Ersatzknoten neuer rechter Knoten 94parent.right=substitute;
95returntrue;
96 }
97else 98// zu löschendes Element wurde nicht gefunden 99returnfalse;
100 }
101102103/**
104 * Fügt ein neues Element in den Suchbaum ein, sofern es noch nicht
105 * vorhanden ist.
106 *
107 * @param x Das einzufügende Element.
108 * @return eingefügtes/gefundenes Element
109 * @throws IllegalArgumentException wenn {@code x} {@code null} ist.
110 */111@Override112publicTinsert(Tx) {
113if (x==null) thrownewIllegalArgumentException("x ist null");
114115// leerer Baum -> neue Wurzel116if (root==null) {
117root=newNode<T>(x);
118returnx;
119 }
120121// Platz zum Einfügen finden122Node<T>cur=root;
123while (true) {
124intcmp=x.compareTo(cur.content);
125if (cmp==0) {
126// schon vorhanden -> nur Inhalt zurückgeben127returncur.content;
128 }
129if (cmp<0) {
130// links absteigen131Node<T>left=cur.left;
132if (left==null) {
133// freier Platz -> einfügen, zurückgeben134cur.left=newNode<T>(x);
135returnx;
136 }
137cur=left;
138 } else {
139// rechts absteigen140Node<T>right=cur.right;
141if (right==null) {
142// freier Platz -> einfügen, zurückgeben143cur.right=newNode<T>(x);
144returnx;
145 }
146cur=right;
147 }
148 }
149 }
150151152@Override153publicTlookup(Tx) {
154if (x==null) thrownewIllegalArgumentException("x ist null");
155156Node<T>cur=root; // beginne bei Wurzel157while (cur!=null) { // solange ein Knoten vorliegt ...158intcmp=x.compareTo(cur.content);
159160if (cmp==0) returncur.content; // wenn gefunden -> liefern161if (cmp<0) cur=cur.left; // wenn kleiner -> links absteigen162elsecur=cur.right; // größer -> rechts absteigen 163 }
164// nicht gefunden165returnnull;
166 }
167}
Listing 10.30: adt.SearchTree.java
Fallstudie: Cross-Referenz-Liste
Eine Cross-Referenz-Liste, wie wir sie hier implementieren wollen, erstellt eine Textanalyse und -statistik. Ein Text wird über die Standardeingabe gelesen und in Worte zerlegt. Als Wort gelten beliebige Zeichenfolgen aus den Buchstaben des deutschen Alphabets. Die Häufigkeit des Vorkommens der Worte, unter Berücksichtigung von Groß- und Kleinschreibung, im Text wird gezählt. Zusätzlich wird ein Protokoll gepflegt, in dem festgehalten wird, in jeweils welcher Zeile des Textes das jeweilige Wort gefunden wurde.
Wir verwenden den Suchbaum aus dem vorangegangenen Abschnitt. In ihm speichern wir die gefundenen Worte. Aufgrund seiner Mengeneigenschaft, werden gleiche Worte nicht mehrfach eingefügt. Allerdings müssen die Worte gezählt und das jeweilige Protokoll des Vorkommens fortgeschrieben werden. Wir nutzen hierzu die Eigenschaft von insert(), uns eine Referenz auf das neue oder schon vorhandene Wort zurückzugeben. So können wir ein Wort versuchen einzufügen, um dann im Nachgang, ob gefunden oder neu eingefügt, dessen Statistik fortzuschreiben.
Das Datenelement, in welchem wir jeweils ein Wort speichern, muss das Interface Comparable bezüglich des in ihm gespeicherten Wortes erfüllen.
1importadt.EnumList;
2importadt.List;
3importadt.SingleLinkedList;
4importjava.util.Enumeration;
5/**
6 * Wort-Information für Cross-Referenz-Anwendungen.
7 * <p>
8 * Gespeichert werden:
9 * </p>
10 * <ol>
11 * <li>Wort</li>
12 * <li>Anzahl der Vorkommen</li>
13 * <li>Zeilennummern der Vorkommen</li>
14 * </ol>
15 */16publicfinalclassWordInfoimplementsComparable<WordInfo> {
1718privatefinalStringword; // normalisiert (lowercase)19privateintcount;
20privatefinalList<Integer>lines=newSingleLinkedList<>();
2122/**
23 * Konstruktor.
24 *
25 * @param word zu speicherndes Wort
26 */27publicWordInfo(Stringword) {
28this.word=word;
29count=0;
30 }
313233/**
34 * Getter für den Wort-Inhalt.
35 *
36 * @return Wort
37 */38publicStringword() { returnword; }
394041/**
42 * Getter für die Häufigkeit des Vorkommens.
43 *
44 * @return Häufigkeit
45 */46publicintcount() { returncount; }
474849/**
50 * Liste vom Typ {@link adt.List} zur Speicherung der Zeilen,
51 * in denen das gespeicherte Wort vorkommt.
52 *
53 * @return Kopie der Liste
54 */55publicList<Integer>lines() {
56List<Integer>linesCopy=newSingleLinkedList<>();
57Enumeration<Integer>iterator=newEnumList<>(lines);
58while (iterator.hasMoreElements())
59linesCopy.insert(iterator.nextElement());
60returnlines;
61 }
626364/**
65 * Aktualisierung der Wortstatistik (Anzahl, Zeilen)
66 *
67 * @param lineNo Zeile, in der das Wort gefunden wurde
68 */69publicvoidseenInLine(intlineNo) {
70count++;
71lines.insert(lineNo); // Wort einfügen72 }
737475/**
76 * Implementierung der Schnittstelle {@link Comparable} unter
77 * Verwendung der in {@code String} implementierten Methode
78 * {@link String#compareTo}.
79 *
80 * @param o Vergleichsobjekt
81 * @return <0, wenn Objekt kleiner Vergleichsobjekt
82 * 0, wenn Objekt gleich Vergleichsobjekt
83 * >0, wenn Objekt größer Vergleichsobjekt
84 */85@Override86publicintcompareTo(WordInfoo) {
87returnthis.word.compareTo(o.word);
88 }
89}
Listing 10.31: WordInfo.java
Mit diesem Datenelement ist es nun einfach, das Programm CrossReference.java zu schreiben. Es liest seine Standardeingabe zeichenweise und sammelt die Zeichen für je ein Wort. Ist ein Wort gefunden, wird es in den Suchbaum eingesetzt. Über die zurückgegebene Referenz wird seenInLine() aufgerufen, um die Statistik des Wortes zu aktualisieren.
1importjava.util.Enumeration;
2 3importadt.InorderTraverse;
4importadt.SearchTree;
5importde.pakad.udemy.StdIn;
6importde.pakad.udemy.StdOut;
7 8/**
9 * Cross-Referenz-Anwendung.
10 */11publicclassCrossReference {
1213// Wort an Suchbaum übergeben und zurücksetzen14privatestaticvoidflushWord(SearchTree<WordInfo>tree,
15StringBuilderword,
16intlineNo) {
1718if (!word.isEmpty()) {
19WordInfonewWordInfo=newWordInfo(word.toString());
20WordInforeturnedWordInfo=tree.insert(newWordInfo);
21returnedWordInfo.seenInLine(lineNo);
22word.setLength(0);
23 }
24 }
252627/**
28 * Über die Standardeingabe wird ein Text eingelesen und eine
29 * Cross-Referenz-Statistik erstellt.
30 *
31 * @param args nicht genutzt
32 */33publicstaticvoidmain(String[]args) {
34SearchTree<WordInfo>tree=newSearchTree<>();
35StringBuilderword=newStringBuilder();
36intlineNo=1;
37charch;
3839while (StdIn.hasNextChar()) {
40ch=StdIn.readChar();
4142if (ch=='\n') lineNo++;
43if (Character.isLetterOrDigit(ch)) {
44word.append(ch);
45 }
46elseif (!word.isEmpty()) {
47flushWord(tree, word, lineNo);
48 }
49 }
50// falls Text mit einem Buchstaben endet muss das entsprechende51// Wort noch im Baum eingetragen werden.52flushWord(tree, word, lineNo);
5354// Inorder-Ausgabe der Wortstatistik55Enumeration<WordInfo>it=newInorderTraverse<>(tree);
56while (it.hasMoreElements()) {
57WordInfow=it.nextElement();
58StdOut.printf("%s: %d: %s%n", w.word(),w.count(),w.lines());
59 }
60 }
61}
Als eine weitere Anwendung wollen wir eine Wörterbuchsuche mithilfe unsere Suchbaumes implementieren. Sie soll das Folgende leisten:
Einlesen einer Wörterbuchdatei (ein Wort pro Zeile).
Prefix-Suche: Wir geben die ersten Buchstaben als Suchbegriff ein. Der Suchbaum liefert alle Treffer.
Bereichssuche: Wie geben ein Intervall von Präfixen als Suchbegriffe ein. Der Suchbaum liefert alle Worte, die in das so abgesteckte Intervall fallen.
RangeAutocomplete.java liest eine als Kommandozeilenargument angegebene Textdatei ein und baut aus den Worten einen Suchbaum auf. Ist das geschehen, kann der Anwender Worte im Text suchen. Er sucht nach Worten, die mit einer bestimmten Zeichenfolge beginnen oder nach Worten, die sich in einem bestimmten Bereich des Alphabets befinden.
Nach dem Start des Programms soll dem Anwender ein minimalistisches User-Interface angeboten werden. Über einzugebende Kommandos teilt er dem Programm mit, was es tun soll:
$ java RangeAutocomplete data/german_shuffled.txt
Index aufgebaut. Interaktive Abfragen:
Befehle: prefix <prefix> | range <von> <bis> | quit
>
Kommandos sind notwendig. Ohne entsprechende Kommandos können Suchmuster nicht von möglichen Kommandos unterschieden werden. Beispielsitzung:
$ java  RangeAutocomplete data/oliver.txt
Index aufgebaut. Interaktive Abfragen:
Befehle: prefix <prefix> | range <von> <bis> | quit
> prefix Ol
Wörter mit Präfix "Ol":
  Oliver (6) [112, 106, 40, 31, 24, 16]
Befehle: prefix <prefix> | range <von> <bis> | quit
> range ma mz
Wörter im Bereich ["ma" .. "mz"]:
  machen (1) [105]
  man (4) [109, 104, 50, 37]
  matt (1) [43]
  mehr (2) [49, 23]
  meisten (1) [3]
  menschlichen (1) [15]
  mich (1) [44]
  mir (3) [82, 58, 58]
  mischte (1) [53]
  mit (8) [83, 74, 68, 58, 55, 49, 31, 18]
  murmelte (1) [96]
  muss (1) [91]
Befehle: prefix <prefix> | range <von> <bis> | quit
> quit
Ende.
$ _
Die Aufgabe ist nicht trivial. Das folgende Diagramm zeigt Ihnen, welche Klassen mit welchen Methoden in meiner Musterlösung beteiligt sind. – Es steht Ihnen natürlich frei, eine ganz andere Lösung zu finden.
Abbildung 10.8: UML-Diagramm der an RangeAutocomplete beteiligten Klassen
StdIn ist nicht dazu entworfen, Dateien im File-System zu verarbeiten. Dank der I/O-Abstraktion des Betriebssystems, können wir StdIn dennoch dazu übereden, aus einer Datei zu lesen. Dazu nutzen wir einen einen kleinen „Trick“, den StdIn gestattet. Wir setzen die Standardeingabe auf die einzulesende Datei. Danach, um wieder von der Tastatur Eingaben zu empfangen, restaurieren Sie die Standardeinstellung. Der folgende Codeschnipsel zeigt Ihnen, wie das funktioniert.
publicvoidmain(String[]args) {
if (args.length<1) {
StdOut.println("Aufruf: java RangeAutocomplete <datei>");
return;
}
// 1 - Textdatei als StdIn-Quelle setzentry (InputStreamin=newFileInputStream(args[0])) {
StdIn.setInputStream(in);
// Datei einlesen und Suchbaum aufbauen ...
// 2 - zurück zur Tastatur für interaktive BefehleStdIn.resetToSystemIn();
StdOut.println("Index aufgebaut. Interaktive Abfragen:");
// Dialog mit dem Anwender (bis der keine Lust mehr hat) ...
} catch(Exceptione) {
StdErr.println(e);
System.exit(1); // Fehlerstatus, Programmende }
}
Im Begleitmaterial finden Sie, neben oliver.txt einem Auszug aus Oliver Twist vom Autor Charles Dickens, auch zwei Wörterbuchdateien. Die eine ist sortiert, die andere, mit shuffeled im Dateinamen, nicht. Sie enthalten jeweils $2,152,638$ Worte. Versuchen Sie sie in Ihrem Programm zu laden.
Tipp: Brechen Sie das Laden der sortierten Datei ruhig ab (CTRL-C).
Überlegen Sie, warum das Laden der sortierten Datei ewig dauert, das Laden der „shuffeled"-Datei aber schnell geht. - Wenn Sie die Antwort wissen, ist dies ein gutes Zeichen dafür, dass Sie binäre Bäume verstanden haben! Wir haben nun gesehen, dass die Leistungsfähigkeit eines Suchbaums nicht nur vom Algorithmus, sondern entscheidend von der Einfüge-Reihenfolge der Daten abhängt.
Laufzeitverhalten binärer Bäume
Die Laufzeit hängt von der Höhe des Baums ab.
Idealfall (balanciert):
Höhe: $\mathcal{O}(\log_2(n))$
lookup, insert, delete: $\mathcal{O}(\log_2(n))$
Schlechtester Fall (entartet, sortierte Einfügefolge):
Höhe: $\mathcal{O}(n)$
Operationen:
Suchen/Löschen: $\mathcal{O}(n)$
Einfügen: $\mathcal{O}(n^2)$
Ein einfacher SearchTree ist nicht selbstbalancierend. AVL-, Red-Black-Bäume lösen dieses Problem.