Java behandelt Zeichenketten in String als Folgen von UTF-16-Codeeinheiten. Ein char repräsentiert eine solche 16-Bit-Codeeinheit, wodurch es mit einer großen Bandbreite an Unicode-Zeichen kompatibel ist. Dies bringt jedoch auch Herausforderungen bei der Verarbeitung von Sonderzeichen mit sich, die sich im Rahmen der UTF-16-Kodierung nicht in einer Code-Einheit abbilden lassen. Das können beispielsweise asiatische Zeichen oder auch Emojis sein, die zwei oder sogar noch mehr Code-Einheiten à 16 Bit benötigen.
Dieser für Anfänger geeignete Artikel befasst sich damit, wie Java Zeichen verarbeitet, wie Zeichen mit mehr als einer Code-Einheit gespeichert werden und wie Kodierungsfehlinterpretationen zu Darstellungsproblemen führen können.
Zeichensätze und Codierungen: Wohl und Wehe
Noch vor nicht allzu langer Zeit waren wir froh und glücklich, wenn wir mittels unserer Tastatur die Zeichen eingeben konnten, die wir zur Erstellung von Texten in unserer jeweiligen Landessprache benötigten. Je nach Landessprache waren das üblicherweise je 256 verschiedene Zeichen, inklusive der nicht druckbaren Steuerzeichen. Solange wir uns auf unsere jeweilige Landessprache beschränkten, war dieser Zeichenvorrat in der Regel ausreichend. Problematisch wurde es jedoch, wenn mit wir mit fremdsprachigen Personen Texte austauschen wollten. Da sendete man dann einen deutschen Text mit den üblichen Umlauten, wie beispielsweise ä, ö, ü und dem allseits beliebten ß, welches keinen Großbuchstaben kennt, an jemanden, der mit amerikanischen oder anderen Zeichensatzeinstellungen arbeitete. Die Folge war ein für den Empfänger unleserlicher Text. Statt der originalen Sonderzeichen standen dann seltsame Zeichen an den entsprechenden Stellen. Das wollte schon rein optisch nicht passen. - Denken Sie nun an die vielen Sprachen und möglichen Schriftzeichen dieser Welt. Es bedarf wenig Fantasie, sich vorzustellen, wie schwierig es ist, mit nur jeweils 256 Zeichen, die je nach Land unterschiedlich sein können, Texte in lesbarer Form auszutauschen.
Heute ist das, zumindest vordergründig, alles viel einfacher. Wir schreiben eine E-Mail und versenden diese in alle Welt. Unsere Freundin in Tokio kann unseren Text fehlerfrei im Original lesen. Umgekehrt gilt das ebenso, auch wenn wir der japanischen Sprache und deren Schriftzeichen nicht mächtig sind. - Eine Augenweide ist ein solcher Text allemal.
Der Grund für die jetzt scheinbar heile Welt nennt sich Unicode.
Im Oktober 1991 wurde, nach mehrjähriger Entwicklungszeit, die Version 1.0.0 des so genannten Unicode-Standards veröffentlicht. Diese erste Version codierte nur die europäischen, nahöstlichen und indischen Schriften. Version 1.0.1 codierte, etwa acht Monate später, auch schon ostasiatische Schriftzeichen. Mit der Veröffentlichung von Unicode 2.0 im Juli 1996 wurde der Standard von ursprünglich 65.536 Zeichen auf die heutigen 1.114.112 Codepunkte erweitert. Das entspricht einer Codierung von U+0000 bis U+10FFFF. Zur Codierung von Zeichen stehen 1.111.998 Codepunkte zur Verfügung, die aber bislang noch nicht vollständig genutzt werden. Man beachte dabei: Ein Codepunkt ist nicht zwingend ein codiertes Zeichen!
Die Frage, die sich angesichts dieser potenziellen Zeichenfülle stellt, ist wohl die, wie wir damit umzugehen haben. So einfach die Welt für Anwender von E-Mail- und anderen Programmen zu sein scheint, so schwierig und komplex stellt sie sich Programmierern dar. Das gilt insbesondere für Programmieranfänger. In Seminaren wurde etliche Male "Hello, World" im Terminalfenster ausgegeben. Was ist aber mit "こんにちは、世界!". Laut DeepL ist das „Hello, World!“ auf japanisch. Und was ist mit den so beliebten Smileys, die viele SMS-Nachrichten zieren. - Versuchen wir es.
Irgendwas stimmt da nicht. Wir haben nur einen Smiley ausgegeben, nicht zwei! - Das weckt unseren Forschergeist, das will aufgeklärt werden.
Unicode-Grundlagen: Das Fundament moderner Textverarbeitung
Unicode wird oft missverstanden. Es ist keine Kodierung wie UTF-8 oder UTF-16. Es ist ein Standard, in riesiges Verzeichnis für Zeichen, in dem jedem Zeichen eine eindeutige Nummer (ein Codepunkt) zugewiesen ist. Das gilt auch für die schon erwähnten Emojis.
Der Buchstabe „B“ → Codepunkt: U+0042
Das zwinkernde Gesicht 😉 → Codepunkt: U+1F609
Als Codepunkt (englisch code point) wird im Zusammenhang mit Zeichensätzen (z.B. ASCII oder Unicode) der Zahlenwert eines Zeichens im Coderaum (englisch code space) bezeichnet. In Zeichensätzen werden abstrakte Zeichen (englisch abstract characters) mit Codepunkt verbunden. Die Verbindung wird als kodiertes Zeichen (englisch encoded character) bezeichnet.
Ein Codepunkt wird im Allgemeinen durch eine positive Ganzzahl repräsentiert. Der Coderaum ist die Menge aller Ganzzahlen, die ein gültiges Zeichen des Zeichensatzes beschreiben – in manchen Zeichensätzen gibt es Zahlenwerte (Bitfolgen), die keine Zeichenentsprechung besitzen und somit „ungültig“ sind.
Der Coderaum des ASCII-Zeichensatzes umfasst dezimal 0–127 (hexadezimal: 0–7F), der Coderaum des Unicode-Zeichensatzes umfasst dezimal 0–1114111 (hexadezimal: 0–10FFFF). Das Zeichen B hat in beiden Zeichensätzen den Codepunkt dezimal 66 (hexadezimal: 42).
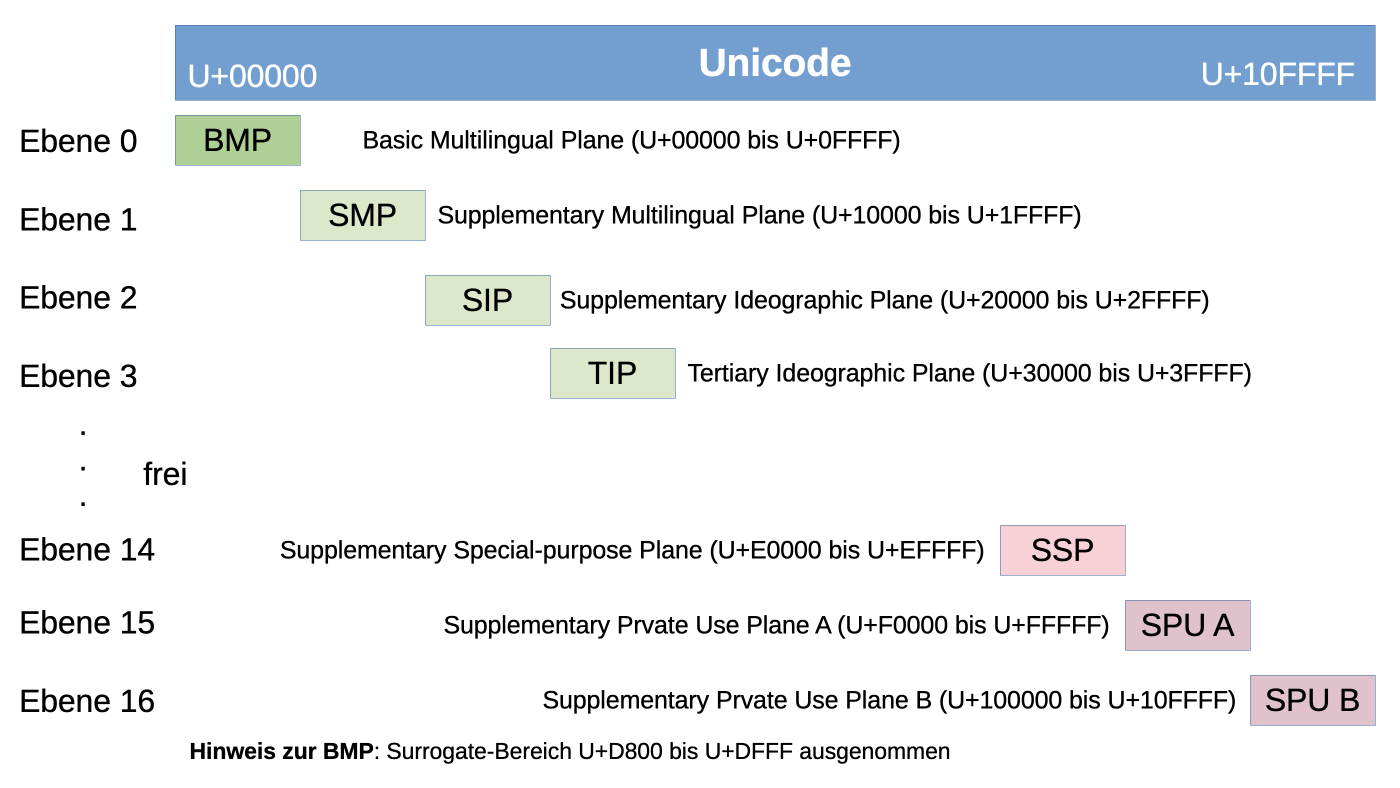
Im Unicode sind die Zeichen nicht willkürlich durchnummeriert. Vielmehr ist der Unicode in sogenannte Ebenen (englisch Planes) aufgeteilt. Diese enthalten das die verschiedenen Codepunkte für die Zeichen, die dieser Ebene zugeordnet sind. Ohne zu sehr ins Detail gehen zu wollen, können wir uns das Unicode-Schema wie folgt visualisieren.
Vereinfachtes Unicode-Schema
Abbildung 1
Kodierungen (ASCII, UTF-8, UTF-16) legen dann fest, wie diese Zahlen als Bytes gespeichert werden. Java verwendet intern UTF-16, was einige subtile Fallstricke mit sich bringt, wie Sie an unserem einfachen Beispiel mit dem Smiley gesehen haben.
Einige Bereiche sind nicht für die Zeichencodierung zulässig. Für Zeichen stehen lediglich 1.111.998 Codepunkte zur Verfügung. Die Anzahl der tatsächlich zugewiesenen Codepunkte ist jedoch deutlich niedriger, nimmt aber immer noch zu. So wurde beispielsweise im Juni 2015, unter anderem das Cherokee-Alphabet aufgenommen. - Es ist wirklich interessant, was es alles gibt.
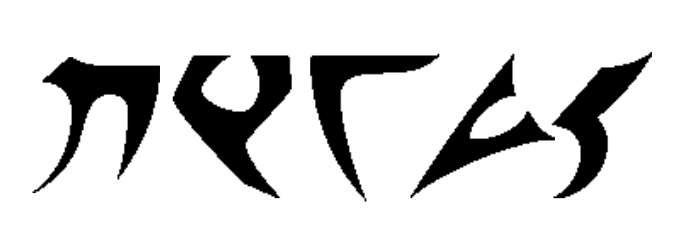
Star Trek Fans mögen allerdings traurig sein, denn Klingonisch ist offiziell nicht im Unicode erfasst. Dank der beliebten Fernsehserie „The Big Bang Theory“ gibt es bestimmt mehr Menschen, die sich mit Klingonisch befassen, als es Interessenten für das Cherokee-Alphabet gibt. Umgekehrt sind die Cherokee natürlich reale Mitmenschen unserer Erdengesellschaft – Reale Klingonen wurden bislang nicht auf der Erde gesichtet. ConScript Unicode Registry ist ein Projekt, welches sich um die Zuordnung von Codepunkten in der SPU A des Unicodes bemüht. Dort verortet das Projekt das klingonische Alphabet im Bereich U+F8D0 bis U+F8FF.
Klingonisch: „Ich habe Kopfschmerzen.“
Abbildung 2
Codepunkte vs. Codeeinheiten vs. Graphemcluster
Anmerkung: Sequenz von einem oder mehreren Unicode-Codepunkten, die von einem Menschen als ein einziges, zusammenhängendes Zeichen wahrgenommen wird.
Stell dir drei Ebenen vor:
Codepunkt: Die abstrakte Zahl aus Unicode (U+1F48B = 💋).
Codeeinheit: Wie Kodierungen diese Punkte im Speicher darstellen. UTF-16 verwendet 16-Bit-Einheiten, manchmal eine, manchmal zwei.
Graphemcluster: Was Menschen als „ein einzelnes Zeichen“ wahrnehmen. Kann aus einem Codepunkt oder mehreren kombinierten bestehen (z. B. „e“ + kombinierbarer Akzent).
Beispiel: „a😉c“
Graphemcluster: 3 (a, 😉, c)
Codepunkte: 3 (U+0061, U+1F609, U+0063)
UTF-16-Codeeinheiten: 4 (😉 benötigt zwei Einheiten als Surrogatpaar)
Das erklärt, warum string.length() uns oft in die Irre führt und beispielsweise den Smiley als zwei Zeichen betrachtet. - In der Tat kann der Smiley nicht als char smiley = '😉' vereinbart werden. Er passt nicht in eine einzelne Codeeinheit von 16-Bit, die uns char zur Verfügung stellt. length() liefert uns also die Anzahl der 16-Bit-Codeeinheiten, nicht die Anzahl der Zeichen.
Normalisierung - Verwirrung total
Es mag verwirrend sein, aber so ist es. Dasselbe visuelle Zeichen kann mehrere Darstellungen im Unicode haben. Beispiel:
"é “` = U+00E9 (vorkomponiert)
"e" + "´" = U+0065 + U+0301 wird (komponiert) und ergibt visuell “é”
Für viele Zeichen gibt es mehrere Möglichkeiten, sie als Kette von Unicode-Zeichen darzustellen (z.B. der deutsche Umlaut „ä“ als solches oder als „a“ mit Trema). Ein Zeichenvergleich in Form eines einfachen Vergleichs der auf Basis der char-Einheiten, der Codeeinheiten, genügt daher nicht, denn er könnte Unterschiede in der Codierung erkennen, die aber keine Unterschiede im Text bedeuten. Um festzustellen, ob zwei Zeichen und/oder Zeichenketten den gleichen Text repräsentieren, ist es daher notwendig, beide in die gleiche Normalform zu überführen.
Ohne Normalisierung entspricht "café" möglicherweise nicht "café". Die Normalisierung gewährleistet eine konsistente Speicherung und einen konsistenten Vergleich.
Der Unicode-Standard kennt unterschiedliche Normalformen von Unicode-Zeichenketten und Algorithmen zur Normalisierung, also zur Überführung einer Zeichenkette in eine solche Normalform.
Wie Java Zeichen in UTF-16 darstellt
Javas String-Klasse verwendet die UTF-16-Kodierung, was bedeutet, dass jedes Unicode-Zeichen als eine oder zwei 16-Bit-Codeeinheiten gespeichert wird. Diese Einheit ist das char.
Der Buchstabe „A“ → eine Codeeinheit (16 Bit)
Das zwinkernde Gesicht 😉 → zwei Codeeinheiten (2 x 16 Bit)
Daher können wir 😉 auch nicht in einem char speichern, müssen stattdessen String verwenden.
Dieses System ermöglicht die Unterstützung einer riesigen Bandbreite an Zeichen aus verschiedenen Schriftsystemen und sorgt gleichzeitig für einen im Vergleich zu älteren Kodierungen mit fester Breite relativ effizienten Speicherverbrauch. Die Art und Weise, wie Java Zeichen auf niedriger Ebene verarbeitet, beeinflusst jedoch, wie diese in Anwendungen gespeichert, abgerufen und verarbeitet werden.
Speicherung grundlegender Zeichen
Die am häufigsten verwendeten Zeichen, darunter englische Standardbuchstaben, Ziffern und Satzzeichen, passen in eine einzige 16-Bit-Einheit. Diese Zeichen haben Codepunkte im Bereich von U+0000 bis U+FFFD, der BMP. Das bedeutet, dass sie direkt einem einzelnen 16-Bit-Wert im Speicher zugeordnet werden. Beispielsweise wird der Buchstabe B (U+0042) in UTF-16 wie folgt gespeichert:
Hex: 0042
Binary: 00000000 01000010
Das Gleiche gilt für andere Standard-ASCII-Zeichen, die alle in einen einzigen 2-Byte-Speicherplatz passen. Dadurch lassen sich diese Zeichen einfach lesen, schreiben und verarbeiten, da jedes einzelne genau einen Speicherplatz belegt.
Speicherung von Zeichen außerhalb der BMP
Obwohl UTF-16 oft als Kodierung mit fester Breite angesehen wird, verwendet es tatsächlich ein Format mit variabler Länge. Einige Zeichen, insbesondere solche aus erweiterten Schriftsystemen wie alten Sprachen oder modernen Emojis, benötigen mehr als eine einzelne 16-Bit-Codeeinheit.
Zeichen mit Unicode-Codepunkten jenseits von U+FFFF fallen in den ergänzenden Bereich (Ebene 1 bis 16), für dessen Speicherung zwei 16-Bit-Codeeinheiten erforderlich sind. Dies geschieht mithilfe von Surrogatpaaren, einem Mechanismus, der es UTF-16 ermöglicht, Zeichen zu kodieren, deren Speicherplatzbedarf über den einer einzelnen 16-Bit-Codeeinheit hinausgehen.
Beispielsweise hat das 😂-Emoji den Unicode-Codepunkt U+1F602. Da dieser größer ist als U+FFFF, wird er in ein Wertepaar aufgeteilt:
Anstatt als einzelner Wert gespeichert zu werden, teilt Java ihn in zwei separate 16-Bit-Werte auf, die gemeinsam verarbeitet werden müssen, um das vollständige Zeichen darzustellen.
Hintergrundinformation
Das 😂 hat den Codepunkt U+1F602 und wird in die Surrogate U+D83D und U+DE02 aufgeteilt, weil das UTF-16-Encoding Zeichen außerhalb der ersten Standard-Ebene (BMP) in zwei 16-Bit-Einheiten codieren muss, sogenannte Surrogate-Paare.
Die Aufteilung folgt einem festen mathematischen Algorithmus von Unicode.
Die mathematische Berechnung
UTF-16 teilt Zeichen über dem Wert U+FFFF nach folgendem System auf: 1. Vom Codepunkt abziehen: Zuerst wird der Basiswert 0x10000 vom Zeichenwert abgezogen. - 0x1F602 minus 0x10000 = 0x0F602 2. In Binärschreibweise umwandeln: Die Zahl 0x0F602 wird in eine 20-Bit-Binärzahl umgewandelt. - 0x0F602 = 0000 1111 0110 0000 0010 3. In zwei Hälften splitten: Diese 20 Bits werden in zwei Hälften zu je 10 Bits getrennt. - Höhere 10 Bits (High): 0000 1111 01 (Hexadezimal: 0x003D) - Niedrigere 10 Bits (Low): 10 0000 0010 (Hexadezimal: 0x0202) 4. Basiswerte für Surrogate addieren: - High-Surrogat: Die höheren Bits werden zum Basiswert 0xD800 addiert. - 0xD800 + 0x003D = 0xD83D - Low-Surrogat: Die niedrigeren Bits werden zum Basiswert 0xDC00 addiert. - 0xDC00 + 0x0202 = 0xDE02
Wie Java Surrogatpaare verarbeitet
Während ein einzelnes char in Java immer 16 Bit groß ist, passen nicht alle Zeichen in ein char. In solchen Fällen speichern wir deren Surrogate in einem char-Paar. Das bedeutet, dass ein String, der Zeichen mit Codepunkten jenseits von U+FFFF enthält, eine length() aufweist, die größer ist als die Anzahl der tatsächlich sichtbaren Zeichen. - Wir haben das in HelloUnicode.java gesehen.
Hinweis: Ein einzelner Unicode-Codepunkt benötigt in UTF-16 höchstens zwei Codeeinheiten, also ein Surrogatpaar. Es gibt jedoch Emojis, die aus mehreren Codepunkten bestehen und deshalb in UTF-16 auch mehr als zwei Codeeinheiten benötigen. - Wir werden das noch am Familien-Emoji sehen.
Um solche Zeichen jedoch auch korrekt verarbeiten zu können, stellt uns Java verschiedene Methoden zur Verfügung, mit denen statt einzelner char-Werte die vollständigen Unicode-Codepunkte verarbeitet werden können.
Beispiel in Java:
Listing 2: UnicodeCodePoints.java
publicclass UnicodeCodePoints {publicstaticvoidmain(String[] args){/* Direkter Weg über Strings */String emoji ="😂";// Multi-Unit-ZeichenSystem.out.println(emoji);System.out.println("Länge: "+ emoji.length());// 2System.out.println("Codepunkt-Anzahl: "+ emoji.codePointCount(0, emoji.length()));// 1/* Automatische Berechnung via 'Character.toChars()' */int codePoint =0x1F602;// Das Emoji 😂// Java berechnet das Surrogate-Paar automatisch in ein char-Arraychar[] surrogatePair =Character.toChars(codePoint);System.out.printf("High: U+%04X%n",(int) surrogatePair[0]);// U+D83DSystem.out.printf("Low : U+%04X%n",(int) surrogatePair[1]);// U+DE02// Prüfen, ob es sich um Surrogate handeltchar c1 =0xD83D;char c2 =0xDE02;System.out.printf("U+%04X High-Surrogate: %b\n",(int)c1,Character.isHighSurrogate(c1));// trueSystem.out.printf("U+%04X Low-Surrogate : %b\n",(int)c2,Character.isLowSurrogate(c2));// true// Zusammenfügen zurück zum ursprünglichen Codepunktint originalCodePoint =Character.toCodePoint(c1, c2);System.out.printf("Codepunkt: U+%X%n", originalCodePoint);// U+1F602}}
Praxis-Rezepte
Codepunkte zählen
codePointCount(start, end) zählt die Codepunkte in einem bestimmten Bereich eines Strings. Dabei gibt startdie Index-Position der ersten Codeeinheit (char) an, ab der gezählt werden soll. end bestimmt die exklusive Obergrenze der zuletzt zu analysierenden Codeeinheit der betrachteten Zeichenkette. Es wird also so, wie Sie das von Arrays kennen, bis end -1 gezählt.
Wenn ein darstellbares Zeichen aus einem oder zwei char-Elementen, den Surrogaten, bestehen kann, ist klar, das die einfache Konstruktion einer Schleife
nicht funktionieren kann. Ein Codepunkt außerhalb der BMP wird in UTF-16 durch ein Surrogatpaar dargestellt! - Wir müssen uns daher überlegen, alle sichtbaren Zeichen einer Zeichenkette als kurze Strings auszugeben.
Die Methode String.codePoints() liefert einen Strom von Codepunkten (ganze Zahlen), mögliche Surrogate werden dabei bereits zu Codepunkten verrechnet. Wir erhalten ein Objekt des Typs IntStream. Jeder dieser Codepunkte lässt sich mittels Character.toString() in eine darstellbare Zeichenketten umwandeln. Das Problem besteht darin, einen Strom nicht einfach iterieren zu können. Da hilft die Methode IntStream.toArray(), die den Strom in ein Array ganzer Zahlen (int[]) umwandelt.
Damit können wir den folgenden Code-Schnipsel entwerfen.
Das geht in modernem Java aber auch kompakter. Das folgende Programm IterateString.java zeigt „klassische“ und moderne Vorgehensweise nebeneinander.
Listing 4: IterateString.java
publicclass IterateString {publicstaticvoidmain(String[] args){String text ="Hi 😂";// klassische Vorgehensweiseint[] codePoints = text.codePoints().toArray();for(int i=0; i<codePoints.length; i++)System.out.printf("Zeichen: %s Codepunkt: (U+%04X)\n",Character.toString(codePoints[i]), codePoints[i]);System.out.println();// moderne Vorgehensweise text.codePoints().forEach(cp ->{// Gibt den Hex-Wert und das Zeichen ausSystem.out.printf("Zeichen: %s (U+%04X)\n",Character.toString(cp), cp);});}}
Hier die Ausgabe:
$ java IterateStringZeichen: H Codepunkt: (U+0048)Zeichen: i Codepunkt: (U+0069)Zeichen: Codepunkt: (U+0020)Zeichen: 😂 Codepunkt: (U+1F602)Zeichen: H Codepunkt: (U+0048)Zeichen: i Codepunkt: (U+0069)Zeichen: Codepunkt: (U+0020)Zeichen: 😂 Codepunkt: (U+1F602)$ _
Text sicher kürzen
Wenn Sie einen String nach einer bestimmten Anzahl von Codepunkten abschneiden wollen, dürfen Sie (aus den bekannten Gründen) nicht einfach substring() blind aufrufen. Sie schneiden sich im schlimmsten Fall das High-Surrogate vom Low-Surrogate ab.
Hier ist ein sicherer Weg, eine Zeichenkette anhand der Codepunkte zu kürzen.
Listing 5: SubString.java
publicclass SubString {publicstaticStringsafeSubstring(String text,int maxCodePoints){return text.codePoints().limit(maxCodePoints)// Limitiert auf die Codepunkte.collect(StringBuilder::new,StringBuilder::appendCodePoint,StringBuilder::append).toString();}publicstaticvoidmain(String[] args){String str ="Java😂Kaffee";System.out.println(safeSubstring(str,5));}}
Der Code bedarf vielleicht einer Erläuterung:
text.codePoints() gibt ein IntStream-Objekt zurück.
IntStream.limit(maxCodePoints) kürzt einen Stream auf maximal maxCodePoints Codepunkte.
Der dreiteilige Aufruf collect(StringBuilder::new, StringBuilder::appendCodePoint, StringBuilder::append) gehört zur Stream-API in Java und ist eine spezielle Variante der collect()-Methode (eine sogenannte Mutable Reduction Operation).
Kurz gesagt: Sie nimmt einen Stream von Zahlen (die Codepunkte, also int-Werte) und baut daraus Schritt für Schritt wieder einen fertigen String zusammen.
Hier ist die genaue Aufschlüsselung der drei Parameter, die alle als Methodenreferenzen (::) übergeben werden:
Was es tut: Es stellt einen leeren „Behälter“ bereit, in den die Daten gesammelt werden.
Hintergrund: Java erstellt hier im Hintergrund einmalig (oder bei parallelen Streams mehrmals) ein neues StringBuilder-Objekt: new StringBuilder().
Der Accumulator: StringBuilder::appendCodePoint
Was es tut: Es beschreibt, wie ein einzelnes Element aus dem Stream in den Behälter wandert.
Hintergrund: Da unser Stream aus int-Werten (den Unicode-Codepunkten) besteht, können wir nicht das normale append(char) oder append(String) nutzen. Die Methode appendCodePoint(int codePoint) ist speziell dafür da, eine Unicode-Zahl zu nehmen, sie bei Bedarf automatisch in ein Surrogate-Paar umzurechnen und an den StringBuilder anzuhängen.
Der Combiner: StringBuilder::append
Was es tut: Es beschreibt, wie zwei Behälter zusammengefügt werden, falls Java den Stream parallel (auf mehreren CPU-Kernen gleichzeitig) verarbeitet.
Hintergrund: Wenn zwei Threads unabhängig voneinander zwei separate StringBuilder befüllt haben, sagt dieser dritte Parameter Java: „Nimm am Ende den zweiten StringBuilder und hänge ihn mit .append() einfach hinten an den ersten dran.“ (Bei normalen, sequentiellen Streams wird dieser Schritt vom System optimiert und läuft gar nicht erst an).
Wir halten an dieser Stelle ein StringBuilder-Objekt in den Händen, wollen/müssen aber einen String zurückgeben. Folglich wandeln wir das Ganze mittels toString()noch in die zurückzugebende Zeichenkette.
Vor Java Version 8 hätte man das wohl so implementiert:
Java-Neulinge werden die klassische Variante klarer verständlich finden. Sie ist in dieser Form aber z.B. nicht sicher, wenn die übergebene Zeichenkette weniger als maxCodePoints Codepunkte hat. Das müsste man noch absichern. Diese Sicherheit ist bei der modernen Stream-Variante von Haus aus gegeben. Zudem ist die moderne Variante effizienter bezüglich des Speichers. Man benötigt kein zusätzliches Array. Daneben, und das ist eher eine Geschmacksfrage, bevorzugen viele Entwickler den deklarativen Stil, zu sagen, was getan werden soll, gegenüber dem imperativen Stil, der eben mit der Schleife sagt, wie es getan werden soll.
Lange Rede, kurzer Sinn - die Ausgabe des Programms sieht so aus:
$ java SubString Java😂$ _
Zeichen außerhalb der BMP filtern
Wir greifen das Grundkonzept des vorigen Programms auf, um Zeichen Zeichen jenseits der BMP auszufiltern, und bedienen uns dazu einfach der filter()-Methode des IntStream-Objekts. Das Zusammenbauen des zurückzugebenden String-Objekts haben wir gerade besprochen.
Der Code nutzt einen Lambda-Ausdruck. Lambdas wurden mit Java 8 eingeführt.
cp -> cp <=0xFFFF
ist wie folgt zu lesen: „Für jeden Codepunkt cp prüfe, ob cp kleiner oder gleich 0xFFFF ist.“
Links vom -> steht der Übergabeparameter (der Name cp ist frei gewählt und steht kurz für Code Point). Da der Stream aus Zahlen besteht, weiß Java automatisch, dass cp eine int-Variable ist.
Rechts vom -> steht der eigentliche Quellcode, der ausgeführt werden soll. Bei filter() muss hier immer ein Vergleich stehen, der entweder true (behalten) oder false (eliminieren) ergibt.
So ein Lambda-Ausdruck ist deshalb praktisch, weil man ansonsten jeden einzelnen int-Wert aus dem Strom „prokeln“ und dann beispielsweise einer Methode test() hätte überantworten müssen. Liefert die dann true dürfte das Zeichen bleiben, sonst nicht. - Probieren Sie es aus. Formulieren Sie den Code gerne um. Er wird garantiert länger.
Beispielsitzung:
$ java BMPFilter
Code 123  Tech
$ _
Ausgabebreite von Zeichen
Es wird Ihnen bei der Ausgabe von IterateString.java aufgefallen sein, dass manche Zeichen eine breitere Ausgabe benötigen als andere. Das ist unangenehm, wenn wir uns eine sauber tabulierte Ausgabe wünschen.
Die Glyphe 文 benötigt beispielsweise in einem Terminal zwei Ausgabespalten. Auch die Formatierungsfunktionen haben mit Zeichen, die mehr als eine 16-Bit-Codeeinheit belegen, ihre Probleme. So beziehen sich die Formatierungsangaben von printf() immer auf die Länge eines Zeichens bzw. einer Zeichenkette in Bezug auf ihre jeweilige Anzahl der Codeeinheiten. Um Texte mit Zeichen verschiedener Ausgabebreite vernünftig formatieren zu können, benötigen wir also eine Routine, die uns die Ausgabebreite der Glyphen, die mit den Codepunkten einer Zeichenkette assoziiert sind, ermittelt.
Java bietet uns dazu standardmäßig keine Lösung an. Was also tun? - Ich habe mich selbst ans Werk gemacht, eine einfache Methode zu schreiben, mit der ich die Ausgabebreite eines Zeichens im Terminal prüfen kann. Der folgende Code ist einfach und stellt definitiv keine professionelle und allgemeingültige Lösung dar. Ich gehe sämtliche Codepunkte durch und erhöhe je Kategorie in welche sie fallen, nötigenfalls die Ausgabebreite des übergebenen Textes.
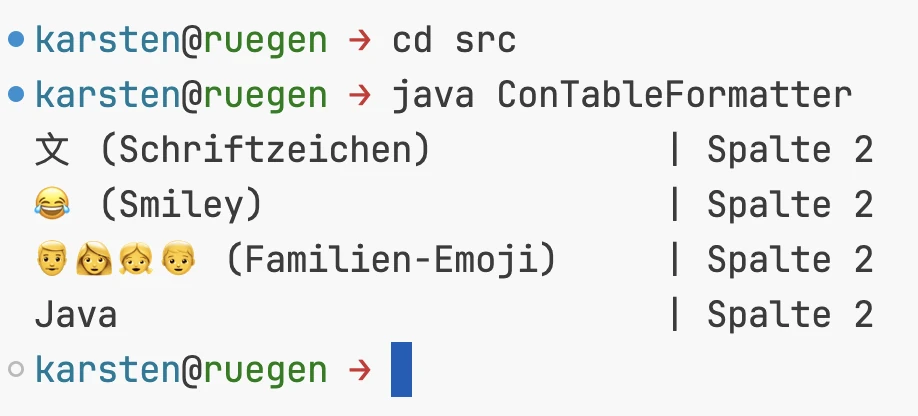
Die Schleife in ConWidth.java zählt die einzelnen Emoji-Codepunkte jeweils mit Breite 2 und ignoriert nur die Zero Width Joiner (ZWJ). Damit wird aus dem einen dargestellten Familien-Emoji möglicherweise rechnerisch eine zu große Breite errechnet. - Für das integrierte Terminal in VSCode sieht das passend aus. Das Emoji wird „ausgepackt“ dargestellt, wenn das Program im Terminal von VSCode ausgeführt wird. Statt des eigentlichen Emojis werden die ganzen darin überlagerten Einzel-Emojis zur Anzeige gebracht.
Ausgabe im Terminal von VSCode
Abbildung 3
Ganz anders gestaltet es sich, wenn das Programm in der standardmäßigen Terminal-App von macOS ausgeführt wird. Da sieht das Ergebnis dann so aus. Das Terminal zeigt das originale Familien-Emoji. Mein Programm hat jedoch die Ausgabebreite der beinhalteten Emojis berechnet. In der Folge haben wir eine fehlerhaft dargestellte Ausgabe.
Das Terminal rendert typischerweise die gesamte ZWJ-Sequenz als eine Glyphe.
Hier stößt man endgültig auf das Problem, das wir am Anfang mit Graphemclustern schon angedacht haben. Die Ausgabebreite im Terminal lässt sich nicht zu 100% verlässlich bestimmen, indem man lediglich jedem einzelnen Codepunkt eine Breite zugewiesen wird. Dazu kommen Terminal, Font, Unicode-Version und East-Asian-Width-Eigenschaften.
Die Methode löst also nicht das allgemeine Problem der Terminalausgabebreite. Sie zeigt vielmehr, wie schnell aus einer scheinbar einfachen Frage – „Wie breit ist dieser Text?“ – ein ziemlich anspruchsvolles Unicode-Problem werden kann.
Fazit
Solange wir es mit „handelsüblichen“ Zeichen zu tun haben, z.B. nur west-europäischen Schriftzeichen, ist die Welt mit Java einfach zu bewältigen. Haben wir es jedoch mit seltsamen Sonderzeichen zu tun, müssen wir Obacht geben und diese nötigenfalls entsprechend behandeln.
Dieser Beitrag hat Ihnen einen kurzen Einblick in die Welt der Zeichen gegeben. Es gibt jedoch sehr viel mehr Anwendungsgebiete, wie beispielsweise Netzwerkkommunikation oder Datenbankkonnektivität, bei denen Sie ebenfalls mit den Zeichen „zu kämpfen“ haben können. Ich hoffe dennoch, dass der Beitrag Ihnen die Angst vor Sonderzeichen und deren Handhabung ein wenig genommen und Ihnen Ideen und Anregungen für Ihre eigenen Aufgaben aufgezeigt hat.