Kapitel 12: Graphen
Graphen stellen ein weites und interessantes Betätigungsfeld dar. Wenn Sie Informatik studieren, werden Sie sich allein mindestens ein Semester speziell mit dieser Datenstruktur auseinandersetzen. Das kann dieses Seminar nicht leisten. Graphen sind jedoch auch ein vielfältiges Anwendungsgebiet für die ADTs, die wir uns in den vergangenen Kapiteln erarbeitet haben. In Bezug auf Graphen stellen Sie in ihrer Summe einen Werkzeugkasten bereit, der es ihnen ermöglicht, Graphen leicht, elegant und effizient zu verarbeiten. Aus diesem Grund, Ihnen dies beispielhaft zu demonstrieren, behandeln wir in diesem Kapitel ausgewählte Graphen und Graphalgorithmen.
Ein Graph ist eine abstrakte Struktur zur Darstellung von paarweisen Beziehungen zwischen Objekten, bestehend aus einer Menge von Knoten (Ecken) und verbindenden Kanten.
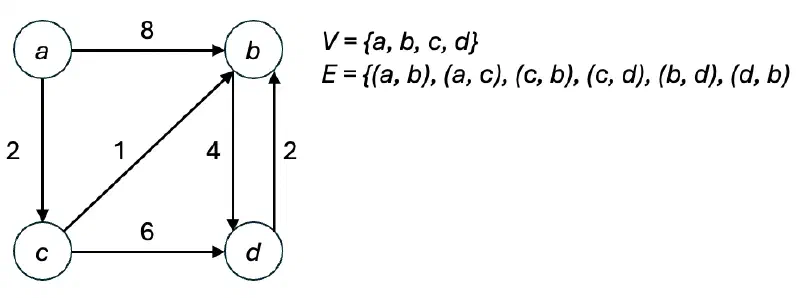
Ein gerichteter Graph $G = (V, E)$ besteht aus Knotenmenge $V$ (Vertices) und Kantenmenge $E \subseteq V \times V$ (Edges).
Ein ungerichteter Graph $G = (V, E)$ besteht aus Knotenmenge $V$ und Kantenmenge $E \subseteq P_2(V)$. Dabei sind $P_2(V)$ alle 2-elementigen Teilmengen von $V$.
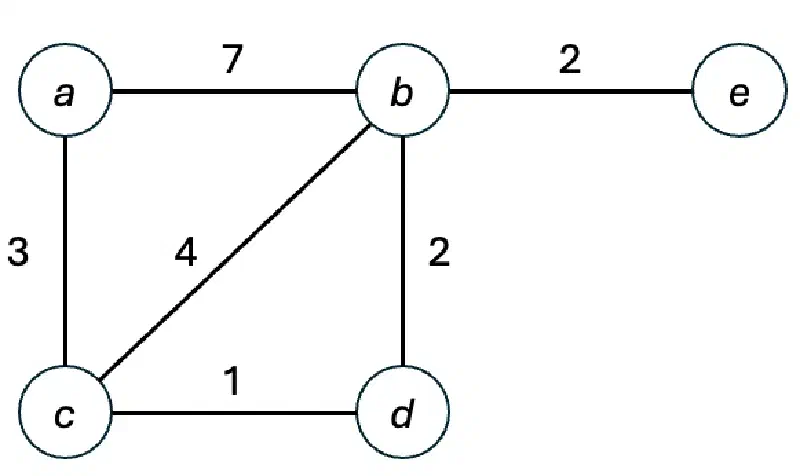
Kanten können gewichtet sein durch eine Kostenfunktion $c: E \rightarrow \mathbb{R}$. In vielen Anwendungen sind diese Kosten nicht-negativ (z. B. Entfernungen oder Zeiten). Sie modellieren Entfernungen, Zeitdauern oder sonstige Aufwände.
Mittels Graphen können binäre Beziehungen zwischen Objekten modelliert werden. Die Objekte werden durch die Knoten, die Beziehungen durch die Kanten abgebildet.
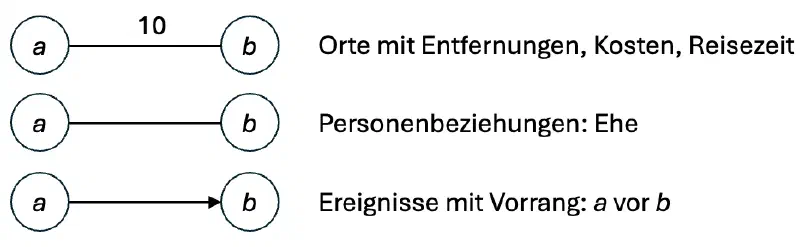
In der Graphentheorie existieren ein paar Begriffe, die man kennen sollte. Ich habe sie, um sie gleich zu visualisieren, in den folgenden zwei Skizzen notiert.
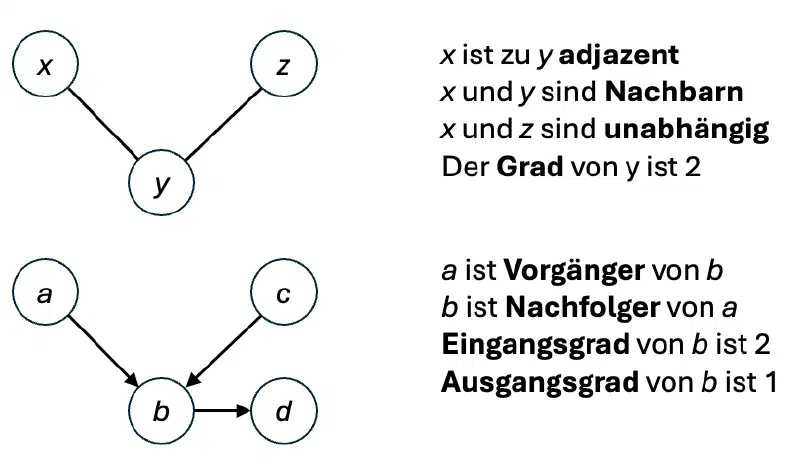
Wir nennen eine Kante $(x,y)$ inzident zum Knoten $x$ und zum Knoten $y$. Ein Weg ist eine Folge von Knoten $v_0, v_1, \dots, v_k$, sodass zwischen $v_{i-1}$ und $v_i$ jeweils eine Kante existiert. Bei einem Kreis gilt: $v_0 = v_k$.
Implementierung von Graphen
Es sei jedem Knoten ein eindeutiger Index zugeordnet. Damit können wir Graphen mit Arrays (und später Matrizen) abbilden. Bei nicht-numerischen Knotennamen benötigen wir eine schnelle Zuordnung von Namen zu Indizes (z. B. über eine Hash-Tabelle). Für den gerichteten Graphen (Abbildung 1.1{reference-type=“ref” reference=“fig:Gerichteter-Graph”}, Seite ) ergibt sich:
| Index | Knoten |
|---|---|
| 0 | $a$ |
| 1 | $b$ |
| 2 | $c$ |
| 3 | $d$ |
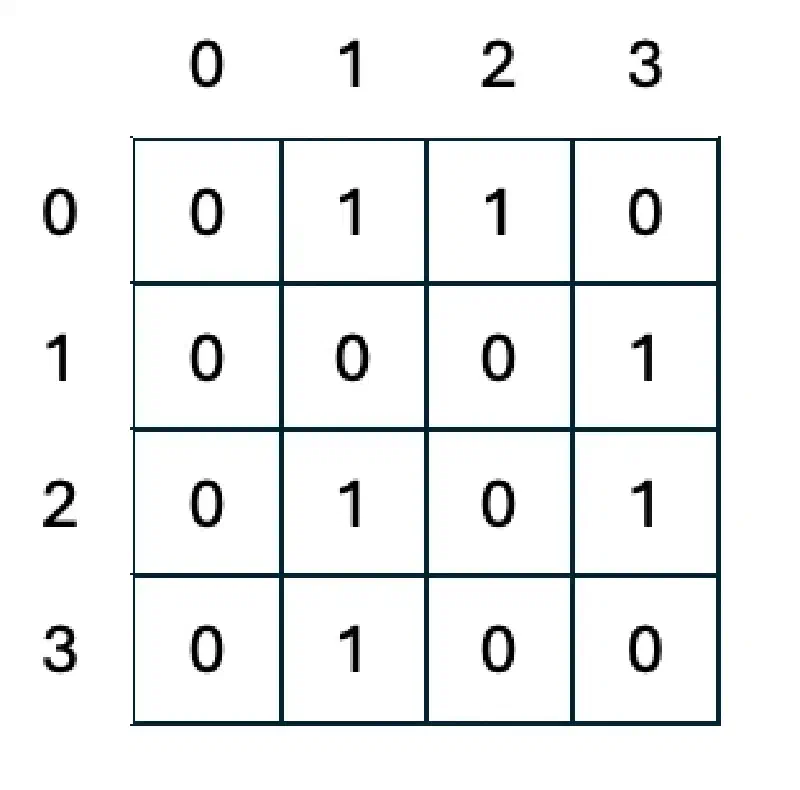
Implementierung durch Adjazenzmatrizen
Kanten ohne Bewertung:
Gerichtete Kanten mit Bewertung:
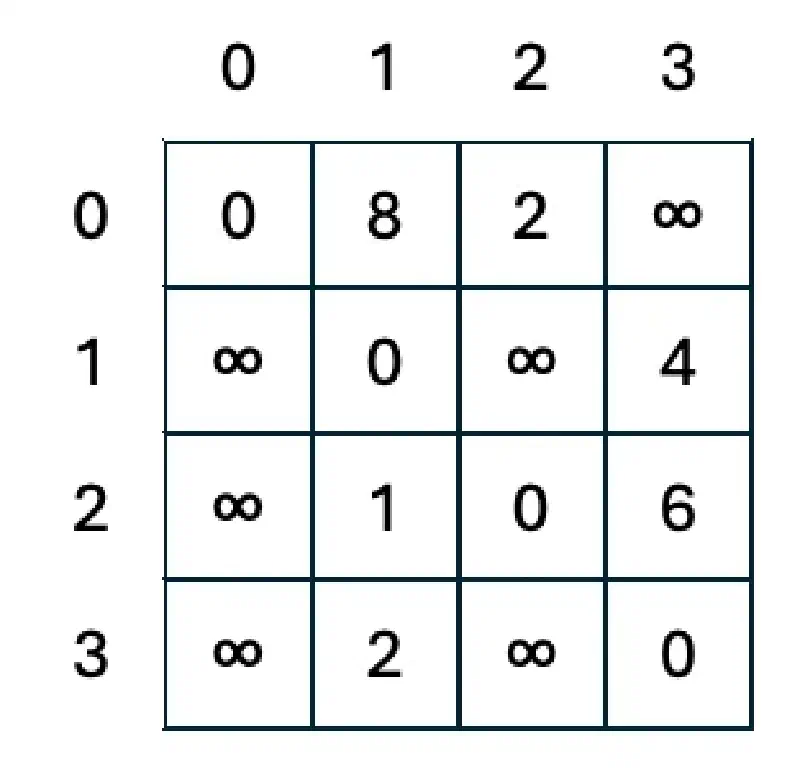
Eigenschaften von Adjazenzmatrizen:
- Speicherplatzbedarf $= \mathcal{O}(|V|^2)$
- Direkter Zugriff auf Kante $(i, j)$ in konstanter Zeit möglich.
- Kein effizientes Verarbeiten der Nachbarn eines Knotens.
- Sinnvoll bei dicht besetzten Graphen.
- Sinnvoll bei Algorithmen, die wahlfreien Zugriff auf eine Kante erfordern.
Implementierung gerichteter Graphen durch Adjazenzlisten
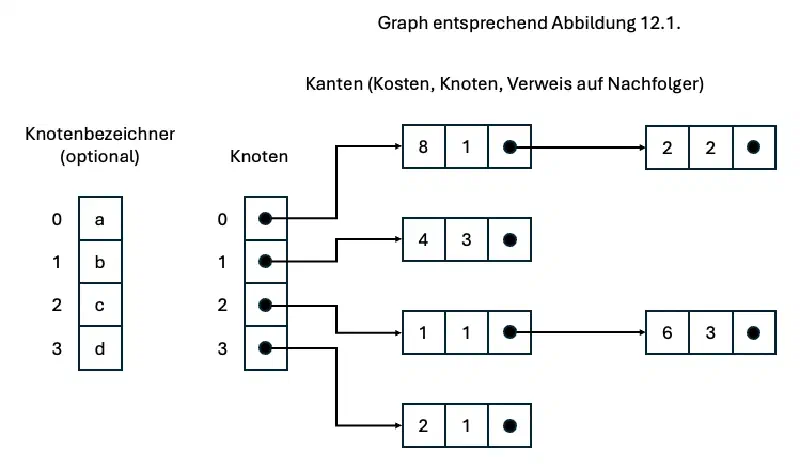
Wenn die Knoten des Graphen über ihren Index identifiziert werden, bietet sich zusätzlich zum Namens-Array (eine Hash-Tabelle als Hash-Map) ein Array von Integer-Listen an. Die an Position $i$ beginnende Liste enthält die Nachbarn von $i$, genauer gesagt, sie enthält die Indizes der Nachbarn von $i$. Für bewertete Graphen muss ein Listeneintrag innerhalb der $i$-ten Liste neben der Knoten-Nummer $j$ auch die Kosten der Kante $(i, j)$ enthalten. Für den gerichteten Graphen auf Seite ergibt sich dann das folgende Schema:
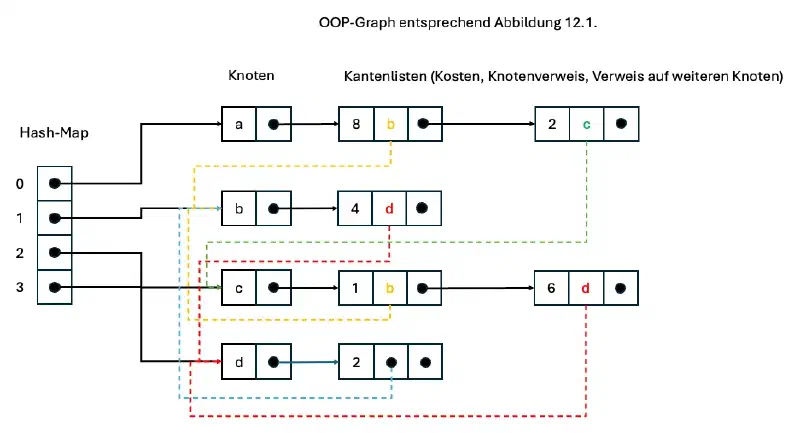
Eine objektorientierte Codierung modelliert die Knoten als Objekte, welche ihren Namen als String speichern und ihre Nachbarn als Kantenliste. Die Einträge der Kantenliste bestehen jeweils aus den Kosten der Kante und einem Verweis auf den Zielknoten, mit dem sie verbinden. Über ein assoziatives Array (implementiert als Hash-Map) gelangt man vom Namen eines Knotens zu seinem Objekt. Für den gerichteten Graphen auf Seite ergibt sich dann das folgende Schema:
Eigenschaften von Adjazenzlisten:
- Speicherplatzbedarf $= \mathcal{O}(|E|)$
- Kein effizienter Zugriff auf Kante $(x, y)$ möglich.
- Sinnvoll bei dünn besetzten Graphen.
- Sinnvoll bei Algorithmen, die gegeben ein Knoten $x$, dessen Nachbarn verarbeiten müssen.
Graphalgorithmen für Adjazenzmatrizen gerichteter Graphen
Die Klasse Floyd löst das all-pairs-shortest-path-Problem mit dem Algorithmus von Floyd. Für eine $(n × n)$-Ausgangsmatrix $C$ (Adjazenzmatrix) mit den Kantenkosten werden sukzessive die $(n × n)$-Matrizen $D^0, D^1, D_2, \dots, D_{n-1}$ (Distanzmatrizen) berechnet. Die Matrix $D^k$ enthält die Kosten der kürzesten Wege zwischen zwei Knoten $i$ und $j$, die als Zwischenknoten nur die Knoten $0, 1, 2, \dots, k$ verwenden. Setze $D^{-1} := C$ (Initialisierung der Kantenkosten). Dann lässt sich ${D^k}{i,j}$ errechnen durch das Minimum von $D{i,j}^{k-1}$ und $D_{i,k}^{k-1} + D_{k,j}^{k-1}$.
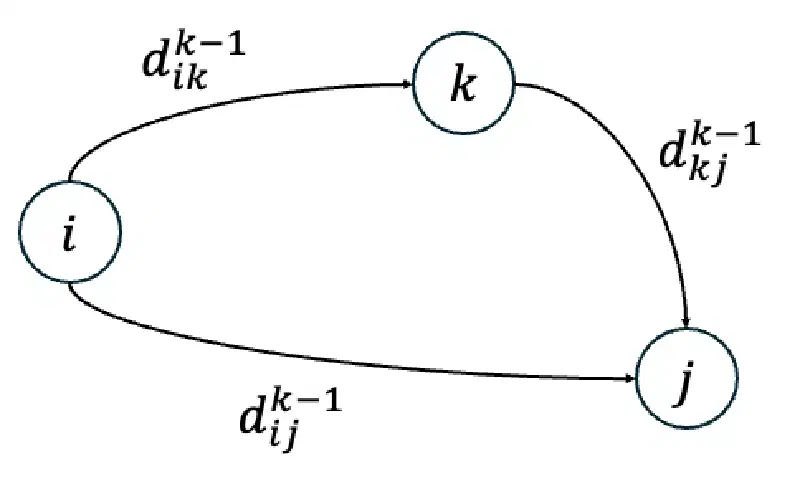
Beispiel
Für den Weg von Knoten $a$ nach $d$ haben wir:
- $a$ nach $b$ mit Kosten $8$ und $a$ nach $c$ mit Kosten $2$.
- Wegen $c$ nach $b$ mit Kosten $1$ udn $2 + 1 = 3 < 8$ ist der kürzeste Weg von $a$ nach $b$, den wir uns merken ($a$, $b$) mit Kosten $3$
- Von $b$ nach $d$ betragen die Kosten $4$. Also betragen die Kosten für ($a$, $d$) $3 + 4 = 7$.
Um auch die zugehörige Kantenfolge rekonstruieren zu können, wird parallel dazu eine Folge von $(n × n)$-Matrizen $P^0, P^1, P^2, \dots, P^{n-1}$ aufgebaut, die an Position $P_{i,j}^k$ den vorletzten Knoten auf dem kürzesten Weg von $i$ nach $j$ notiert, der nur über die Zwischenknoten $0, 1, 2, \dots, k$ läuft.
 1package graph;
 2
 3/**
 4 * Floyd-Algorithmus.
 5 */
 6public class Floyd {
 7    /**
 8     * Implementierung des Floyd-Algorithmus.
 9     *
10     * @param n Dimension der Adjazenzmatrix
11     * @param c Adjazenzmatrix mit Kosten (Eingabedaten)
12     * @param d errechnete Distanzmatrix  (Ausgabedaten)
13     * @param p errechnete Wegematrix     (Ausgabedaten)
14     */
15    public static void floyd(int n,          // Matrix-Dimension
16                             double[][] c,   // Adjazenzmatrix mit Kosten
17                             double[][] d,   // errechnete Distanzmatrix
18                             int   [][] p) { // errechnete Wegematrix
19        int i, j, k;                         // Laufvariablen
20        // Initialisierung
21        for (i = 0; i < n; i++) {            // für jede Zeile
22            for (j = 0; j < n; j++) {        // für jede Spalte
23                d[i][j] = c[i][j];           // initialisiere Kantenkosten
24                p[i][j] = i;                 // vorletzte Knoten
25            }
26        }                                    // D^-1
27        for (k = 0; k < n; k++) {            // für jede Knotenobergrenze
28            for (i = 0; i < n; i++) {        // für jede Zeile
29                for (j = 0; j < n; j++) {    // für jede Spalte
30                    // prüfe, ob Abkürzung möglich
31                    if (d[i][k] + d[k][j] < d[i][j]) {
32                        // wenn ja, notiere Abkürzung
33                        d[i][j] = d[i][k] + d[k][j];
34                        // und vorletzten Knoten
35                        p[i][j] = p[k][j];
36                    }
37                }
38            }
39        } // D^k
40    }
41}
Listing 12.1: graph.Floyd.java
Mit dem folgenden Treiber-Programm testen wir die Klasse Floyd.
 1import de.pakad.udemy.StdOut;
 2import graph.Floyd;
 3
 4/*
 5 * Testclient für die Klasse {@link graph.Floyd}.
 6 *
 7 * Ein Testgraph ist fix codiert.
 8 */
 9public class FloydTest {
10    final static double INF = Double.POSITIVE_INFINITY;
11
12    // Matrix ausgeben
13    private static void printMatrix(double[][] m) {
14        for (int i = 0; i < m.length; i++) {
15            for (int j = 0; j < m.length; j++) {
16                if (m[i][j] == INF) StdOut.printf("%6s", "INF");
17                else                StdOut.printf("%6.1f", m[i][j]);
18            }
19            StdOut.println();
20        }
21        StdOut.println();
22    }
23
24
25    // Hilfsmethode zur Pfad-Rekonstruktion
26    private static String printPath(int[][] p,
27                                    int i,
28                                    int j,
29                                    String path) {
30        if (i == j) return path + i;
31        else {
32            path = printPath(p, i, p[i][j], path) + "-";
33            return path + j;
34        }
35    }
36
37
38    // Pfad ausgeben
39    private static void printPathMatrix(int[][] p, double[][] d) {
40        String path = "";
41        for (int i = 0; i < p.length; i++) {
42            for (int j = 0; j < p[i].length; j++) {
43                if (d[i][j] == INF) StdOut.printf("%10s", "???");
44                else {
45                    path = printPath(p, i, j, "");
46                    StdOut.printf("%10s", path);
47                }
48            }
49            StdOut.println();
50        }
51    }
52
53    /**
54     * Hauptprogramm.
55     *
56     * @param args nicht genutzt
57     */
58    public static void main(String[] args) {
59        final int N = 4;
60        double[][] C = {{0.0, 8.0, 2.0, INF},     // Kostenmatrix
61                        {INF, 0.0, INF, 4.0},
62                        {INF, 1.0, 0.0, 6.0},
63                        {INF, 2.0, INF, 0.0}};
64
65        double[][] D = new double[N][N];          // errechnete Distanzmatrix
66        int   [][] P = new int   [N][N];          // vorletzter Knoten auf Weg
67
68        StdOut.println("Gegebene Kostenmatrix:");
69        printMatrix(C);
70
71        Floyd.floyd(N, C, D, P);
72        StdOut.println("Errechnete Distanzmatrix:");
73        printMatrix(D);
74
75        StdOut.println("Errechnete Wegematrix:");
76        printPathMatrix(P, D);
77    }
78}
Listing 12.2: FloydTest.java
Wir verwenden den Graphen in Abbildung 12.1 als Eingabe und erhalten die folgende Ausgabe.
Gegebene Kostenmatrix:
   0.0   8.0   2.0   INF
   INF   0.0   INF   4.0
   INF   1.0   0.0   6.0
   INF   2.0   INF   0.0

Errechnete Distanzmatrix:
   0.0   3.0   2.0   7.0
   INF   0.0   INF   4.0
   INF   1.0   0.0   5.0
   INF   2.0   INF   0.0

Errechnete Wegematrix:
         0     0-2-1       0-2   0-2-1-3
       ???         1       ???       1-3
       ???       2-1         2     2-1-3
       ???       3-1       ???         3
Der Weg von Knoten $a$ zu Knoten $d$ kostet 7 Einheiten und führt, so wie manuell ermittelt, über $c$ und $b$ nach $d$.
Der Floyd-Algorithmus hat eine Laufzeit von $\mathcal{O}(n^3)$. In den Zeilen 27 bis 39 von Floyd.java haben wir drei ineinander geschachtelte for-Schleifen, die jeweils $n$-mal durchlaufen werden. Das ist typisch für viele Graphalgorithmen.
Implementierung gerichteter Graphen durch Adjazenzlisten
Wir orientieren uns am Schema von Abbildung 12.6.
Jeder Knoten der Klasse Vertex enthält eine Liste von Kanten; jede Kante der Klasse Edge besteht aus Kosten und Zielknoten. Die Klasse Graph realisiert den Graph als Assoziation von Knotennamen und Knoten. Die Klasse GraphIO liest einen Graph aus einer Datei ein und zeigt seine Adjazenzlisten an. Die Klasse Result enthält Routinen zum Anzeigen einer Lösung, welche von dem jeweiligen Algorithmus in den Arbeitsvariablen (AlgoFields) der Knoten hinterlegt wurde. Die Klasse GraphTest (Seite, ), das Treiberprogramm, liest einen gerichteten Graphen ein und wendet verschiedene Graphalgorithmen darauf an.
Die Klasse Vertex
Die für verschiedene Algorithmen relevanten Arbeitsvariablen werden zentral in der Klasse Vertex implementiert. Sie sind seitens eines jeden Algorithmus zurückzusetzen. Das besorgt die Methode resetAlgoFields().
Ein Knoten wird hat einen Namen, und eine Liste der von ihm ausgehenden Kanten.
Knoten müssen miteinander verglichen werden können. Die dabei entscheidende Größe sind die in einem Knoten kumulierten Kosten. Ein Knoten implementiert daher die Schnittstelle Comparable.
1package graph;
2
3import adt.EnumList;
4import adt.List;
5import adt.SingleLinkedList;
6
7/**
8 * Repräsentation eines Knotens.
9 */
10public class Vertex implements Comparable<Vertex>{
11
12 private static final double INF = Double.POSITIVE_INFINITY;
13
14
15 private final String name; // Name es Knotens
16 private final List<Edge> edges; // Nachbarn als Knotenliste
17 /* AlgoFields - berechnete Datenfelder */
18 private int nr = -1; // Knotennummer
19 private int indegrees = 0; // Eingangsgrad
20 private double cost = INF; // Kosten für diesen Knoten
21 private boolean seen = false; // Besuchsstatus
22 private Vertex prev = null; // Vorgänger des Knotens
23
24 /**
25 * Konstruktor für einen Knoten.
26 *
27 * @param name Name des Knotens
28 * @throws IllegalArgumentException wenn Name leer oder null
29 */
30 public Vertex(String name) {
31 if (name == null || (name.trim()).isEmpty())
32 throw new IllegalArgumentException(
33 "Name darf nicht leer oder null sein.");
34
35 // Name des Knotens festlegen
36 this.name = name;
37 // initialisiere Nachbarschaftsliste
38 edges = new SingleLinkedList<Edge>();
39 }
40
41
42 /**
43 * Prüfung, ob Knoten in Nachbarschaftsliste.
44 *
45 * @param vertex zu prüfender Knoten
46 * @return {@code true}, wenn Knoten enthalten, sonst {@code false}
47 */
48 public boolean hasEdge(Vertex vertex) {
49 Edge e;
50 EnumList<Edge> iter = new EnumList<>(edges);
51 while (iter.hasMoreElements()) {
52 e = iter.nextElement();
53 if (e.getDest() == vertex) return true;
54 }
55 return false;
56 }
57
58
59 /**
60 * Vergleich von Knoten und anderem Knoten.
61 *
62 * @param other anderer Knoten
63 * @return <0, wenn Knoten kleiner anderem Knoten<br>
64 * >0, wenn Knoten größer anderem Knoten<br>
65 * 0, wenn Knoten gleich sind
66 */
67 @Override
68 public int compareTo(Vertex other) {
69 return Double.compare(this.cost, other.cost);
70 }
71
72
73 /**
74 * Namen des Knoten liefern.
75 *
76 * @return Knotenname
77 */
78 public String getName() { return name; }
79
80
81 /**
82 * Nummer des Knoten liefern.
83 *
84 * @return Knotennummer
85 */
86 public int getNr() { return nr; }
87
88
89 /**
90 * Setzen der Knotennummer.
91 *
92 * @param nr Knotennummer
93 * @throws IllegalArgumentException wenn Knotennummer negativ
94 */
95 public void setNr(int nr) {
96 if (nr < 0)
97 throw new IllegalArgumentException(
98 "Knoten kann nicht negativ sein.");
99 this.nr = nr;
100 }
101
102
103 /**
104 * Eingangsgrad des Knoten liefern.
105 *
106 * @return Eingangsgrad
107 */
108 public int getIndegrees() { return indegrees; }
109
110
111 /**
112 * Eingangsgrad des Knoten setzen.
113 *
114 * @param indegrees Eingangsgrad
115 * @throws IllegalArgumentException wenn Eingangsgrad kleiner als 0
116 */
117 public void setIndegrees(int indegrees) {
118 if (indegrees < 0)
119 throw new IllegalArgumentException(
120 "Eingangsgrad kann nicht negativ sein.");
121 this.indegrees = indegrees;
122 }
123
124
125 public void decIndegree() {
126 indegrees--;
127 }
128
129
130 public void incIndegrees() {
131 indegrees++;
132 }
133
134
135 /**
136 * Kosten/Distanz des Knotens liefern.
137 *
138 * @return Kosten/Distanz
139 */
140 public double getCost() { return cost; }
141
142
143 /**
144 * Setzen der Kosten/Distanz des Knotens.
145 *
146 * @param cost Kosten/Distanz
147 */
148 public void setCost(double cost) { this.cost = cost; }
149
150
151 /**
152 * Besuchsstatus liefern.
153 *
154 * @return Besuchsstatus
155 */
156 public boolean getSeen() { return seen; }
157
158
159 public void setSeen(boolean seen) {
160 this.seen = seen;
161 }
162
163
164 /**
165 * Vorgängerknoten liefern.
166 *
167 * @return Vorgängerknoten
168 */
169 public Vertex getPrev() { return prev; }
170
171
172 /**
173 * Vorgängerknoten setzen.
174 *
175 * @param prev Vorgängerknoten
176 */
177 public void setPrev(Vertex prev) {
178 this.prev = prev;
179 }
180
181
182 /**
183 * Rückgabe der Kantenliste.
184 *
185 * @return Kantenliste
186 */
187 public List<Edge> getEdges() {
188 return edges;
189 }
190
191
192 /**
193 * Hinzufügen einer Kante.
194 *
195 * @param edge Kante
196 * @throws IllegalArgumentException wenn Kante gleich null
197 */
198 public void addEdge(Edge edge) {
199 if (edge == null)
200 throw new IllegalArgumentException(
201 "Kante kann nicht null sein.");
202 edges.insert(edge);
203 }
204
205
206 /**
207 * Zurücksetzen der berechneten Arbeitsvariablen.
208 */
209 public void resetAlgoFields() {
210 nr = -1;
211 indegrees = 0;
212 cost = Double.POSITIVE_INFINITY;
213 seen = false;
214 prev = null;
215 }
216}
Listing 12.3: graph.Vertex.java
Die Klasse Edge
In einer Kante speichern wir den Zielknoten der Kante und die für die Zielerreichung anfälligen Kosten. Der Startknoten einer Kante ergibt sich aus der Modellierung der Knoten. Jeder Knoten verwaltet eine Liste der von ihm ausgehenden Kanten, sodass wir zu jeder Kante die entscheidenden Parameter kennen: Startknoten, Zielknoten, Kosten.
 1package graph;
 2
 3/**
 4 * Repräsentation einer Kante.
 5 */
 6public class Edge {
 7
 8    private final Vertex dest;     // Zielknoten der Kante
 9    private final double cost;     // Kosten der Kante
10
11    /**
12     * Konstruktor für eine Kante.
13     *
14     * @param dest Zielknoten
15     * @param cost Kosten
16     * @throws IllegalArgumentException falls Zielknoten null
17     */
18    public Edge(Vertex dest, double cost) {
19        if (dest == null)
20            throw new IllegalArgumentException(
21                "Knoten kann nicht null sein.");
22        this.dest = dest;
23        this.cost = cost;
24    }
25
26
27    /**
28     * Gibt den Zielknoten zurück.
29     *
30     * @return Zielknoten
31     */
32    public Vertex getDest() {
33        return dest;
34    }
35
36
37    /**
38     * Gibt die Kosten der Kante zurück.
39     *
40     * @return Kosten
41     */
42    public double getCost() {
43        return cost;
44    }
45}
Listing 12.4: graph.Edge.java
Die Klasse Graph
Die Klasse Graph verwaltet die Knoten eines Graphen mithilfe einer Hash-Tabelle. Schlüssel ist der Bezeichner eines Knotens, sein Name. Als jeweiliger Wert zu jedem Schlüssel, wird der entsprechende Knoten eingetragen.
Es sind zwei Methoden zum Finden eines Knotens im Graphen implementiert. Die Methode find() findet einen im Graphen angelegten Knoten und liefert ihn an den Aufrufer zurück. Wird der gesuchte Knoten nicht gefunden, wird null zurückgegeben. Die Methode getVertex() ist demgegenüber als sogenannte Factory-Methode implementiert. Das bedeutet: Wird ein Knoten gesucht und gefunden, wird er an den Aufrufer zurückgegeben. Wird der gesuchte Knoten jedoch nicht gefunden, wird er automatisch erzeugt. Der neu generierte Knoten wird an den Aufrufer zurückgegeben. – Das macht es leicht und effizient, Knoten im Graphen einzufügen. Doppelungen werden durch die als Hash-Map verwendete Hash-Tabelle automatisch unterbunden. Jeder Knotenbezeichner (und damit auch jeder Knoten) ist somit eindeutig.
 1package graph;
 2
 3import adt.ClosedHashTable;
 4
 5/**
 6 * Implementierung eines Graphen, basierend auf {@link Vertex}
 7 * und {@link Edge}.
 8 *
 9 * Der Graph wird als Hash-Map<String, Vertex> implementiert, d.h.
10 * als eine Hash-Tabelle mit Schlüssel vom Typ {@code String} und
11 * Werten vom Typ {@link Vertex}. Vertex-Objekte sind eindeutig pro
12 * Name.
13 */
14public class Graph {
15
16    private final ClosedHashTable<String, Vertex> graph;
17
18    /**
19     * Konstruktor für einen Graphen.
20     *
21     * @param size Größe/Mindestanzahl der Knoten
22     */
23    public Graph(int size) {
24        // prüfe die angegebene Größe der Hash-Tabelle
25        // - Die hier geprüfte Mindestgröße ist lediglich eine
26        //   "formale" Größe.
27        // - De facto muss die Tabelle groß genug sein, um alle
28        //   Knoten speichern zu können.
29        if (size < 1)
30            throw new IllegalArgumentException(
31                "Die Größe kann nicht kleiner 1 sein.");
32        graph = new ClosedHashTable<>(size);
33    }
34
35
36    /**
37     * Prüfung, ob Graph leer.
38     *
39     * @return {@code true}, wenn Graph leer, sonst {@code false}
40     */
41    public boolean empty() { return graph.empty(); }
42
43    /** Rückgabe eines (evtl. auch leeren) Arrays mit den Knoten
44     * des Graphen.
45     *
46     * @return Knoten-Array
47     */
48    public Vertex[] vertices() {
49        return graph.getValues(Vertex.class);
50    }
51
52
53    /**
54     * Liefert den Knoten mit dem Namen {@code name}.
55     *
56     * Wenn der gewünschte Knoten nicht vorhanden ist, wird er
57     * erzeugt und dem Graphen hinzugefügt.
58     *
59     * @param name Knotenname
60     * @return Knoten
61     */
62    public Vertex getVertex(String name) {
63        if (name == null || (name.trim()).isEmpty())
64            throw new IllegalArgumentException(
65                "Der Knotenname darf nicht leer oder null sein.");
66        Vertex v = graph.lookup(name);
67        if (v == null) {
68            v = new Vertex(name);
69            graph.insert(name, v);
70        }
71        return v;
72    }
73
74
75    /**
76     * Finden eines bestimmten Knoten.
77     *
78     * @param name Name des Knotens
79     * @return Knoten oder null, wenn nicht gefunden.
80     */
81    public Vertex find(String name) { return graph.lookup(name); }
82
83    public void addEdge(String source,
84                        String dest,
85                        double cost) {
86        if (source == null || (source.trim()).isEmpty() ||
87            dest == null || (dest.trim()).isEmpty())
88            throw new IllegalArgumentException(
89                "Quelle und Ziel dürfen nicht leer oder null sein.");
90        Vertex vSource = getVertex(source);
91        Vertex vDest = getVertex(dest);
92        vSource.addEdge(new Edge(vDest, cost));
93    }
94}
Listing 12.5: graph.Graph.java
Die Klasse GraphTest
Die Klasse GraphTest wird genutzt, um einen Graphen aus Datei einzulesen, Algorithmen auszuführen und die entsprechenden Ergebnisse auszugeben. Dazu bedient sich GraphTest verschiedener Hilfsklassen. Das sind die Klassen GraphIO um Graphen einlesen und ausgeben zu können. Die Klasse Result stellt verschiedene Ausgabe-Methoden bereits, die zum Teil spezifisch für bestimmte Algorithmen sind. Die Algorithmen selbst werden in jeweils einer eigenen Klasse implementiert. – So ist ein sauberes OOP-Design gewährleistet.
 1import de.pakad.udemy.StdErr;
 2import de.pakad.udemy.StdOut;
 3import graph.Dijkstra;
 4import graph.Graph;
 5import graph.GraphIO;
 6import graph.GraphTraverse;
 7import graph.Result;
 8import graph.TopoSort;
 9
10/**
11 * Testclient für Graphen.
12 */
13public class GraphTest {
14    /**
15     * Hauptprogramm.
16     *
17     * @param args <br>
18     * [0] - Größe der Hash-Tabelle<br>
19     * [1] - Dateiname
20     */
21    public static void main(String[] args) {
22        if (args.length < 2) {
23            StdErr.println("Usage: java GraphTest size filename");
24            System.exit(1);
25        }
26
27        int size = Integer.parseInt(args[0]);
28        Graph g = GraphIO.readGraph(size, args[1]);
29        GraphIO.printGraph(g);
30        StdOut.print("Tiefensuche (all) - ");
31        GraphTraverse.dfsAll(g);
32        Result.printTraverse(g);
33        StdOut.print("Breitensuche (Start Unterhemd): ");
34        GraphTraverse.bfsFromVertex(g, g.find("Unterhemd"));
35        Result.printTraverse(g);
36        TopoSort.sortGraph(g);
37        Result.printTopoSort(g);
38        Dijkstra.dijkstra(g, g.find("Unterhemd"));
39        Result.printPath(g, g.find("Mantel"));
40    }
41
42}
Listing 12.6: GraphTest.java
Gegeben sein folgender Graph kleidung.txt:
Unterhemd Pullover 0
Pullover Mantel 0
Unterhose Hose 0
Hose Mantel 0
Hose Schuhe 0
Socken Schuhe 0
Dann liefert GraphTest in der im Code vorgenommenen Konfiguration das folgende Ergebnis:
$ java GraphTest.java 10 data/kleidung.txt
Adjazenzlisten des Graphen:
(Unterhemd, Pullover) = 0.00
(Pullover, Mantel) = 0.00
(Socken, Schuhe) = 0.00
(Unterhose, Hose) = 0.00
(Hose, Schuhe) = 0.00   (Hose, Mantel) = 0.00

Tiefensuche (all) - Traversierungsreihenfolge:
  0 Schuhe
  1 Unterhemd
  2 Pullover
  4 Socken
  3 Mantel
  5 Unterhose
  6 Hose

Breitensuche (Start Unterhemd): Traversierungsreihenfolge:
  0 Unterhemd
  1 Pullover
  2 Mantel

Die Sortierung lautet:
  5 Schuhe
  0 Unterhemd
  3 Pullover
  1 Socken
  6 Mantel
  2 Unterhose
  4 Hose

Kosten 0.00:
Unterhemd -> Pullover -> Mantel
$ _
Die Klasse GraphIO trennt den Graphen sowie auch den Testclient von der Ein- und Ausgabe des originären Graphen.
 1package graph;
 2
 3import java.io.FileInputStream;
 4import adt.EnumList;
 5import adt.SingleLinkedList;
 6import de.pakad.udemy.StdErr;
 7import de.pakad.udemy.StdIn;
 8import de.pakad.udemy.StdOut;
 9/**
10 * Die Klasse {@code GraphIO} liest gerichtete Graphen ein
11 * und gibt sie auf der Standardausgabe aus.
12 */
13public class GraphIO {
14    /**
15     * Einlesen eines Graphen aus einer Datei.
16     * <p>
17     * Die Datei muss wie folgt aufgebaut sein:
18     * </p>
19     * <pre>
20     * source   destination  cost
21     * </pre>
22     * <p>
23     * Die Spalten sind durch Leerzeichen oder Tabulatoren zu trennen.
24     * </p>
25     * @param size Größe des Graphen
26     * @param filename Dateiname
27     * @return Graph
28     * @throws IllegalArgumentException wenn Größe kleiner als 1 oder
29     *                                  Dateiname fehlt
30     */
31    public static Graph readGraph(int size, String filename) {
32        if (filename == null || (filename.trim()).isEmpty())
33            throw new IllegalArgumentException(
34                "Dateiname darf nicht leer oder null sein.");
35        Graph g = new Graph(size);
36        try (FileInputStream in = new FileInputStream(filename)) {
37            StdIn.setInputStream(in);
38            while (StdIn.hasNextLine()) {
39                // Zeile anhand von Leerzeichen und/oder Tabs aufsplitten
40                String line = (StdIn.readLine()).trim();
41                if (!line.isEmpty()) {
42                    String[] parts = line.split("\\s+");
43                    if (parts.length == 3) {
44                        String source = parts[0];
45                        String dest = parts[1];
46                        double cost = Double.parseDouble(parts[2]);
47                        g.addEdge(source, dest, cost);
48                    }
49                }
50            }
51            StdIn.resetToSystemIn();
52        } catch(Exception e) {
53            StdErr.println(e);
54            System.exit(1);  // Fehlerstatus, Programmende
55        }
56        return g;
57    }
58
59
60    /**
61     * Ausgabe des Graphen {@code g} auf der Standardausgabe.
62     *
63     * Die Ausgabereihenfolge ist zufällig.
64     *
65     * @param g Graph
66     */
67    public static void printGraph(Graph g) {
68        StdOut.println("Adjazenzlisten des Graphen:");
69        Vertex[] v = g.vertices();
70        for (int i= 0; i < v.length; i++) {
71            SingleLinkedList<Edge> sl =
72                (SingleLinkedList<Edge>)v[i].getEdges();
73            if (!sl.empty()) {
74                EnumList<Edge> el = new EnumList<>(sl);
75                while (el.hasMoreElements()) {
76                    Edge e = el.nextElement();
77                    StdOut.printf("(%s, %s) = %.2f   ",
78                                    v[i].getName(),
79                                    (e.getDest().getName()),
80                                    e.getCost());
81                }
82                StdOut.println();
83            }
84        }
85        StdOut.println();
86    }
87}
Listing 12.7: graph.GraphIO.java
Die Klasse Result stellt verschiedene Ausgaberoutinen zur Verfügung, die je angewendeten Algorithmus zu wählen sind, um jeweils eine adäquate Ausgabe zu generieren. Auch hier wurde das Prinzip der Trennung von Verarbeitung und Ausgabe beachtet.
 1package graph;
 2
 3import de.pakad.udemy.StdOut;
 4
 5/**
 6 * Routinen zum Anzeigen der Lösungen, kodiert in den Arbeitsvariablen
 7 * von {@link Vertex}.
 8 */
 9public class Result {
10
11    /** Ausgabe einer Graphentraverse, gestützt auf den Knotennummern
12     *
13     * @param g Graph
14     */
15    public static void printTraverse(Graph g) {
16        StdOut.println("Traversierungsreihenfolge:");
17
18        Vertex[] v = g.vertices();
19        for (int i = 0; i < v.length; i++)
20            if (v[i].getSeen()) // nur besuchte Knoten ausgeben
21                StdOut.printf("%3d %s\n", v[i].getNr(), v[i].getName());
22
23        StdOut.println();
24    }
25
26
27    /**
28     * Ausgabe für einen topologisch sortierten Graphen.
29     *
30     * @param g Graph
31     */
32    public static void printTopoSort(Graph g) {
33        int i;
34        boolean success = true;
35        Vertex[] vertices = g.vertices();
36        for (i = 0; i < vertices.length; i++)
37            if (vertices[i].getNr() < 0)
38                success = false;
39        if (success) {
40            StdOut.println("Die Sortierung lautet:");
41            for (i = 0; i < vertices.length; i++)
42                StdOut.printf("%3d %s\n", vertices[i].getNr(), vertices[i].getName());
43        } else
44            StdOut.println(
45                "Graph kann nicht topologisch sortiert werden.");
46        StdOut.println();
47    }
48
49    /* Ausgabe kürzester Wege */
50
51    // private Hilfsmethode
52    private static void printPath(Vertex dest) {
53        if (dest.getPrev() != null) {
54            printPath(dest.getPrev());
55            IO.print(" -> ");
56        } IO.print(dest.getName());
57    }
58
59
60    /**
61     * Pfadausgabe kürzester Wege.
62     *
63     * @param g Graph
64     * @param v Startknoten
65     */
66    public static void printPath(Graph g, Vertex v) {
67        if (v.getCost() == Double.POSITIVE_INFINITY)
68            StdOut.println("%s ist nicht erreichbar");
69        else {
70            StdOut.printf("Kosten %.2f:\n", v.getCost());
71            printPath(v);
72        }
73    }
74}
Listing 12.8: graph.GraphResult.java
Unter der Voraussetzung, alle in GraphTest aufgerufenen Algorithmen sind implementiert und die Parameter im Code für den zu analysierenden Graphen gesetzt, wird die Klasse wie folgt aufgerufen. Das Beispiel bezieht sich auf den Beispiel-Graphen in Abbildung 12.1.
$ java GraphTest 10 data/graph1.txt
Adjazenzlisten des Graphen:
(d, b) = 2.00
(a, c) = 2.00   (a, b) = 8.00
(b, d) = 4.00
(c, d) = 6.00   (c, b) = 1.00

Traversierungsreihenfolge:
  0 d
  2 a
  1 b
  3 c

Graph kann nicht topologisch sortiert werden.

Kosten 7.00:
a -> c -> b -> d
$ _
Traversieren von Graphen
Tiefensuche
Eine Graphentraverse auf einem gerichteten Graphen lässt sich beispielweise durch eine rekursiv organisierte Tiefensuche implementieren, wobei die Nummern der Knoten in der Reihenfolge vergeben werden, in der sie besucht werden. Dabei wird greedy vorgegangen. D. h., zuerst in die Tiefe, danach in die Breite. Bei nicht zusammenhängenden Graphen muss dazu die Suche mehrfach gestartet werden.
Ich habe für die Implementierung der Tiefensuche einen rekursiven Algorithmus verwendet.
Breitensuche
Die Breitensuche in einem gerichteten Graphen besucht Knoten schichtweise, ausgehend von einem Startknoten, indem sie Warteschlangen nutzt, um Nachfolger zu verarbeiten.
 1package graph;
 2
 3import adt.EnumList;
 4import adt.ReferenceQueue;
 5/**
 6 * Graph-Traversen: Breiten- und Tiefensuche
 7 */
 8public class GraphTraverse {
 9    private static int id;  // Variable zum Nummerieren
10
11    // Knoten nach dem Prinzip der Tiefensuche besuchen.
12    //
13    // Bei Besuch: 1. Nummer vergeben, 2. besucht markieren
14    private static void visit(Vertex v) {
15        v.setNr(id++);                     // nächste Nummer
16        v.setSeen(true);                   // markiere als besucht
17        // Enumeration der Kantenliste
18        EnumList<Edge> edges = new EnumList<>(v.getEdges());
19        while (edges.hasMoreElements()) {  // für jede Kante ...
20            // Nachbarknoten ermitteln
21            Vertex vertex = (edges.nextElement()).getDest();
22            // wenn nicht besucht
23            if (!vertex.getSeen())
24                // dann besuchen
25                visit(vertex);
26            // bereits besucht = Basisfall -> keine weitere Rekursion
27        }
28    }
29
30
31    /**
32     * Rekursive Tiefensuche.
33     *
34     * Die Knotennummern werden in der Reihenfolge vergeben, in der
35     * sie besucht werden. Bei nicht zusammenhängenden Graphen muss
36     * dazu die Suche mehrfach gestartet werden.
37     *
38     * @param g Graph
39     */
40    public static void dfsAll(Graph g) {
41        int i;                             // Laufvariable
42        id = 0;                            // Zähler initialisieren
43        Vertex[] vertices = g.vertices();  // Knotenliste holen
44        // alle Knoten als nicht besucht markieren
45        for (i = 0; i < vertices.length; i++)
46            vertices[i].resetAlgoFields();
47
48        // alle Knoten besuchen und, wenn noch nicht besucht, markieren
49        for (i = 0; i < vertices.length; i++)
50            if (!vertices[i].getSeen())
51                visit(vertices[i]);
52    }
53
54
55    /**
56     * Breitensuche.
57     *
58     * Die Knotennummern werden in der Reihenfolge vergeben.
59     *
60     * @param g Graph
61     * @param start Startknoten
62     */
63    public static void bfsFromVertex(Graph g, Vertex start) {
64        ReferenceQueue<Vertex> q = new ReferenceQueue<>();
65        int i;                             // Laufvariable
66        id = 0;                            // Zähler initialisieren
67        Vertex[] vertices = g.vertices();  // Knotenliste holen
68
69        // alle Knoten als nicht besucht markieren
70        for (i = 0; i < vertices.length; i++)
71            vertices[i].resetAlgoFields();
72
73
74        q.enqueue(start);
75        while (!q.empty()) {
76            Vertex vertex = q.dequeue();
77            if (vertex.getSeen()) continue;
78
79            vertex.setSeen(true);
80            vertex.setNr(id++);
81
82            EnumList<Edge> eList = new EnumList<>(vertex.getEdges());
83            while (eList.hasMoreElements()) {
84                Edge edge = (eList.nextElement());
85                Vertex neighbour = edge.getDest();
86                q.enqueue(neighbour);
87            }
88        }
89    }
90}
Listing 12.9: graph.GraphTraverse.java
Beispielsitzung für den Graphen breitensuche.txt:
$ java GraphTest 10 data/breitensuche.txt
Adjazenzlisten des Graphen:
(a, c) = 0.00   (a, b) = 0.00
(b, e) = 0.00   (b, d) = 0.00
(c, g) = 0.00   (c, f) = 0.00

Tiefensuche (all) - Traversierungsreihenfolge:
  0 d
  1 e
  2 f
  3 g
  4 a
  6 b
  5 c

Breitensuche (Start a): Traversierungsreihenfolge:
  6 d
  5 e
  4 f
  3 g
  0 a
  2 b
  1 c

  $ _
Topologisches Sortieren
Das Problem des topologischen Sortierens auf einem gerichteten Graphen besteht darin, eine Knoten-Nummerierung $f : V \rightarrow \mathbb{N}$ zu finden, die mit den Kantenrichtungen kompatibel ist, d. h. $(x, y) \in E \Rightarrow f (x) < f (y)$.
Begonnen wird die Nummerierung bei einem Knoten mit Eingangsgrad $0$ (der die erste Nummer erhalten kann).
Sei $x$ der Knoten, der zuletzt nummeriert wurde. Dann werden nun die von $x$ ausgehenden Kanten (virtuell) entfernt und somit die (virtuellen) Eingangsgrade der von ihm erreichbaren Knoten vermindert. Verwendet wird dabei eine Schlange, welche solche Knoten speichert, deren virtueller Eingangsgrad im Laufe der Berechnung inzwischen auf $0$ gesunken ist und daher für die nächste zu vergebene Nummer infrage kommt. Auf diese Weise wird verhindert, dass immer wieder nach einem Knoten mit Eingangsgrad $0$ gesucht werden muss.
Am einfachsten kann man sich das topologische Sortieren anhand des Anziehens vorstellen. Das topologische Sortieren bringt abhängige Knoten, z. B. Vorgänge des Anziehens, in eine Reihenfolge.
Gegeben sei der folgende Graph. Die Kosten einer Kante betragen hier jeweils $0.0$:
Unterhemd   Pullover    0.0
Pullover    Mantel      0.0
Unterhose   Hose        0.0
Hose        Mantel      0.0
Hose        Schuhe      0.0
Socken      Schuhe      0.0
Das Unterhemd ist vor dem Pullover anzuziehen. Die Unterhose muss der Hose vorangehen. Ob Sie aber erst die Unterhose oder das Unterhemd anziehen, ist Ihrem persönlichen Gusto überlassen.
 1package graph;
 2
 3import adt.EnumList;
 4import adt.Queue;
 5import adt.ReferenceQueue;
 6
 7/**
 8 * Topologisches Sortieren.
 9 */
10public class TopoSort {
11    /**
12     * Graph {@code g} topologisch sortieren.
13     *
14     * @param g Graph
15     */
16    public static void sortGraph(Graph g) {
17        // Initialisierung
18        int i;
19        Vertex[] vertices = g.vertices();
20        for (i = 0; i < vertices.length; i++)
21            vertices[i].resetAlgoFields();
22
23        // für alle Knoten ...
24        for (i = 0; i < vertices.length; i++) {
25            // die Kanten ermitteln
26            EnumList<Edge> edges =
27                new EnumList<>(vertices[i].getEdges());
28            // für jede Kante ...
29            while (edges.hasMoreElements()) {
30                // die Nachbarknoten ermitteln
31                Vertex vertex = (edges.nextElement()).getDest();
32                // und den jeweiligen Eingangsgrad um 1 erhöhen (zählen)
33                int aktIndegree = vertex.getIndegrees();
34                vertex.setIndegrees(aktIndegree+1);
35            }
36        }
37
38        Queue<Vertex> l = new ReferenceQueue<>();
39        // Schlange von Knoten mit Eingangsgrad 0
40        for (i = 0; i < vertices.length; i++) {
41            // jeden Knoten mit Eingangsgrad 0 anfügen
42            if (vertices[i].getIndegrees() == 0)
43                l.enqueue(vertices[i]);
44        }
45
46        int id = 0;
47        while (!l.empty()) {
48            Vertex v = l.dequeue();
49            v.setNr(id++);
50            EnumList<Edge> edges = new EnumList<>(v.getEdges());
51            while (edges.hasMoreElements()) {
52                Edge e = edges.nextElement();
53                Vertex w = e.getDest();
54                w.setIndegrees(w.getIndegrees() - 1);
55                if (w.getIndegrees() == 0)
56                    l.enqueue(w);
57            }
58        }
59    }
60}
Listing 12.10: graph.GraphTopoSort.java
Topologisches Sortieren ist nur für Graphen ohne Zyklen definiert.
Während das topologische Sortieren Abhängigkeiten berücksichtigt, suchen wir im nächsten Abschnitt nach optimalen Wegen.
Kürzeste Wege
Das Problem der kürzesten Wege besteht darin, in einem gerichteten, mit nicht-negativen Kosten gewichteten Graphen die kürzesten Wege von einem Startknoten zu allen anderen Knoten auszurechnen (single-source-shortest-paths).
Der Algorithmus von Dijkstra verwendet dabei eine Priority-Queue (siehe Seite ), welche die vorläufigen Kosten eines Weges vom Startknoten zu einem Zielknoten in Form eines mit diesen Kosten bewerteten Knotens speichert.
Zu Beginn haben alle Knoten die vorläufigen Kosten $\infty$; der Startknoten erhält die vorläufigen Kosten $0.0$. Jeweils der billigste Knoten aus der Menge der vorläufig markierten Knoten kann seine endgültigen Kosten erhalten und fügt ggf. die durch ihn verbilligten vorläufigen Kosten zu seinen Nachbarn in Form von Knoten in die Schlange ein. Weil die Priority-Queue die Kosten der in ihr gespeicherten Wege nicht verringern kann, werden Wege, deren Kosten sich verringert haben, als neue Knoten eingefügt und die Schlange enthält daher für manche Knoten Mehrfacheinträge mit unterschiedlich teuren Kosten. Solche Einträge können nach dem Entfernen aus der Schlange ignoriert werden, wenn der Knoten inzwischen als besucht (seen) markiert wurde.
 1package graph;
 2
 3import adt.EnumList;
 4import adt.ListPriorityQueue;
 5
 6/**
 7 * Kürzeste Wege nach Dijkstra.
 8 *
 9 * <p>Es sind nur nicht-negative Kantenkosten zulässig.</p>
10 */
11public class Dijkstra {
12
13    /**
14     * Dijkstra-Algorithmus auf Graph {@code g} für den Startknoten
15     * {@code start} ausführen (Kürzeste Wege ermitteln).
16     *
17     * @param g Graph
18     * @param start Startknoten
19     */
20    public static void dijkstra(Graph g, Vertex start) {
21        // Prioritätswarteschlange zum Verwalten der günstigsten Knoten
22        ListPriorityQueue<Vertex> pq = new ListPriorityQueue<>();
23        int i;
24
25        // Reset der Arbeitsdaten
26        Vertex[] vertices = g.vertices();
27        for (i = 0; i< vertices.length; i++)
28            vertices[i].resetAlgoFields();
29
30        start.setCost(0.0);                 // Startknoten hat Kosten 0.0
31        pq.enqueue(start);                  // erster Eintrag in PQ
32
33        while (!pq.empty()) {               // solange noch Einträge in PQ
34            Vertex vertex = pq.dequeue();   // billigster Knoten
35            if (vertex.getSeen()) continue; // bearbeitet? -> ignorieren
36            vertex.setSeen(true);           // als bearbeitet markieren
37
38            EnumList<Edge> eList = new EnumList<>(vertex.getEdges());
39            // für jede Nachbarkante edge nach neighbour
40            while (eList.hasMoreElements()) {
41                Edge edge = (eList.nextElement());
42                Vertex neighbour = edge.getDest();  // besorge Zielknoten
43                double cost = edge.getCost();       // besorge Kosten
44                if (cost < 0)
45                    throw new RuntimeException("negativ");
46                // falls Vergünstigung möglich, dann Kosten aktualisieren
47                // und verursachenden Vorgänger notieren
48                if (neighbour.getCost() > vertex.getCost() + cost) {
49                    neighbour.setCost(vertex.getCost() + cost);
50                    neighbour.setPrev(vertex);
51                    pq.enqueue(neighbour);  // neuer Eintrag in PQ
52                }
53            }
54        }
55    }
56}
Listing 12.11: graph.Dijkstra.java
Wenn Sie den Code der Methode dijkstra() aufmerksam lesen, wird Ihnen auffallen, dass ein Nachbarknoten bei einer Kostenaktualisierung über pq.enqueue(neighbour) einfach erneut in die Warteschlange eingefügt wird. Warum lösen wir das so und ändern nicht einfach das bestehende Element in der Schlange?
Der Grund liegt in der Funktionsweise unserer selbst implementierten ListPriorityQueue. Sie ist beim Einfügen eines Elements intern bereits nach Priorität sortiert (Listing 10.16). Wenn wir nun im Nachhinein die Kosten (cost) eines Knotens ändern, der bereits auf einem Speicherplatz in der Liste liegt, merkt die Liste davon nichts — sie sortiert sich nicht automatisch neu.
Um den Knoten an die seiner neuen Priorität entsprechende, korrekte Position zu befördern, müssten wir die Liste aufwendig durchsuchen, das Element entfernen und neu einsortieren. In der Praxis der Informatik nutzt man daher oft diesen eleganteren Trick: Wir werfen den Knoten mit seinen neuen, günstigeren Kosten einfach frisch oben drauf. Das führt dazu, dass manche Knoten als „Karteileichen" mehrfach in der Queue existieren. Das ist jedoch kein Problem für unseren Algorithmus: Sobald die günstigste Variante des Knotens aus der Queue geholt und verarbeitet wurde, wird sie über vertex.setSeen(true) markiert. Erreichen wir später die ältere, teurere Kopie desselben Knotens, wird sie in Zeile 35 über die Anweisung if (vertex.getSeen()) continue; blitzschnell und völlig lautlos übersprungen.
Zum Testen habe ich den Klassiker, ein Streckennetz, gewählt.
$ java GraphTest 30 data/streckennetz.txt
Adjazenzlisten des Graphen:
(Bremen, Osnabrück) = 126.00   (Bremen, Hamburg) = 121.00
...
Kosten 536.00:
Osnabrück -> Bremen -> Hamburg -> Berlin
$ _
Zusammenfassung Graphen
Graphen bieten ein extrem weites und spannendes Betätigungsfeld. In diesem Kapitel haben wir uns auf ausgewählte Algorithmen auf gerichteten Graphen konzentriert, die in der Praxis häufig eingesetzt werden.
Die objektorientierte Modellierung ungerichteter Graphen unterscheidet sich hiervon nur in Details. Kanten können in beide Richtungen traversiert werden, und anstelle von Kantenkosten wird häufig lediglich die Anzahl der durchlaufenen Kanten betrachtet.
Versuchen Sie eigene Graphen aufzustellen und Algorithmen zu entwickeln, die eine bestimmte Fragestellung beantworten. Denken Sie dabei zum Beispiel an die Reihenfolge von Vorgängen in der Projektplanung, die jeweiligen Vorgangsdauern und Abhängigkeiten. Ein Projektplan bietet zahlreiche Möglichkeiten mithilfe eines Graphen modelliert und verarbeitet zu werden. Diese und ähnliche Aufgaben sind typisch in der Graphentheorie.
Graphen bilden damit den Übergang von grundlegenden Datenstrukturen zu anspruchsvolleren algorithmischen Fragestellungen.
Wichtig: Anhand der besprochenen Beispiele haben Sie vielfältige Einsatzmöglichkeiten für die ADTs praktisch erleben können. ADTs gehören zu den Standard-Werkzeugen eines jeden Informatikers.