Abstrakte Datentypen
Bisher haben wir konkrete Klassen modelliert, wie Date, Person oder Student. Dabei haben Sie gelernt, dass wir mithilfe der OOP, im Gegensatz zu Arrays, Strukturen modellieren, die nicht nur aus einem Datentypen bestehen, wie beispielsweise ein Array von ganzen Zahlen. Mithilfe von Klassen können wir Dinge modellieren, die verschiedene Datentypen in einer Struktur zusammenfassen. So haben wir Vorname, Nachname und Geburtsdatum als beschreibende Attribute in der Klasse Person zusammengefasst. Dabei können wir nicht nur auf primitive Datentypen zurückgreifen, wir können sämtliche in Java verfügbaren Datentypen nutzen, um den Gegenstand unseres Interesses zu modellieren. Insbesondere können wir dazu auch Klassen nutzen, die wir selbst implementiert haben, wie Date in Person. Auf diese Weise gelingt es uns, Beziehungen zwischen Objekten auszudrücken.
Nun wenden wir uns der Frage zu, welche Eigenschaften und Operationen eine Datenstruktur haben muss, unabhängig von ihrer internen Implementierung.
Ein abstrakter Datentyp (ADT) ist eine Datenstruktur zusammen mit darauf definierten Operationen.
Java unterstützt den Umgang mit ADTs durch die Bereitstellung von Klassen und Interfaces.
Interfaces enthalten nur Methodenköpfe und Konstanten. Ein Interface stellt eine Schnittstelle dar und legt damit die Funktionalität seiner Methoden fest, ohne diese zu implementieren. Dies geschieht in einer beliebigen Klasse, die dies zuerst in einer implements-Klausel deklariert und die dann eine Implementation aller Methoden des Interface bereitstellen muss.
Die implements-Klausel etabliert damit quasi einen Vertrag zwischen einem Interface und der Klasse, die verspricht, dieses Interface zu implementieren. Der Nutzer einer Klasse darf dann darauf vertrauen, dass die Klasse diesen Vertrag einhält und sich der Methoden, die das Interface deklariert, bedienen.
Verwendet werden kann ein Interface als Typdeklaration auch ohne Kenntnis der konkreten Implementierung.
Wir betrachten die Datenstrukturen Liste (List), Schlange (Queue), Kellerspeicher (Stack) und Baum (Tree).
Diese Datenstrukturen deklarieren jeweils eine Menge von Operationen, die für den Gebrauch der jeweiligen Datenstruktur typisch sind. Diese Operationen deklarieren wir in Form von Interfaces. Verschiedene Klassen stellen dann konkrete Implementierungen dieser Interfaces dar.
Die Auswahl der Datenstrukturen spiegelt grundsätzliche Strukturen wider, die in der Informatik eine zentrale Rolle spielen. Anhand von Beispielanwendungen werden wir uns verschiedene Einsatzzwecke ansehen und implementieren.
List
Definition: Eine Liste (engl. List) ist eine (ggf. leere) Folge von Elementen zusammen mit einem (ggf. undefinierten) aktuellen Element.
Schnittstelle des ADT List
| Methode | Objekte | Ergebnis | Beschreibung | |
|---|---|---|---|---|
empty() |
Liste | → | boolean | true, wenn Liste leer |
endpos() |
Liste | → | boolean | true, wenn Liste abgearbeitet |
reset() |
Liste | → | erstes Listenelement wird aktuelles | |
forward() |
Liste | → | nächstes Listenelement wird aktuelles | |
content() |
Liste | → | Objekt | liefert Inhalt des aktuellen Elements |
insert() |
Liste × Objekt | → | fügt neues Element vor aktuellem ein | |
delete() |
Liste | → | löscht das aktuelle Element |
Die Ankündigung einer Schnittstelle verwendet das Schlüsselwort interface. Das Interface definiert eine generische Liste. Die Liste kann grundsätzlich Elemente beliebigen Datentyps beinhalten. Jedoch soll der Datentyp festgelegt und vom Compiler geprüft werden können. <T> ist der Platzhalter für einen beliebigen Datentypen.
Bezüglich der Methoden, die von einer späteren Implementierung erwartet werden, werden lediglich die Methodenköpfe notiert.
package adt;

/**
 * Interface für den generischen ADT {@code List}.
 *
 * @param <T> Datentyp
 */
public interface List<T> {
    /**
     * Prüfung, ob Liste leer.
     *
     * @return {@code true}, wenn Liste leer, sonst {@code false}
     */
    public boolean empty();
    /**
     * Prüfung, ob Liste am Ende.
     *
     * @return {@code true}, wenn Liste am Ende, sonst {@code false}
     */
    public boolean endpos();
    /**
     * An den Anfang der Liste rücken.
     */
    public void reset();
    /**
     * Eine Position in der Liste weiter rücken.
     */
    public void forward();
    /**
     * Wert des aktuellen Listenelements liefern.
     *
     * @return Wert
     */
    public T content();
    /**
     * Wert ({@code obj}) vor dem aktuellen Listenelement einfügen.
     * Eingefügtes Element wird aktuelles Listenelement.
     *
     * @param obj Wert
     */
    public void insert(T obj);
    /**
     * Aktuelles Element aus Liste entfernen.
     */
    public void delete();
}
Konzept zur Implementierung einer einfach verketteten Liste
Bei einer einfach verketteten Liste besitzt ein Element eine Nutzlast, einen Wert beliebigen Datentyps, und einen Verweis auf das nächste Listenelement der Liste. Der Verweis des letzten Listenelements ist null.
Die Verwaltungsstruktur der einfach verketteten Liste hat zwei Attribute. Das sind eine Referenz auf den Listenanfang und das Element, welches vor dem aktuellen Element steht. - Es gibt hiervon abweichende Implementierungen.
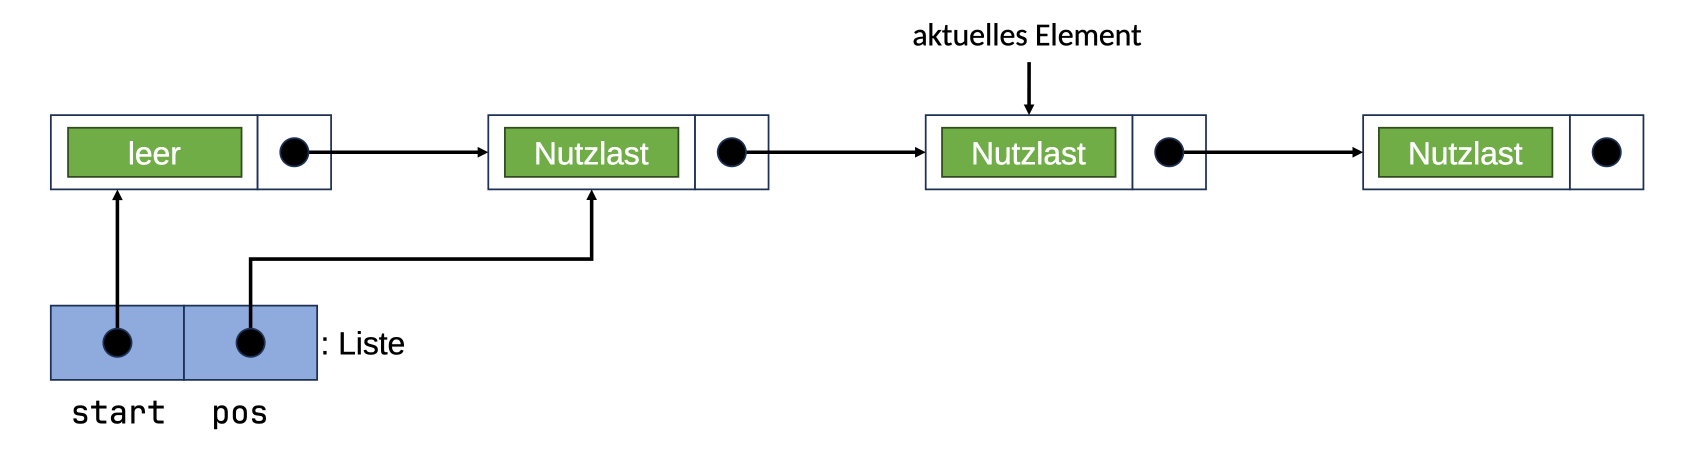
Der Nutzer einer Liste braucht von diesen internen Implementierungsdetails nichts zu wissen. Wir implementieren den Datentyp des erforderlichen Listenelements daher als innere Klasse von SingleLinkedList. Das ist die Listenimplementierung, die wir hier realisieren wollen.
package adt;

/**
 * {@code SingleLinkedList} implementiert eine einfach verkettete
 * generische Liste ({@link List}).
 *
 * @param <T> Datentyp
 */
public class SingleLinkedList<T> implements List<T> {

    private class Element {
        private T content;
        private Element next;
    }

    private final Element start;  // Zeiger auf Listenanfang
    private Element pos;          // Zeiger auf aktuellen Listeneintrag

    /** Konstruktor für eine leere Liste. */
    public SingleLinkedList() {
        pos = start = new Element();
        start.next = null;
    }

    /**
     * Prüfung, ob Liste leer.
     *
     * @return {@code true}, wenn Liste leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return start.next == null;
    }

    /**
     * Prüfung, ob Liste am Ende.
     *
     * @return {@code true}, wenn Liste am Ende, sonst {@code false}
     */
    @Override
    public boolean endpos() {
        return pos.next == null;
    }

    /**
     * An den Anfang der Liste rücken.
     */
    @Override
    public void reset() {
        pos = start;
    }

    /**
     * Eine Position in der Liste weiter rücken.
     *
     * @throws RuntimeException Ende der Liste
     */
    @Override
    public void forward() {
        if (endpos())
            throw new RuntimeException("Ende der Liste.");
        pos = pos.next;
    }

    /**
     * Inhalt des aktuellen Listenelements liefern.
     *
     * @throws RuntimeException Ende der Liste
     * @return Inhalt
     */
    @Override
    public T content() {
        if (endpos())
            throw new RuntimeException("Ende der Liste.");
        return pos.next.content;
    }

    /**
     * Element ({@code obj}) vor dem aktuellen Listenelement einfügen.
     * Eingefügtes Element wird aktuelles Listenelement.
     *
     * @param obj Inhalt
     */
    @Override
    public void insert(T obj) {
        Element tmp = new Element();
        tmp.content = obj;
        tmp.next = pos.next;
        pos.next = tmp;
    }

    /**
     * Aktuelles Element aus Liste entfernen.
     *
     * @throws RuntimeException Ende der Liste
     */
    @Override
    public void delete() {
        if (endpos())
            throw new RuntimeException("Ende der Liste.");
        pos.next = pos.next.next;
    }

    /**
     * Ausgabe der Liste als Zeichenkette.
     *
     * @return Zeichenkettendarstellung der Liste
     */
    @Override
    public String toString() {
        StringBuilder s = new StringBuilder();
        Element index = start;
        s.append('[');
        while (index.next != null) {
            s = s.append(index.next.content);
            s = s.append(", ");
            index = index.next;
        }
        s.deleteCharAt(s.length() - 1);  // letztes Leerzeichen löschen
        s.deleteCharAt(s.length() - 1);  // letztes Komma löschen
        s.append(']');
        return s.toString();
    }
}
Die Liste kann sich selbst darstellen. Das ist keine Standardfunktionalität einer Liste, weshalb sie auch nicht im Listen-Interface aufgeführt ist.
import adt.List;
import adt.SingleLinkedList;
import StdLib.StdOut;
import oop.Date;
import oop.Student;

/**
 * Einfacher Testclient für {@link adt.List} und {@code adt.SingleLinkedList}.
 */
public class SingleLinkedListTest {
    public static void main(String[] args) {

        Student s;                                   // Student
        List<Student> l = new SingleLinkedList<>();  // Liste von Studenten

        // neuen Studenten erzeugen und am Listenende anfügen
        s = new Student("Wilhelm", "Wulf", new Date(13, 10, 2006),
                        "BWL");
        l.insert(s); l.forward();

        // neuen Studenten erzeugen und am Listenende anfügen
        s = new Student("Sabine", "Kittler", new Date(3, 4, 2006),
                        "BWL");
        l.insert(s); l.forward();

        // neuen Studenten erzeugen und am Listenende anfügen
        s = new Student("Wolfgang", "Bauer", new Date(2, 1, 2005),
                        "Informatik");
        l.insert(s); l.forward();

        // neuen Studenten erzeugen und am Listenende anfügen
        s = new Student("Viola", "Sauer", new Date(10, 12, 2005),
                        "Rechtswissenschaften");
        l.insert(s);

        StdOut.println(l);

        // Liste auf Anfang und alle Elemente ausgeben
        l.reset();
        while (!l.endpos()) {
            StdOut.println(l.content());
            l.forward();
        }

        // Liste auf Anfang und alle Elemente löschen
        l.reset();
        while (!l.empty())
            l.delete();
    }
}
Üblicherweise deklariert man, um eine Schnittstelle zu nutzen, die Schnittstelle als Datentyp, Zeile 20. Instanziiert wird dann eine konkrete Implementierung, hier SingleLinkedList. Beziehen sich Schnittstelle und konkrete Implementierung auf denselben Datentypen, reicht es, diesen bei der Datentypangabe der Variablen anzugeben.
Stack
Definition: Ein Stack (Keller) ist eine (gegebenenfalls leere) Folge von Elementen zusammen mit einem sogenannten (gegebenenfalls leeren) Top-Element.
Ein Stack arbeitet nach den LIFO-Prinzip (Last In First Out).
Schnittstelle des ADT Stack
| Methode | Objekte | Ergebnis | Beschreibung | |
|---|---|---|---|---|
empty() |
Stack | → | boolean | true, wenn Stack leer |
push() |
Stack \times Objekt | → | Objekt | legt Element auf Stack |
top() |
Stack | → | Objekt | liefert oberstes Element |
pop() |
Stack | → | Objekt | liefert und entfernt oberstes Element |
Semantik der Stack-Operationen
- Ein neu generierter Stack ist leer.
- Nach einer
push()-Operation ist ein Stack nicht leer. - Nach einer
push()-pop()-Operation ist ein Stack unverändert. - Nach einer
push()-Operation mit Element x liefert dietop()-Operation x.
package adt;

/**
 * Interface für den generischen ADT {@code Stack}.
 *
 * @param <T> Datentyp
 */
public interface Stack<T> {
    /**
     * Prüfung, ob Stack leer.
     *
     * @return {@code true}, wenn Stack leer, sonst {@code false}
     */
    boolean empty();
    /**
     * Wert ({@code obj}) vom Typ {@code T} auf den Stapel legen.
     *
     * @param obj Wert
     */
    void push(T obj);
    /**
     * Wert des obersten Stack-Elements liefern.
     *
     * @return Wert
     */
    T top();
    /**
     * Liefern und entfernen des obersten Stack-Elements.
     *
     * @return Wert
     */
    T pop();
}
Konzept zur Implementierung eines Stacks mithilfe von Verweisen
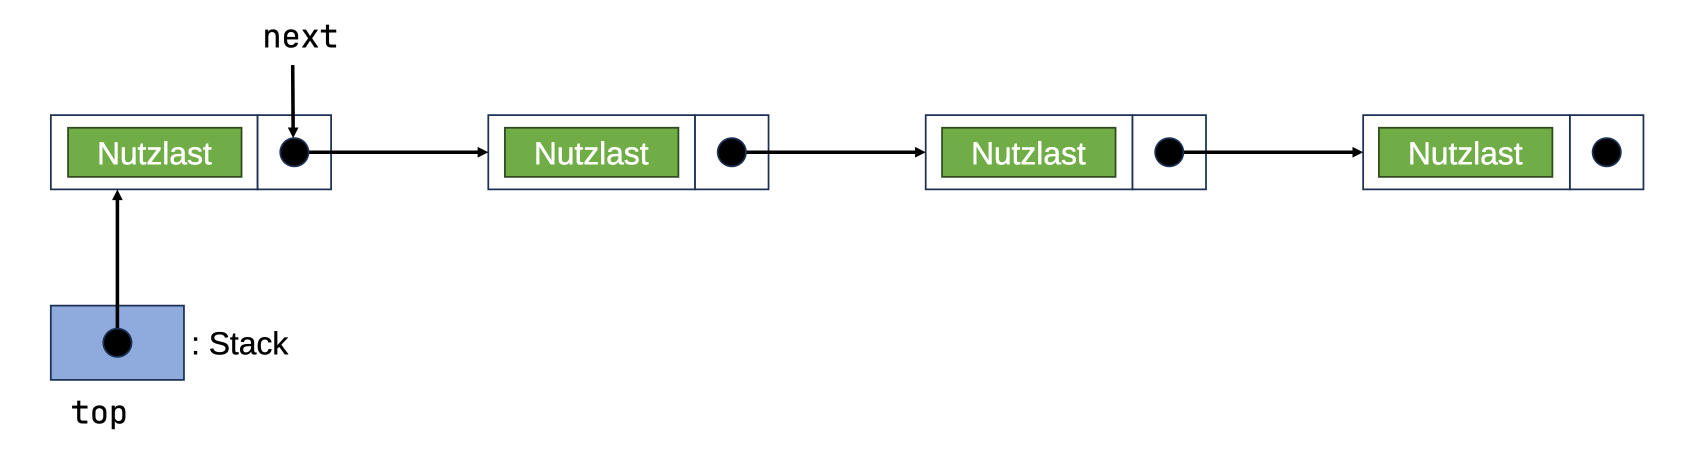
Das Konzept ist dem der einfach verketteten Liste sehr ähnlich. Es ist jedoch insofern einfacher, als das neue Elemente jeweils immer als Top-Element eingefügt werden. Ebenso erfolgt das Lesen und Löschen auch nur beim jeweiligen Top-Element, welches auf dem Stack oben liegt.
Die Verwaltungsstruktur eine Verweis-Stacks kommt mit einem Attribut aus, einem Zeiger auf das Top-Element.
Das Konzept der hier angestrebten Implementierung können wir wie folgt visualisieren:
package adt;

/**
 * {@code ReferenceStack} implementiert einen generischen {@link adt.Stack}
 * mithilfe von Verweisen.
 *
 * @param <T> Datentyp
 */
public final class ReferenceStack<T> implements Stack<T> {

    private class Element {
        private T content;
        private Element next;
    }

    private Element top;  // Zeiger auf Top-Element

    /** Konstruktor für einen leeren Stack. */
    public ReferenceStack() { top = null; }

    /**
     * Prüfung, ob Stack leer.
     *
     * @return {@code true}, wenn Stack leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return top ==  null;
    }

    /**
     * Wert ({@code obj}) vom Typ {@code T} auf den Stapel legen.
     *
     * @param obj Wert
     */
    @Override
    public void push(T obj) {
        Element tmp = new Element();
        tmp.content = obj;
        tmp.next = top;
        top = tmp;
    }

    /**
     * Wert des obersten Stack-Elements liefern.
     *
     * @throws RuntimeException Stack ist leer
     * @return Wert
     */
    @Override
    public T top() throws RuntimeException {
        if (empty())
            throw new RuntimeException("Stack ist leer.");
        return top.content;
    }

    /**
     * Liefern und entfernen des obersten Stack-Elements.
     *
     * @throws RuntimeException Stack ist leer
     * @return Wert
     */
    @Override
    public T pop() throws RuntimeException {
        if (empty())
            throw new RuntimeException("Stack ist leer.");
        T data = top.content;
        top = top.next;
        return data;
    }
}
Beispielanwendungen für den Gebrauch eines Stacks
Die Formulierung Stack<Integer> im folgenden Beispiel legt nahe, dass zum Speichern von Werten primitiver Datentypen zunächst das Verpacken der Werte mithilfe der bereits erwähnten Wrapper-Klassen erforderlich ist. So würde durch new Integer(i) ein Integer-Objekt erzeugt mit dem (nicht mehr veränderbaren) Wert i. Diese Form gilt allerdings als veraltet. Manche Entwicklungsumgebungen warnen deshalb. Die moderne Variante ruft den Konstruktor nicht direkt auf. Sie lautet: Integer.valueOf(i). Der Wert dieses Objekts kann über die Methode intValue() ermittelt werden.
Tatsächlich kann aber auf diese Umwege verzichtet werden. Java unterstützt seit geraumer Zeit ein automatisches Boxing und Unboxing, sodass wir primitive Datentypen nicht mehr explizit in deren Wrapper-Klassen ver- und entpacken müssen. - Das nutzen wir hier.
Reversierung einer Zahlenfolge mithilfe eines Stacks:
import adt.Stack;
import adt.ReferenceStack;
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Reversierung einer Folge ganzer Zahlen.
 */
public class Reverse {
    /**
     * Treiber für Reversierung.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        Stack<Integer> s = new ReferenceStack<>();
        int[] a = StdIn.readlnInts("Zahlenfolge: ");

        for (int i = 0; i < a.length; i++)
            s.push(a[i]);

        StdOut.println("Umgekehrte Reihenfolge:");
        while (!s.empty()) {
            // anzeigen und entfernen in zwei Schritten
            StdOut.println(s.top());
            s.pop();
        }
    }
}
Da pop() den Wert des obersten Stack-Elements liefert, könnten wir top() durch pop() ersetzen und so das Erfragen und Löschen des obersten Stack-Elements in einem Schritt erledigen. Zur Demonstration aller Methoden des Stacks wird das hier jedoch in zwei Schritten vorgenommen.
import adt.Stack;
import adt.ReferenceStack;
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Einfache Prüfung, ob Klammern syntaktisch korrekt gesetzt sind.
 * <p>
 * Klammern in Zeichenketten, die nicht exakt paarweise gesetzt sind,
 * führen zu fehlerhaften Ergebnissen. {@code Brackets} behauptet dann,
 * fehlerhaft gesetzte Klammern gefunden zu haben.
 */
public class Brackets {
    /**
     * Treiber für Klammerprüfung.
     *
     * Die Eingabe wird über die Standardeingabe gelesen.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        char[] chars;
        boolean error = false;
        Stack<Character> s = new ReferenceStack<>();

        // komplette Standardeingabe lesen und als Array von
        // Zeichen speichern
        chars = StdIn.readAllChars();
        for (char ch : chars) {  // for-each-Schleife
            switch (ch) {
                case '(', '[' -> s.push(ch);
                case ')' -> {
                    if (!s.empty() && s.top() == '(')
                        s.pop();
                    else error = true;
                }
                case ']' -> {
                    if (!s.empty() && s.top() == '[')
                        s.pop();
                    else error = true;
                }
            }
        }
        if (!error && s.empty())
            StdOut.println("Korrekt geklammert.");
        else
            StdOut.println("Nicht korrekt geklammert.");
    }
}
Das Programm berücksichtigt nicht, dass Klammern im Text oder als konstante Zeichen nicht zwingend korrekt, im Sinne der Java-Syntax, geklammert sein müssen. Auf sich selbst angewendet meldet das Programm daher einen Fehler bezüglich der Klammer-Symbole.
$ java Brackets < HelloWorld.java
Korrekt geklammert.
$ java Brackets < Brackets.java
Nicht korrekt geklammert.
$ _
Das folgende Programm liest einen arithmetischen Ausdruck in der üblichen Infix-Notation und wandelt ihn in einen Postfix-Ausdruck um. Computer arbeiten intern damit. D.h., erst kommen die Operanden und darauf folgt die Operation, die für die zwei vorausgegangenen Operanden ausgeführt werden soll. Auf diese Weise, die sich auch „Umgekehrt polnische Notation“ nennt, kann man sich Klammern grundsätzlich sparen.
import adt.ReferenceStack;
import adt.Stack;
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * {@code Postfix} konvertiert einen einfachen Infix-Ausdruck nach
 * Postfix.
 * <p>
 * Eine syntaktisch korrekte Eingabe wird vorausgesetzt. Zulässig sind
 * die Operatoren +, -, * und /. Als Operanden sind ausschließlich die
 * Kleinbuchstaben a-z zulässig. Ein Ausdruck ist lückenlos einzugeben.
 */
public class Postfix {
    /**
     * Treiber für Infix2Postfix-Umwandlung.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        Stack<Character> s = new ReferenceStack<>();
        char[] expression = StdIn.readlnChars("Infix-Ausdruck:  ");

        StdOut.print("Postfix-Ausdruck: ");
        for (char ch : expression) {
            switch (ch) {
                case '(' -> s.push(ch);         // auf den Stapel
                // Keller bis vor '(' ausgeben und leeren
                case ')' -> {
                    while (s.top() != '(')
                        StdOut.print(s.pop());
                    s.pop();                    // '(' entfernen
                }
                // Keller bis vor die erste öffnende Klammer ausgeben
                // und leeren
                case '+', '-' -> {
                    while (!s.empty() && s.top() != '(')
                        StdOut.print(s.pop());
                    s.push(ch);                 // letztes Zeichen merken
                }
                // solange Keller '*' oder '/' enthält, ausgeben
                // und entfernen
                case '*', '/' -> {
                    if (!s.empty() && (
                        s.top() == '*' || s.top() == '/' )
                    )
                        StdOut.print(s.pop());
                    s.push(ch);                 // letztes Zeichen merken
                }
                // falls Operand vorliegt, direkt ausgeben
                default -> {
                    if (ch >= 'a' && ch <= 'z')
                        StdOut.print(ch);
                }
            }
        }
        // wenn beim Eingabeende noch Zeichen auf dem Stack liegen, ausgeben
        while (!s.empty())
            StdOut.print(s.pop());
        StdOut.println();
    }
}
$ java Postfix
(a+b)/(d-c)*e
ab+dc-/e*
$ java Postfix
((a-b)/(c-d-e/f))+(a+b+c)
ab-cd-ef/-/ab+c++
$ _Achtung: Fehlerhaft gesetzte Klammern können zu einem Programmabbruch führen.
Queue
Definition: Eine Queue (Schlange) ist eine (gegebenenfalls leere) Folge von Elementen zusammen mit einem sogenannten (gegebenenfalls undefinierten) Front-Element.
Eie Queue arbeitet nach den FIFO-Prinzip (First In First Out).
Schnittstelle des ADT Queue
| Methode | Objekte | Ergebnis | Beschreibung | |
|---|---|---|---|---|
empty() |
Schlange | → | boolean | true, wenn Schlange leer |
enqueue() |
Schlange \times Objekt | → | fügt Element hinten an | |
front() |
Schlange | → | Objekt | liefert vorderstes Element |
dequeue() |
Schlange | → | Objekt | entfernt vorderstes Element |
package adt;

/**
 * Interface für den generischen ADT {@code Queue}.
 *
 * @param <T> Datentyp
 */
public interface Queue<T> {
    /**
     * Prüfung, ob Schlange leer.
     *
     * @return {@code true}, wenn Schlange leer, sonst {@code false}
     */
    boolean empty();

    /**
     * Anfügen eines Objekts {@code obj} vom Typ {@code T} an das
     * Ende der Schlange.
     *
     * @param obj Wert
     */
    void enqueue(T obj);

    /**
     * Erstes Element aus der Schlange liefern.
     *
     * @return Wert
     */
    T front();

    /**
     * Erstes Element aus Schlange liefern und entfernen.
     *
     * @return Wert
     */
    T dequeue();
}
Konzept zur Implementierung einer Queue mithilfe von Verweisen
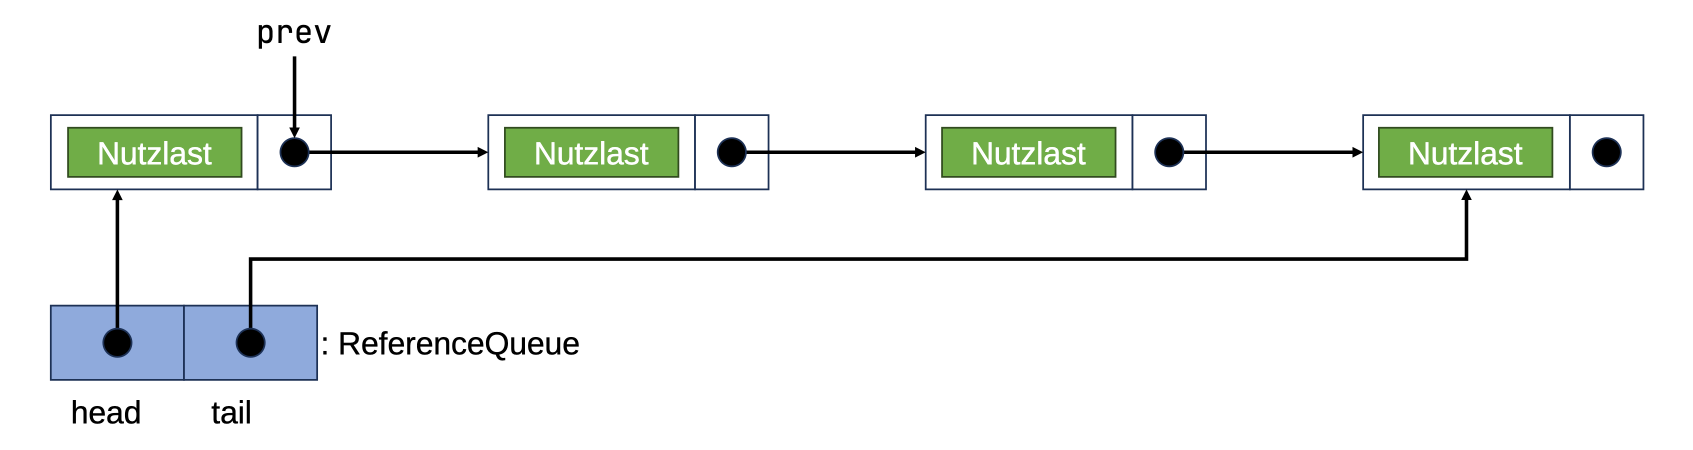
Das Konzept ist dem der einfach verketteten Liste sehr ähnlich. Es ist jedoch insofern einfacher, als das neue Elemente immer am Ende eingefügt werden. Dann erfolgt das Lesen und Löschen erfolgt jeweils am Beginn der verketteten Elemente, die in die Schlange eingereiht sind.
Die Verwaltungsstruktur einer Verweis-Queue benötigt zwei Attribute, einen Zeiger auf Kopf und einen auf das Ende der Schlange.
Das Konzept der hier angestrebten Implementierung können wir wie folgt visualisieren:
package adt;

/**
 * {@code ReferenceQueue} implementiert eine generische {@link Queue}
 * mithilfe von Verweisen.
 *
 * @param <T> Datentyp
 */
public class ReferenceQueue<T> implements Queue<T> {

    private class Element {
        private T content;
        private Element prev;
    }

    private Element head;  // Zeiger auf den Kopf der Schlange
    private Element tail;  // Zeiger auf das Ende der Schlange

    /**
     * Konstruktor für eine leere Queue.
     */
    public ReferenceQueue() {
        head = tail = null;
    }

    /**
     * Prüfung, ob Schlange leer.
     *
     * @return {@code true}, wenn Schlange leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return head == null;
    }

    /**
     * Anfügen eines Objekts {@code obj} vom Typ {@code T} an das
     * Ende der Schlange.
     *
     * @param obj Wert
     */
    @Override
    public void enqueue(T obj) {
        Element tmp = new Element();
        tmp.content = obj;
        if (empty())
            // wenn Schlange leer, dann Element gleich Kopf-Element
            head = tmp;
        else
            // sonst hinten anfügen
            tail.prev = tmp;
        tail = tmp;  // neues Element bildet das Ende der Schlange
    }

    /**
     * Erstes Element aus der Schlange liefern.
     *
     * @throws RuntimeException Schlange ist leer
     * @return Wert
     */
    @Override
    public T front() throws RuntimeException {
        if (empty())
            throw new RuntimeException("Schlange ist leer.");
        return head.content;
    }

    /**
     * Erstes Element aus Schlange liefern und entfernen.
     *
     * @throws RuntimeException Schlange ist leer
     * @return Wert
     */
    @Override
    public T dequeue() throws RuntimeException {
        if (empty())
            throw new RuntimeException("Schlange ist leer.");
        T data =  head.content;
        head = head.prev;
        return data;
    }
}import adt.Queue;
import adt.ReferenceQueue;
import StdLib.StdOut;
import oop.Date;
import oop.Student;
/**
* Test der Klasse {@link adt.ReferenceQueue}.
*/
public class ReferenceQueueTest {
/**
* Treiber für den Aufruf von Test-Anweisungen.
*
* @param args nicht genutzt
*/
public static void main(String[] args) {
Student s; // Student
Queue<Student> q = new ReferenceQueue<>(); // Schlange von Studenten
// neuen Studenten erzeugen und am Listenende anfügen
s = new Student("Wilhelm", "Wulf", new Date(13, 10, 2006),
"BWL");
q.enqueue(s);
// neuen Studenten erzeugen und am Listenende anfügen
s = new Student("Sabine", "Kittler", new Date(3, 4, 2006),
"BWL");
q.enqueue(s);
// neuen Studenten erzeugen und am Listenende anfügen
s = new Student("Wolfgang", "Bauer", new Date(2, 1, 2005),
"Informatik");
q.enqueue(s);
// neuen Studenten erzeugen und am Listenende anfügen
s = new Student("Viola", "Sauer", new Date(10, 12, 2005),
"Rechtswissenschaften");
q.enqueue(s);
StdOut.println(q.dequeue());
// restliche Schlange ausgeben und Elemente löschen
while (!q.empty()) {
StdOut.println(q.front()); // zwei Schritte
q.dequeue(); // zum Testen
}
}
}Konzept zur Implementierung eines Ringpuffers
Ein Ringpuffer (engl. Ringbuffer) stellt eine spezielle Art von Warteschlange dar, die gewöhnlich nur eine begrenzte Kapazität zur Verfügung stellt, wie beispielsweise der Pufferspeicher unserer Tastatur.
Weil ein RingBuffer eine Queue ist, implementiert er das Interface Queue. Ich verwende hier intern, um die eingereihten Elemente zu speichern ein Array. Das dabei genutzte Prinzip, einen Ring zu modellieren, kennen Sie bereits aus der Implementierung des Abzählreims Josephus.java (Kreisaufstellung der Kinder).
package adt;

/**
 * Implementierung einer {@link adt.Queue} als {@code RingBuffer}, einem
 * Ring-Speicher.
 *
 * @param <T> Datentyp der zu speichernden Elemente
 */
public class RingBuffer<T> implements Queue<T> {

    private final Object[] data;
    private final int capacity;
    private int count;
    private int head;

    /**
     * Konstruktor für einen {@code RingBuffer}. Die Kapazität
     * muss mindestens 10 betragen. Sie ist, nachdem der Puffer
     * erstellt wurde, fix.
     *
     * @throws RuntimeException Kapazität kleine als 10
     * @param capacity Anzahl der zu speichernden Elemente
     */
    public RingBuffer(int capacity) throws RuntimeException {
        if (capacity < 10)
            throw new RuntimeException("Mindestkapazität ist 10.");
        this.capacity = capacity;
        this.data = new Object[capacity];
        this.head = 0;
        this.count = 0;
    }

    /**
     * Prüfung, ob Puffer leer.
     *
     * @return {@code true}, wenn Puffer leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return count == 0;
    }

    /**
     * Anfügen eines Objekts {@code obj} vom Typ {@code T} an das
     * Ende des Puffers.
     *
     * @throws RuntimeException Puffer ist voll
     * @param obj Wert
     */
    @Override
    public void enqueue(T obj) throws RuntimeException {
        if (count == capacity)
            throw new IndexOutOfBoundsException("RingBuffer ist voll.");
        data[(head + count) % capacity] = obj;
        count++;
    }

    /**
     * Erstes Element aus dem Puffer liefern.
     *
     * @throws RuntimeException Puffer ist leer
     * @return Wert
     */
    @Override
    public T front() throws RuntimeException {
        if (empty())
            throw new IndexOutOfBoundsException("RingBuffer ist leer.");
        @SuppressWarnings("unchecked")
        T value= (T)data[head];
        return value;
    }

    /**
     * Erstes Element aus Puffer liefern und entfernen.
     *
     * @throws RuntimeException Puffer ist leer
     * @return Wert
     */
    @Override
    public T dequeue() throws RuntimeException {
        if (empty())
            throw new IndexOutOfBoundsException("RingBuffer ist leer.");
        @SuppressWarnings("unchecked")
        T value= (T)data[head];
        data[head] = null;  // Referenz zu alten Objekten lösen
        head = (head + 1) % capacity;
        count--;
        return value;
    }
}
Der Testclient zeigt die Anwendung eines Ringpuffers.
import adt.RingBuffer;
import adt.Queue;
import StdLib.StdErr;
import StdLib.StdOut;

/**
 * Testclient für die Klasse {@link adt.RingBuffer}.
 */
public class RingBufferTest {
    /**
     * Einfaches Treiber-Programm zum Testen der Routinen
     * der Klasse {@link adt.RingBuffer}.
     * @param args
     */
    public static void main(String[] args) {
        Queue<Integer> queue = new RingBuffer<>(15);

        for (int i = 0; i < 16; i++)
            try {
                queue.enqueue(i);
            } catch (RuntimeException e) {
                StdErr.println(e);
            }

        StdOut.println(queue.front());        // 0
        StdOut.println(queue.dequeue());      // 0
        StdOut.println(queue.dequeue());      // 1
        StdOut.println(queue.dequeue());      // 2
        queue.enqueue(15);
        while (!queue.empty())
            StdOut.println(queue.dequeue());  // 3, 4, ..., 15
    }
}
Konzept zur Implementierung einer Prioritätswarteschlange
Eine Prioritätswarteschlange (engl. Priority Queue) ist eine weitere spezielle Art vom Datentyp Queue. Bei Ihr steht nicht die Reihenfolge des Einreihens im Vordergrund. Eine Prioritätswarteschlange liefert als nächstes Element stets das Element mit der höchsten Priorität. Das bedeutet, wir müssen beim Einreihen eines neuen Elements darauf achten, das Element mit der höchsten Priorität am Kopf der Schlange zu positionieren.
Wir unterscheiden Min- und Max-Prioritätswarteschlangen. Bei einer Min-Prioritätswarteschlange hat das Element mit dem kleinsten Wert die höchste Priorität. Bei Max-Warteschlangen ist es genau umgekehrt.
Das soeben Gesagte impliziert die Notwendigkeit, die verschiedenen Elemente ordnen zu können. Dazu müssen sie vergleichbar sein. Unsere Prioritätswarteschlange akzeptiert daher ausschließlich Objekte, die dieser Anforderung direkt oder indirekt (über Vererbung) genügen.
Eine sehr einfache Art und Weise, Objekte vergleichbar zu machen, ist es, das Interface Comparable zu implementieren. Alle Objekte, die dieses Interface implementieren sind vergleichbar.
Als Beispiel betrachten wir eine Klasse PrintJobs. Diese dient ausschließlich zu Demonstrationszwecken. In einer Helpdesk-Anwendung werden Druckaufträge verwaltet. Jeder Druckauftrag erhält eine Priorität und wird in eine Warteschlange eingefügt. Dabei steht 0 für die höchste Priorität.
Das Interface Comparable verlangt danach, eine Methode compareTo() zu implementieren. Ist die eigene Instanz anhand des Vergleichskriteriums kleiner als das Vergleichsobjekt, liefert die Methode einen negativen Rückgabewert. Bei Gleichheit wird 0 zurückgegeben, andernfalls ein positiver Wert.
/**
 * Modellierung eines einfaches Druckauftrags als Beispiel
 * für die Verwendung einer Prioritätswarteschlange
 * ({@link adt.ListPriorityQueue}).
 */
public class PrintJob implements Comparable<PrintJob>{
    private final String jobId;
    private final String user;
    private final int pages;
    private final int priority;

    /**
     * Konstruktor für einen Druckauftrag.
     *
     * @param priority Priorität
     * @param jobId Job-ID
     * @param user Anwendername
     * @param pages Anzahl Seiten
     */
    public PrintJob(int priority, String jobId, String user, int pages) {
        this.priority = priority;
        this.jobId = jobId;
        this.user = user;
        this.pages = pages;
    }

    /**
     * Rückgabe der Job-ID.
     *
     * @return Job-ID
     */
    public String getJobId() {
        return jobId;
    }

    /**
     * Rückgabe der Zeichenkettendarstellung eines Druckauftrags.
     *
     * @return Druckauftrag (Zeichenkettendarstellung)
     */
    @Override
    public String toString() {
        return String.format("%d - (%s) %s: %d Seiten",
                             priority, jobId, user, pages );
    }

    /**
     * Vergleich der Prioritäten zweier Druckaufträge.
     *
     * @return -1 wenn aktueller Auftrag kleiner als Vergleichsauftrag<br>
     *          0 wenn beide Aufträge gleich sind<br>
     *          1 sonst
     */
    @Override
    public int compareTo(PrintJob other) {
        if (priority < other.priority)       return -1;
        else if (priority == other.priority) return  0;
        else return                                  1;
    }
}
Die Klasse PrintJob, rudimentär implementiert, implementiert das Interface Comparable in der oben erläuterten Art und Weise. Druckjobs können anhand ihrer jeweiligen Priorität verglichen werden. Wir können Sie in der folgenden Prioritätswarteschlange verwalten.
package adt;

/**
 * {@code ListPriorityQueue} implementiert eine generische
 * Prioritätswarteschlange auf Basis einer einfach verketteten
 * Liste (@link adt.SingleLinkedList).
 * <p>
 * Aufgrund der internen Nutzung einer SingleLinkedList ist das
 * Einfügen relativ ineffizient. Für Seminarzwecke und den dabei
 * anfallenden Anzahlen von einzuordnenden Datensätzen, ist das
 * Konstrukt aber ausreichend.
 * </p>
 * @param <T> Datentyp
 */
public class ListPriorityQueue<T extends Comparable<? super T>> implements Queue<T> {
    /* 1. T extends Comparable<...> Das bedeutet, dass der Typ T das Interface
     *    Comparable implementieren muss. Dadurch wird sichergestellt, dass man
     *    auf Objekten vom Typ T die Methode compareTo() aufrufen kann
     *    (wichtig z. B. zum Sortieren).
     * 2. <? super T> Das ist eine sogenannte Lower Bound Wildcard. Sie besagt,
     *    dass das Comparable-Interface nicht zwingend exakt für T definiert sein
     *    muss, sondern auch für eine Vaterklasse (Superklasse) von T definiert
     *    sein kann.
     */
    private final SingleLinkedList<T> list = new SingleLinkedList<>();
    private int size = 0;

    /**
     * Prüfung, ob Schlange leer.
     *
     * @return {@code true}, wenn Schlange leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return size == 0;
    }

    /**
     * Rückgabe der Größe (Anzahl möglicher Elemente) der Queue.
     *
     * @return Größe
     */
    public int getSize() {
        return size;
    }

    /**
     * Einfügen eines Objekts {@code obj} vom Typ {@code T} in die
     * Schlange.
     *
     * Hohe Priorität (kleiner Wert) wird vorn eingefügt. Bei gleicher
     * Priorität entscheidet die Einfügereihenfolge.
     *
     * @param obj Wert
     */
    @Override
    public void enqueue(T obj) {
        // Position vor dem ersten Element
        list.reset();

        // Wir suchen die erste Stelle, wo element "höher priorisiert" ist
        // (kleiner = höhere Priorität): element < aktuelles -> davor einfügen
        while (!list.endpos()) {
            T current = list.content();
            if (obj.compareTo(current) < 0) {
                break;
            }
            list.forward();
        }

        list.insert(obj);
        size++;
    }

    /**
     * Erstes Element aus der Schlange liefern.
     *
     * @return Wert
     */
    @Override
    public T front() {
        if (empty()) {
            throw new IllegalStateException("Queue ist leer.");
        }
        list.reset();
        return list.content();
    }

    /**
     * Erstes Element aus Schlange liefern und entfernen.
     *
     * @return Wert
     */
    @Override
    public T dequeue() {
        if (empty()) {
            throw new IllegalStateException("Queue ist leer.");
        }
        list.reset();
        T first = list.content(); // erstes Element
        list.delete();            // erstes Element löschen
        size--;
        return first;
    }

    /**
     * Liefert eine Zeichenkettendarstellung der Schlange
     * mit den darin enthaltenen Elementen.
     *
     * @return Zeichenkettendarstellung
     */
    @Override
    public String toString() {
        return list.toString();
    }
}
Die Beispielanwendung zeigt, wie Aufträge in die Warteschlange eingereiht und in welche Reihenfolge sie wieder ausgegeben werden, geordnet nach ihren jeweiligen Prioritäten. Bei Aufträgen gleicher Priorität wird der zuerst eingereihte Auftrag auch zuerst ausgegeben.
import adt.Queue;
import StdLib.StdOut;
import adt.ListPriorityQueue;

/**
 * Testclient für eine PriorityQueue ({@link adt.ListPriorityQueue})
 */
public class ListPriorityQueueTest {

    /**
     * Hauptprogramm.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        Queue<PrintJob> pq = new ListPriorityQueue<>();

        pq.enqueue(new PrintJob(5, "P01", "Karsten", 250));
        pq.enqueue(new PrintJob(3, "P02", "Susi", 30));
        pq.enqueue(new PrintJob(2, "P03", "Ben", 100));
        pq.enqueue(new PrintJob(5, "P04", "Georg", 99));
        pq.enqueue(new PrintJob(0, "P06", "Sabine", 75));

        while (!pq.empty()) {
            StdOut.println(pq.dequeue());
        }
    }
}
Zusammenfassung Queue
Die verschiedenen Beispiele haben unterschiedlichste Schlangen implementiert. Hierbei haben Sie gelernt, wie mächtig und flexibel das Konzept der Interfaces in Java ist. Alle drei vorgestellen ADTs, ReferenceQueue, RingBuffer und ListPriorityQueue implementieren das Interface Queue. Sie sind daher alle Schlangen. Allerdings implementieren sie jeweils unterschiedliche Anwendungslogiken. Wie sie das realisieren, bleibt dem Anwender verborgen. Dieser verlangt einfach nach einer Queue, spezifiziert deren Typ je nach Anwendungsfall und kann sie dann auf standardisierte Art und Weise nutzen. Diese Standardisierung, die wir auch bezüglich Comparable genutzt haben, stellt einen nicht zu unterschätzenden Gewinn für unsere eigenen Programm- und Datentypentwürfe dar.
Tree
Definition: Ein Binary Tree (binärer Baum) ist entweder leer oder besteht aus einem Knoten, dem ein Datenelement und zwei binäre Bäume zugeordnet sind.
Schnittstelle des ADT Tree
| Methode | Objekte | Ergebnis | Beschreibung | |
|---|---|---|---|---|
empty() |
Baum | → | bool | true, wenn Baum leer |
left() |
Baum | → | Baum | linken (Teil-)Baum liefern |
right() |
Baum | → | Baum | rechten (Teil-)Baum liefern |
content() |
Baum | → | Objekt | liefert aktuellen Wurzelinhalt |
package adt;

/**
 * Interface für den generischen ADT {@code Tree}.
 *
 * @param <T> Datentyp
 */
public interface Tree<T> {

    /**
     * Prüfung, ob der Baum leer ist.
     *
     * @return {@code true}, wenn Baum leer, sonst {@code false}
     */
    boolean empty();

    /**
     * Rückgabe des linken Teilbaums.
     *
     * @return linker Teilbaum
     */
    Tree<T> left();

    /**
     * Rückgabe des rechten Teilbaums.
     *
     * @return rechter Teilbaum
     */
    Tree<T> right();

    /**
     * Rückgabe des in der Wurzel gespeicherten Datenobjekts.
     *
     * @return Wert
     */
    T content();
}Achtung: Verdeutlichen Sie sich, dass die Operationen left() und right() jeweils wieder einen Baum liefern, nicht nur einen einzelnen Knoten.
Konzept zur Implementierung eines binären Baumes mithilfe von Verweisen
Ein Baum besteht, mithilfe von Verweisen implementiert, aus Knotenelementen, die neben einer Datenlast je zwei Verweise besitzen, einen Verweis auf den linken Sohn und einen Verweis auf den rechten Sohn. Diese können auch leer sein. Zur Konstruktion eines Baumes dienen verschiedene Konstruktoren.
package adt;

import java.util.NoSuchElementException;

/**
 * Referenz-basierter binärer Baum.
 *
 * <p>Hinweis: Der Konstruktor {@code ReferenceTree(l, content, r)}
 * verlinkt die Teilbäume (keine Kopie). Dadurch können mehrere
 * Baumobjekte dieselben Knoten teilen.</p>
 *
 * <p>Teilbäume werden verlinkt. Das spart Kopien, bedeutet aber:
 * mehrere Tree-Objekte können dieselben Knoten referenzieren.
 * Mutierende Operationen müssen daher sorgfältig implementiert
 * werden und sollten ausschließlich über die vorgesehenen Hooks
 * erfolgen.</p>
 *
 * @param <T> Datentyp der Elemente
 */
public class ReferenceTree<T> implements Tree<T> {

    /**
     * Baumknoten (gekapselt, für Nachfolger zugreifbar)
     */
    protected static class Node<T> {
        private T content;
        private Node<T> left, right;

        /** Konstruktor für einen neuen Knoten.
         *
         * @param content Inhalt
         */
        protected Node(T content) {
            this.content = content;
        }
    }

    // Wurzelknoten (komplett gekapselt)
    private Node<T> root;

    /**
     * Erzeugt einen leeren Baum.
     */
    public ReferenceTree() {
        root = null;
    }

    /**
     * Erzeugt einen Baum mit genau einem Element als Wurzel.
     *
     * @param obj Wert (nicht {@code null})
     */
    public ReferenceTree(T obj) {
        if (obj == null) {
            throw new IllegalArgumentException("Kein Wert angegeben");
        }
        root = new Node<>(obj);
    }

    /**
     * Erzeugt einen Baum aus linkem Teilbaum, Wurzelinhalt und
     * rechtem Teilbaum. Teilbäume werden verlinkt (keine Kopie).
     *
     * @param l linker Teilbaum (oder {@code null})
     * @param content Wurzelinhalt (nicht {@code null})
     * @param r rechter Teilbaum (oder {@code null})
     */
    public ReferenceTree(ReferenceTree<T> l,
                         T content,
                         ReferenceTree<T> r) {
        if (content == null) {
            throw new IllegalArgumentException("Kein Wert angegeben");
        }
        Node<T> n = new Node<>(content);
        setLeft(n, (l == null) ? null : l.root());
        setRight(n, (r == null) ? null : r.root());
        this.root = n;
    }

    /**
     * Interner Konstruktor, um eine Teilbaum-View aus einem
     * Knoten zu erzeugen.
     *
     * @param node Knoten
     */
    protected ReferenceTree(Node<T> node) {
        this.root = node;
    }

    /* ------------------------------------------------------------
     * ADT-Methoden (öffentlich, wie im Interface Tree<T>)
     * ------------------------------------------------------------ */

    /**
     * Prüfung, ob der Baum leer ist.
     *
     * @return {@code true}, wenn Baum leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return root == null;
    }

    /**
     * Rückgabe des linken Teilbaums.
     *
     * @return linker Teilbaum
     */
    @Override
    public Tree<T> left() {
        if (empty())
            return new ReferenceTree<>();
        return new ReferenceTree<>(leftOf(root));
    }

    /**
     * Rückgabe des rechten Teilbaums.
     *
     * @return rechter Teilbaum
     */
    @Override
    public Tree<T> right() {
        if (empty())
            return new ReferenceTree<>();
        return new ReferenceTree<>(rightOf(root));
    }

    /**
     * Rückgabe des in der Wurzel gespeicherten Datenobjekts.
     *
     * @return Wert
     */
    @Override
    public T content() throws NoSuchElementException {
        if (empty())
            throw new NoSuchElementException("Baum ist leer.");
        return contentOf(root);
    }

    /* ------------------------------------------------------------
     * Protected Hooks für Unterklassen (z.B. SearchTree)
     * ------------------------------------------------------------ */

    /**
     * Zugriff auf die Wurzel (für Unterklassen).
     *
     * @return Wurzel
     */
    protected final Node<T> root() {
        return root;
    }

    /**
     * Setzt die Wurzel (für Unterklassen).
     *
     * @param node neuer Wurzelknoten
     */
    protected final void setRoot(Node<T> node) {
        root = node;
    }

    /**
     * Erzeugt einen neuen Knoten (für Unterklassen).
     *
     * @param content Inhalt
     * @return Referenz auf den neuen Knoten
     * @throws IllegalArgumentException wenn Knoten gleich {@code null}
     */
    protected final Node<T> newNode(T content) {
        if (content == null)
            throw new IllegalArgumentException("Kein Wert angegeben");
        return new Node<>(content);
    }

    /**
     * Liefert den Inhalt eines Knotens (für Unterklassen).
     *
     * @param n Knoten, dessen Inhalt ausgelesen werden soll
     * @return Inhalt des Knoten
     */
    protected final T contentOf(Node<T> n) {
        return n.content;
    }

    /**
     * Setzt den Inhalt eines Knotens (für Unterklassen).
     *
     * @param n Knoten dessen Inhalt gesetzt werden soll
     * @param content Inhalt
     * @throws IllegalArgumentException wenn Inhalt gleich {@code null}
     */
    protected final void setContent(Node<T> n, T content) {
        if (content == null)
            throw new IllegalArgumentException("Kein Wert angegeben");
        n.content = content;
    }

    /**
     * Linkes Kind lesen (für Unterklassen).
     *
     * @param n zu lesender Knoten
     * @return linkes Kind des zu lesenden Knotens
     */
    protected final Node<T> leftOf(Node<T> n) {
        return n.left;
    }

    /**
     * Rechtes Kind lesen (für Unterklassen).
     *
     * @param n zu lesender Knoten
     * @return rechtes Kind des zu lesenden Knotens
     */
    protected final Node<T> rightOf(Node<T> n) {
        return n.right;
    }

    /**
     * Linkes Kind setzen (für Unterklassen).
     *
     * @param parent Knoten dessen linkes Kind zu setzen ist
     * @param left neues linkes Kind
     * @throws IllegalArgumentException wenn parent gleich {@code null}
     * (left/right dürfen null sein; das entspricht einem leeren Teilbaum)
     */
    protected final void setLeft(Node<T> parent, Node<T> left) {
        if (parent == null)
            throw new IllegalArgumentException("parent ist null");
        parent.left = left;
    }

    /**
     * Rechtes Kind setzen (für Unterklassen).
     *
     * @param parent Knoten dessen rechtes Kind zu setzen ist
     * @param right neues rechtes Kind
     * @throws IllegalArgumentException wenn parent gleich {@code null}
     * (left/right dürfen null sein; das entspricht einem leeren Teilbaum)
     */
    protected final void setRight(Node<T> parent, Node<T> right) {
        if (parent == null)
            throw new IllegalArgumentException("parent ist null");
        parent.right = right;
    }
}
Traversierungen
Zur Ausgabe eines Baumes, müssen wir die einzelnen Knoten abwandern können. Das nennen wir Traversierung. Eine Traversierung eines binären Baumes besteht aus dem systematischen Besuchen aller Knoten in einer bestimmten Reihenfolge.
- Preorder: Vater, linker Sohn, rechter Sohn
- Inorder: linker Sohn, Vater, rechter Sohn
- Postorder: linker Sohn, rechter Sohn, Vater
D.h., dass für jeden besuchten Knoten stets in derselben Art weiter traversiert wird, die Traversierungen also rekursiv definiert sind.
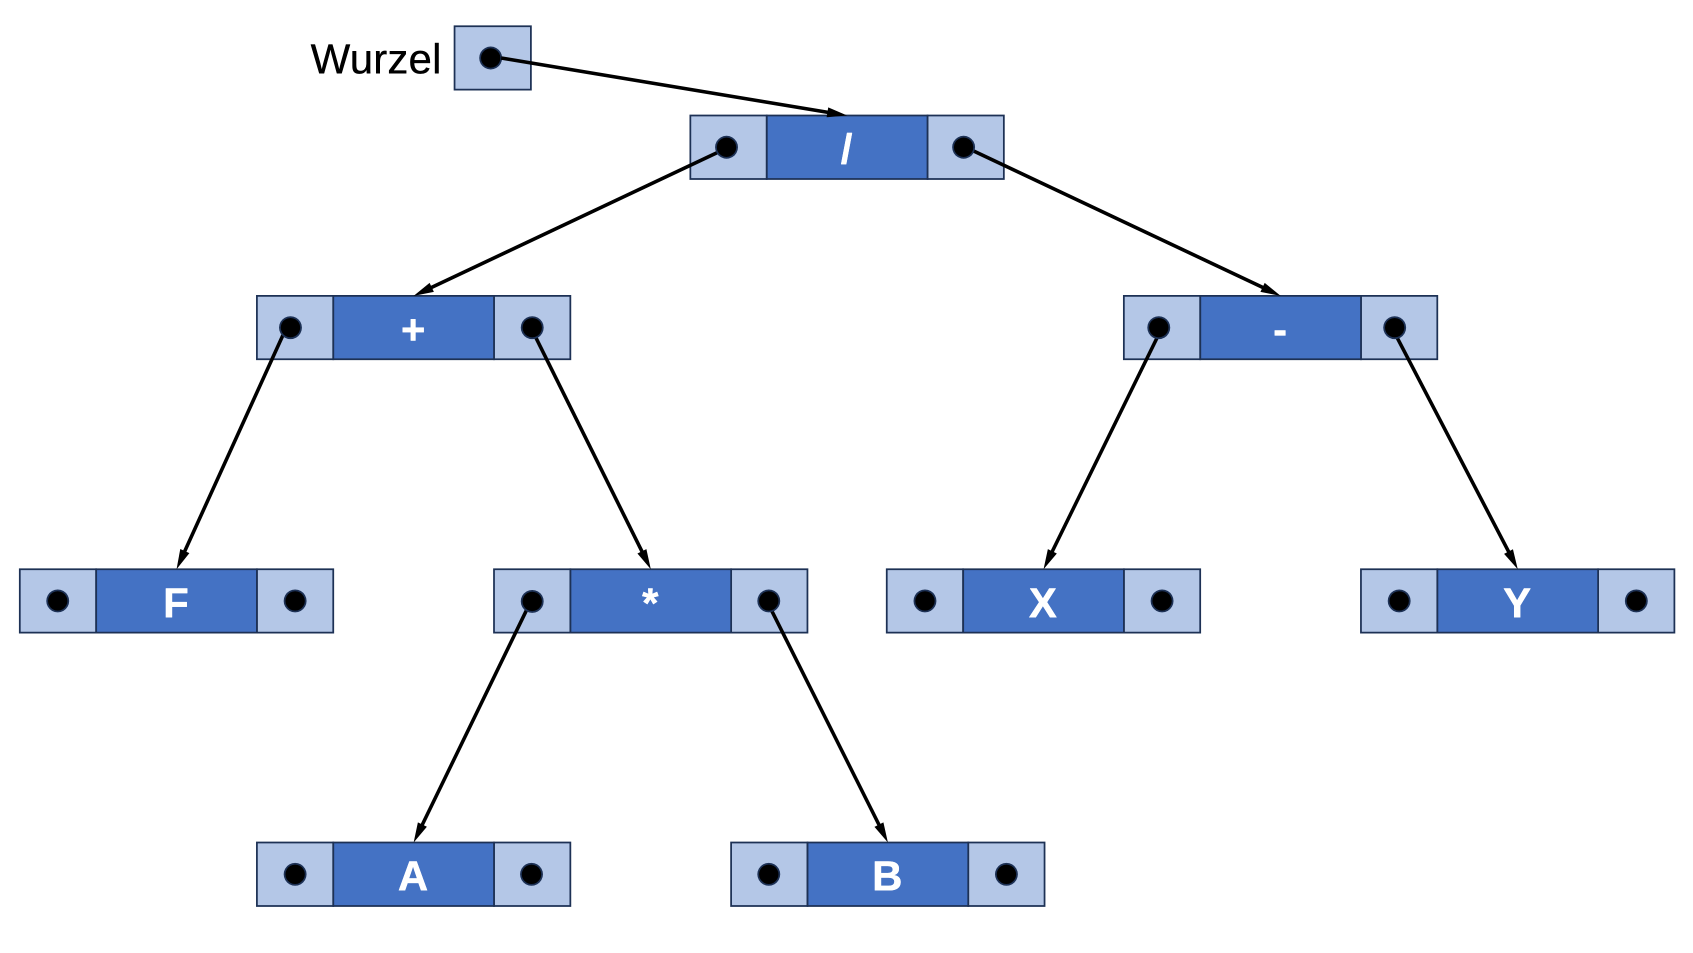
Für den Baum in der obigen Abbildung ergeben sich dann die folgenden Traversierungen:
Preorder:   / + F * A  B - X Y
Inorder:    F + A * B  / X - Y
Postorder:  F A B * +  X Y - /
Bevor wir zum Test einen Baum konstruieren, benötigen wir eine Möglichkeit, die Baumknoten abzuschreiten und auszugeben. Wir implementieren einfache Traversen.
Wir brauchen nur die Definition der einzelnen Traversierungen 1:1 in Code umsetzen. Ein leerer Baum stellt die jeweilige Rekursionsbremse, den Basisfall, dar.
package adt;

import StdLib.StdOut;

/**
 * Die Klasse {@code Traverse} stellt einfache Traversierungen
 * für binäre Bäume zur Verfügung.
 */
public class Traverse {

    /**
     * Preorder-Baumtraverse.
     *
     * @param tree Baum
     * @param <T> Datentyp der Elemente im Baum
     */
    public static <T> void preorder(Tree<T> tree) {
        if (!tree.empty()) {
            StdOut.print(tree.content());
            preorder(tree.left());
            preorder(tree.right());
        }
    }

    /**
     * Inorder-Baumtraverse.
     *
     * @param tree Baum
     * @param <T> Datentyp der Elemente im Baum
     */
    public static <T> void inorder(Tree<T> tree) {
        if (!tree.empty()) {
            inorder(tree.left());
            StdOut.print(tree.content());
            inorder(tree.right());
        }
    }

    /**
     * Inorder-Baumtraverse mit Klammern.
     *
     * @param tree Baum
     * @param <T> Datentyp der Elemente im Baum
     */
    public static <T> void bracketinorder(Tree<T> tree) {
        if (!tree.empty()) {
            if (!tree.left().empty()) StdOut.print('(');
            bracketinorder(tree.left());
            StdOut.print(tree.content());
            bracketinorder(tree.right());
            if (!tree.right().empty()) StdOut.print(')');
        }
    }

    /**
     * Postorder-Baumtraverse mit Klammern.
     *
     * @param tree Baum
     * @param <T> Datentyp der Elemente im Baum
     */
    public static <T> void postorder(Tree<T> tree) {
        if (!tree.empty()) {
            postorder(tree.left());
            postorder(tree.right());
            StdOut.print(tree.content());
        }
    }
}
Das Programm TraverseTest.Java konstruiert mithilfe der Konstruktoren den Baum aus Abbildung 4.
import adt.ReferenceTree;
import adt.Traverse;
import StdLib.StdOut;

/**
 * Testclient für verschiedene einfache Traversen ({@link adt.Traverse}).
 */
public class TraverseTest {
    private static ReferenceTree<Character> buildTree() {
        ReferenceTree<Character> a = new ReferenceTree<>('A');
        ReferenceTree<Character> b = new ReferenceTree<>('B');
        ReferenceTree<Character> m = new ReferenceTree<>(a, '*', b);
        ReferenceTree<Character> f = new ReferenceTree<>('F');
        ReferenceTree<Character> p = new ReferenceTree<>(f, '+', m);
        ReferenceTree<Character> x = new ReferenceTree<>('X');
        ReferenceTree<Character> y = new ReferenceTree<>('Y');
        ReferenceTree<Character> s = new ReferenceTree<>(x, '-', y);
        return new ReferenceTree<>(p, '/', s);
    }


    /**
     * Aufbau eines binären Baums (fixer arithmetischer Ausdruck).
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        ReferenceTree<Character> tree = buildTree();

        StdOut.print("Preorder.......: ");
        Traverse.preorder(tree); StdOut.println();
        StdOut.print("Inorder........: ");
        Traverse.inorder(tree); StdOut.println();
        StdOut.print("Postorder......: ");
        Traverse.postorder(tree); StdOut.println();
    }
}
$ java TraverseTest
Preorder.......: /+F*AB-XY
Inorder........: F+A*B/X-Y
BracketInorder.: ((F+(A*B))/(X-Y))
Postorder......: FAB*+XY-/
$ _Tiefensuche
Der Vorteil der Rekursion ist es, als Programmierer kein eigenes Protokoll darüber führen zu müssen, welche Knoten des zu traversierenden Baums noch nicht vollständig behandelt worden sind. Diese Aufgabe übernimmt, ganz automatisch, der Aufrufstapel der noch nicht vollständig abgearbeiteten rekursiven Methodenaufrufe.
Mit der Tiefen- und Breitensuche (nächster Unterabschnitt), stelle ich Ihnen zwei Traversierungsstrategien vor, die iterativ vorgehen. Die Protokollierung über die Schritte, die jeweils noch zu tun sind, führen wir selbst durch. Dazu nutzen wir die bereits besprochenen Datentypen, Stack und Queue.
Die Tiefensuche (DFS = Depth-First Search) besucht die Baumknoten in einer Preorder-Reihenfolge. Zuerst wird der Vater eines (Teil-)Baums verarbeitet, dann der linke und am Ende der jeweils rechte Sohn.
Der Vater kann problemlos verarbeitet werden. Wir haben uns aber zu merken, dass es eventuell einen rechten Sohn gibt, bevor wir zur Verarbeitung eines potenziell linken Sohns schreiten. Andernfalls kommen wir an den nicht mehr heran. Die dafür geeignete Datenstruktur, das Protokoll zu führen, ist der Stack.
package adt;

import StdLib.StdOut;

/** Tiefensuche auf binärem Bäumen. */
public final class DFS {
    /**
     * Tiefensuche auf Baum {@code tree}.
     *
     * @param tree Baum
     * @param <T> Datentyp der Elemente im Baum
     */
    public static <T> void dfs(Tree<T> tree) {
        Tree<T> t;
        Stack<Tree<T>> stack = new ReferenceStack<>();

        // initial wird der gesamte Baum auf den Stack gelegt
        if (!tree.empty())
            stack.push(tree);

        // jetzt beginnt die Traversierung
        while (!stack.empty()) {           // solange Keller nicht leer
            t = stack.pop();               // hole Baum vom Keller
            do {
                StdOut.print(t.content()); // Wurzel ausgeben
                if (!t.right().empty())    // wenn rechter Sohn existiert
                    stack.push(t.right()); // rechten Sohn merken
                t = t.left();              // gehe zum linken Sohn
            } while (!t.empty());          // solange es linken Sohn gibt
        }
    }
}
Breitensuche
Die Breitensuche (BFS = Breadth-First Search) traversiert einen Baum, von der Wurzel ausgehend, Ebene für Ebene. Dabei wird in jeder Ebene von links nach rechts vorgegangen. Die geeignete Datenstruktur, das erforderliche Protokoll zu verwalten, ist die Queue.
package adt;
import StdLib.StdOut;

/** Breitensuche auf binärem Bäumen. */
public final class BFS {
    /**
     * Breitensuche auf Baum {@code tree}.
     *
     * @param tree Baum
     * @param <T> Datentyp der Elemente im Baum
     */
    public static <T> void bfs(Tree<T> tree) {
        Tree<T> t;
        Queue<Tree<T>> queue = new ReferenceQueue<>();

        // initial wird der gesamte Baum in die Schlange eingefügt
        if (!tree.empty())
            queue.enqueue(tree);

        // jetzt beginnt die Traversierung
        while (!queue.empty()) {           // solange Schlange nicht leer
            t = queue.dequeue();           // hole Baum aus Schlange
            StdOut.print(t.content());     // Wurzel ausgeben
            if (!t.left().empty())         // wenn linker Sohn existiert
                queue.enqueue(t.left());   // linken Sohn merken
            if (!t.right().empty())        // wenn linker Sohn existiert
                queue.enqueue(t.right());  // linken Sohn merken
        }
    }
}import adt.DFS;
import adt.BFS;
import adt.ReferenceTree;
import StdLib.StdOut;
/**
* Testclient für die iterativen Traversen {@link adt.DFS}
* und {@link adt.BFS}
*/
public class DFSBFSTest {
private static ReferenceTree<Character> buildTree() {
ReferenceTree<Character> a = new ReferenceTree<>('A');
ReferenceTree<Character> b = new ReferenceTree<>('B');
ReferenceTree<Character> m = new ReferenceTree<>(a, '*', b);
ReferenceTree<Character> f = new ReferenceTree<>('F');
ReferenceTree<Character> p = new ReferenceTree<>(f, '+', m);
ReferenceTree<Character> x = new ReferenceTree<>('X');
ReferenceTree<Character> y = new ReferenceTree<>('Y');
ReferenceTree<Character> s = new ReferenceTree<>(x, '-', y);
return new ReferenceTree<>(p, '/', s);
}
/**
* Treiber füllt den Baum und traversiert ihn.
*
* @param args nicht genutzt
*/
public static void main(String[] args) {
ReferenceTree<Character> tree = buildTree();
StdOut.print("Tiefensuche....: ");
DFS.dfs(tree); StdOut.println();
StdOut.print("Breitensuche...: ");
BFS.bfs(tree); StdOut.println();
}
}Aufbau eines Postfix-Baums
Das Programm BuildPostfixTree.java liest interaktiv einen Postfix-Ausdruck ein und generiert daraus einen binären Baum. Dieser kann dann mittels entsprechender Traversen ausgeben werden, zum Beispiel als Infix-Ausdruck.
import adt.*;
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Interaktives Einlesen eines Postfix-Ausdrucks, Generierung
 * eines binären Baums und dessen Traversierung.
 */
public class BuildPostfixTree {
    public static ReferenceTree<Character> buildTree(char[] expression) {
        ReferenceTree<Character> t, l, r;
        Stack<ReferenceTree<Character>> s = new ReferenceStack<>();

        for (int i=0; i<expression.length; i++) {
            char ch = expression[i];
            if (ch!='+' && ch!='-' && ch!='*' && ch!='/')
                // ch ist Operand -> Blatt erzeugen
                t = new ReferenceTree<>(ch);
            else {
                // ch ist Operator -> Baum erzeugen
                r = s.pop();  // rechter Sohn
                l = s.pop();  // linker Sohn
                t = new ReferenceTree<>(l, ch, r);
            }
            s.push(t);        // Baum auf Stapel ablegen
        }
        return s.top();       // Ergebnisbaum liefern
    }

    /**
     * Treiber liest einen Postfix-Ausdruck ein und
     * generiert einen entsprechenden Baum.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        char[] ex = StdIn.readlnChars("Postfix-Ausdruck: ");
        Tree<Character> tree = buildTree(ex);
        StdOut.print("Inorder.........: ");
        Traverse.inorder(tree); StdOut.println();
    }
}
Beispielsitzung:
$ java BuildPostfixTree
Postfix-Ausdruck: FAB*+XY-/
Inorder.........: F+A*B/X-Y
$ _
Enumerationen
Mit den bisher besprochenen Traversierungen haben wir uns ein Problem eingehandelt. Wir vermengen in Ihnen die Traversierung mit der Verarbeitung der Daten. Die bestand lediglich aus einer Ausgabe der jeweiligen Daten eines Baumknotens. Wollen wir jedoch etwas anderes tun, müssen wir die Traversen neu implementieren. - Gesucht ist also ein Verfahren, welches Traversierung und Datenverarbeitung trennt.
Eine Enumeration ist ein Objekt, das den sequentiellen Zugriff auf die Elemente einer Sammlung erlaubt, ohne deren interne Struktur offenzulegen.
Sie realisiert damit das Iterator-Prinzip:
Ein Objekt stellt schrittweise seine Elemente bereit, ohne preiszugeben, wie diese intern gespeichert sind.
Beachte: Während einer Traversierung sollte die Datenstruktur nicht verändert werden.
Interface Enumeration<E>
In Java ist eine Enumeration durch das Interface
java.util.Enumeration<E>definiert. Es besitzt genau zwei Methoden:
hasMoreElements()- Liefert
true, wenn noch mindestens ein weiteres Element vorhanden ist. - Liefert
false, wenn die Enumeration erschöpft ist.
- Liefert
nextElement()- Liefert das nächste Element der Enumeration.
- Wirft
NoSuchElementException, falls kein weiteres Element existiert.
Die Verantwortung für die korrekte Reihenfolge und den internen Zustand liegt vollständig bei der Implementierung.
Grundprinzip der Implementierung
Eine Enumeration besteht konzeptionell aus zwei Teilen:
- Interner Zustand
- Merkt sich, wo sich die Enumeration aktuell befindet.
- Beispiele:
- ein Index
- ein Stack
- ein aktueller Knoten
- mehrere Hilfsstrukturen
- Zugriffslogik
- Bestimmt, welches Element als Nächstes geliefert wird.
- Aktualisiert den internen Zustand entsprechend.
Initialisierung im Konstruktor
Beim Erzeugen der Enumeration wird der Startzustand vorbereitet:
Anfangsposition setzen
Hilfsdatenstrukturen initialisieren
ggf. erste Elemente vorberechnen
Beispielhafte Aufgaben:
- Index auf 0 setzen
- Startknoten eines Baums festlegen
- Anfangspfad auf einen Stack legen
hasMoreElements()
Diese Methode prüft nur, ob noch Elemente vorhanden sind.
Typische Implementierungen: - Prüfen, ob ein Index das Ende erreicht hat. - Prüfen, ob ein Stack leer ist. - Prüfen, ob ein vorberechnetes „nächstes Element“ existiert.
Wichtig: - Keine strukturellen Änderungen. - Keine Zustandsveränderung, außer ggf. Vorbereitung (lazy evaluation).
nextElement()
- Prüft, ob noch ein Element existiert. Wenn nicht, wird eine eine Ausnahme
NoSuchElementExceptiongeworfen. - Liefert das aktuelle Element.
- Aktualisiert den internen Zustand so, dass beim nächsten Aufruf das folgende Element geliefert wird.
nextElement() ist die zentrale Methode der Enumeration.
Enumerator für SingleLinkedList
package adt;
import java.util.Enumeration;
import java.util.NoSuchElementException;

/**
 * Enumerator für {@link adt.SingleLinkedList}.
 *
 * @param <T> Datentyp der Elemente in der Liste.
 */
public final class EnumList<T> implements Enumeration<T>{

    private final List<T> list;

    /**
     * Konstruktor - erzeugt den Enumerator.
     *
     * @param l Liste
     */
    public EnumList(List<T> l) {
        list = l;
        list.reset();
    }

    /**
     * Prüft, ob noch weitere Elemente vorhanden sind.
     *
     * @return {@code true}, wenn noch mindestens ein Element vorhanden;
     * {@code false}, wenn alle Elemente durchlaufen wurden.
     */
    @Override
    public boolean hasMoreElements() {
        return !list.endpos();
    }

    /**
     * Gibt das nächste Element der Liste zurück.
     *
     * @return Das nächste Element (der Inhalt des Elements).
     * @throws NoSuchElementException wenn keine weiteren Elemente mehr vorhanden sind.
     */
    @Override
    public T nextElement() {
        if (list.endpos())
            throw new NoSuchElementException("Kein weiteres Element in Liste.");
        T o = list.content();
        list.forward();
        return o;
    }
}
Zur Demonstration, wie wir mit einem Enumerator arbeiten, nutzen wir das Programm zum Testen der einfach verketteten Liste SingleLinkedListTest.java (Listing 2) und modifizieren dessen Ausgabe.
Aus
// Liste auf Anfang und alle Elemente ausgeben
l.reset();
while (!l.endpos()) {
    StdOut.println(l.content());
    l.forward();
}
wird:
// alle Elemente ausgeben
EnumList<Student> e = new EnumList<>(l);
while (e.hasMoreElements())
    StdOut.println(e.nextElement());
Enumeratoren für einen binären Baum
Preorder-Traverse
Der Enumerator ist nicht allzu schwer zu implementieren. Seine Logik haben wir bereits bei der Tiefensuche, Seite , implementiert. Im Grunde trennen wir nur die while-Schleife in hasMoreElements() und nextElement() auf.
package adt;

import java.util.Enumeration;
import java.util.NoSuchElementException;

/**
 * Implementierung einer Preorder-Traversierung für einen binären Baum
 * als {@link Enumeration}.
 * <p>
 * Die Traversierung erfolgt iterativ unter Verwendung eines Stacks.
 * </p>
 * <p>
 * Reihenfolge: Wurzel -> linker Teilbaum -> rechter Teilbaum.
 * </p>
 * @param <T> Datentyp der Elemente im Baum.
 */
public final class PreorderTraverse<T> implements Enumeration<T> {

    private final Stack<Tree<T>> s;

    /**
     * Initialisiert die Traversierung für den angegebenen Baum.
     * Wenn der Baum nicht leer ist, wird die Wurzel auf den Stack gelegt.
     *
     * @param tree Der zu traversierende Baum.
     * @throws IllegalArgumentException wenn der übergebene Baum {@code null} ist.
     */
    public PreorderTraverse(Tree<T> tree) throws IllegalArgumentException {
        if (tree == null)
            throw new IllegalArgumentException("Es darf nicht null übergeben werden.");
        s = new ReferenceStack<>();
        if (!tree.empty())
            s.push(tree);
    }

    /**
     * Prüft, ob noch weitere Elemente in der Traversierung vorhanden
     * sind.
     *
     * @return {@code true}, wenn noch mindestens ein Element besucht
     *                       werden muss;<br>
     *        {@code false}, wenn alle Knoten des Baums bereits
     *                       durchlaufen wurden.
     */
    @Override
    public boolean hasMoreElements() {
        return !s.empty();
    }

    /**
     * Gibt das nächste Element der Preorder-Traversierung zurück.
     * Dabei wird der aktuelle Knoten vom Stack genommen und seine
     * Kinder (zuerst rechts, dann links) auf den Stack gelegt,
     * um die korrekte Preorder-Reihenfolge einzuhalten.
     *
     * @return Das nächste Element (der Inhalt des aktuellen Knotens).
     * @throws NoSuchElementException wenn keine weiteren Elemente
     *                                mehr vorhanden sind.
     */
    @Override
    public T nextElement() {
        if (s.empty())
            throw new NoSuchElementException("nextElement: Keller ist leer.");
        Tree<T> tree = s.pop();
        if (!tree.right().empty()) s.push(tree.right());
        if (!tree.left().empty()) s.push(tree.left());
        return tree.content();
    }
}
Inorder-Traverse
Die Enumeration für eine Inorder-Traverse ist nicht viel schwieriger zu implementieren als die Preorder-Traverse. Initial legen wir hierbei alle linken Söhne auf den Stack.
package adt;
import java.util.Enumeration;
import java.util.NoSuchElementException;

/**
 * Implementierung einer Inorder-Traversierung für einen binären Baum
 * als {@link Enumeration}.
 * <p>
 * Die Traversierung erfolgt iterativ unter Verwendung eines Stacks.
 * </p>
 * <p>
 * Reihenfolge: linker Teilbaum -> Wurzel -> rechter Teilbaum.
 * </p>
 * @param <T> Datentyp der Elemente im Baum.
 */
public final class InorderTraverse<T> implements Enumeration<T> {

    private final Stack<Tree<T>> s;

    /**
     * Initialisiert die Traversierung für den angegebenen Baum.
     * Wenn der Baum nicht leer ist, werden die Wurzel und alle
     * linken Söhne auf den Stack gelegt.
     *
     * @param tree Der zu traversierende Baum.
     * @throws IllegalArgumentException wenn der übergebene Baum
     *         {@code null} ist.
     */
    public InorderTraverse(Tree<T> tree)
            throws IllegalArgumentException {
        if (tree == null)
            throw new IllegalArgumentException(
                    "Es darf nicht null übergeben werden.");
        s = new ReferenceStack<>();
        while (!tree.empty()) {
            s.push(tree);
            tree = tree.left();
        }
    }

    /**
     * Prüft, ob noch weitere Elemente in der Traversierung vorhanden
     * sind.
     *
     * @return {@code true}, wenn noch mindestens ein Element besucht
     *                       werden muss;<br>
     *         {@code false}, wenn alle Knoten des Baums bereits
     *                        durchlaufen wurden.
     */
    @Override
    public boolean hasMoreElements() {
        return !s.empty();
    }

    /**
     * Gibt das nächste Element der Inorder-Traversierung zurück.
     * Nach der Entnahme eines Knotens vom Stack wird dessen rechter
     * Teilbaum besucht und alle Knoten entlang dessen linkem Pfad
     * auf den Stack gelegt.
     *
     * @return Das nächste Element
     *         (der Inhalt des aktuell besuchten Knotens).
     * @throws NoSuchElementException wenn der Stack leer ist und
     *         keine weiteren Elemente existieren.
     */
    @Override
    public T nextElement() {
        if (s.empty())
            throw new NoSuchElementException(
                    "nextElement: Keller ist leer.");
        Tree<T> t = s.pop();
        T result = t.content();
        if (!t.right().empty()) {
            t = t.right();
            do {
                s.push(t);
                t = t.left();
            } while (!t.empty());
        }
        return result;
    }
}
Postorder-Traverse
Die Enumeration für die Postorder-Traversierung ist etwas komplexer als die vorigen Enumerationen. Es gibt verschiedene Möglichkeiten sie zu implementieren. Ich habe mich hier für eine 2-Stack-Lösung entschieden. Hierbei wird der zweite Stack (s2), über den dann nextElement() die Elemente ausliefert, initial mit allen Baumelementen in umgekehrter Postorder-Reihenfolge befüllt. Hierfür wird der Stack s1 als Hilfsstapel verwendet, um die umgekehrte Postorder-Reihenfolge zu generieren.
package adt;

import java.util.Enumeration;
import java.util.NoSuchElementException;

/**
 * Implementierung einer Postorder-Traversierung für einen binären Baum
 * als {@link Enumeration}. Die Traversierung erfolgt iterativ unter
 * Verwendung von zwei Stacks (Zwei-Stack-Algorithmus).
 * <p>
 * Reihenfolge: linker Teilbaum -> rechter Teilbaum -> Wurzel.
 * </p>
 * @param <T> Datentyp der Elemente im Baum.
 */
public final class PostorderTraverse<T> implements Enumeration<T> {

    private final Stack<Tree<T>> s2;

    /**
     * Initialisiert die Traversierung für den angegebenen Baum.
     * Nutzt einen Hilfsstack (s1), um die Knoten in der umgekehrten
     * Postorder-Reihenfolge in den Ergebnisstack (s2) zu überführen.
     *
     * @param tree Der zu traversierende Baum.
     * @throws IllegalArgumentException wenn der übergebene Baum
     *                                  {@code null} ist.
     */
    public PostorderTraverse(Tree<T> tree) {
        if (tree == null)
            throw new IllegalArgumentException(
                    "Es darf nicht null übergeben werden.");

        Stack<Tree<T>> s1 = new ReferenceStack<>();
        s2 = new ReferenceStack<>();

        if (!tree.empty()) s1.push(tree);

        // baut Stack in umgekehrte PostorderReihenfolge
        while (!s1.empty()) {
            Tree<T> cur = s1.pop();
            s2.push(cur);

            // Für Postorder: Erst links, dann rechts in s1 pushen,
            // damit s2 die Reihenfolge Links-Rechts-Wurzel abbildet.
            if (!cur.left().empty())  s1.push(cur.left());
            if (!cur.right().empty()) s1.push(cur.right());
        }
    }


    /**
     * Prüft, ob noch weitere Elemente in der Traversierung vorhanden
     * sind.
     *
     * @return {@code true}, wenn noch mindestens ein Element auf dem
     *                       Ergebnisstack liegt;<br>
     *         {@code false}, wenn alle Knoten bereits zurückgegeben
     *                        wurden.
     */
    @Override
    public boolean hasMoreElements() {
        return !s2.empty();
    }

    /**
     * Gibt das nächste Element der Postorder-Traversierung zurück.
     * Die Elemente werden direkt vom vorbefüllten Ergebnisstack
     * entnommen.
     *
     * @return Das nächste Element (der Inhalt des aktuell besuchten
     *         Knotens).
     * @throws NoSuchElementException wenn keine weiteren Elemente
     *                                mehr vorhanden sind.
     */
    @Override
    public T nextElement() {
        if (s2.empty())
            throw new NoSuchElementException("nextElement: Keller ist leer.");
        return s2.pop().content();
    }
}
Suchbaum
Definition: Ein SearchTree (binärer Suchbaum, Binary Search Tree - BST) ist eine spezielle Form eines binären Baums, bei dem die gespeicherten Elemente geordnet sind.
Diese Ordnung erlaubt es, Such-, Einfüge- und Löschoperationen effizient durchzuführen.
Der SearchTree ist eine Mengen-Datenstruktur:
- Jedes Element kommt höchstens einmal vor.
- Die Reihenfolge der Elemente wird implizit durch die Baumstruktur repräsentiert.
- Die Baumstruktur hängt von der Einfüge-Reihenfolge ab.
| Methode | Objekte | Ergebnis | Beschreibung | |
|---|---|---|---|---|
empty() |
Menge | → | bool | true, wenn Menge leer |
lookup() |
Menge | → | Objekt | Objekt, wenn gefunden, sonst null |
insert() |
Menge | → | Objekt | eingefügtes/gefundenes Objekt |
Anmerkung: In vielen Lehrbüchern liefert insert() lediglich einen Wahrheitswert. In dieser Implementierung gibt insert() das im Baum gespeicherte Objekt zurück. Dadurch lassen sich typische Anwendungen (z.B. Zählstatistiken) ohne zusätzliche Suchoperation formulieren.
package adt;

/**
 * Schnittstelle für Mengen-Operationen.
 *
 * @param <T> Datentyp der gespeicherten Werte
 */
public interface Set<T extends Comparable<? super T>> {
    /**
     * Prüft, ob Menge leer ist.
     *
     * @return {@code true}, wenn leer, sonst {@code false}
     */
    boolean empty();
    /**
     * Sucht {@code x} in Menge.
     * @param x gesuchtes Element
     * @return {@code x}, wenn gefunden, sonst {@code null}
     */
    T lookup(T x);
    /**
     * {@code x} einfügen, wenn noch nicht vorhanden.
     *
     * @param x einzufügendes Element
     * @return eingefügtes/gefundenes Element
     */
    T insert(T x);
    /**
     * {@code x} aus Menge löschen.
     *
     * @param x zu löschendes Element
     * @return {@code true} bei Erfolg, sonst {@code false}
     */
    boolean delete(T x);
}
Der „klassische“ Suchbaum trennt den Schlüssel und den zu speichernden Wert, unterscheidet also zwischen ihnen. Es muss dann lediglich der Schlüssel vergleichbar sein. Insofern stellt der hier gezeigte Suchbaum eine vereinfachte Form des klassischen Suchbaums dar. In unserer Implementierung bildet der Wert gleichzeitig des Schlüssel, weshalb ausschließlich vergleichbare Werte in ihm gespeichert werden können.
Ordnungseigenschaft (Suchbaum-Invariante)
Für jeden Knoten mit dem gespeicherten Wert x gilt:
- Alle Werte im linken Teilbaum sind kleiner als
x. - Alle Werte im rechten Teilbaum sind größer als
x.
Diese Eigenschaft gilt rekursiv für alle Teilbäume. Sie ist die zentrale Invariante des Suchbaums und muss nach jeder Operation (einfügen, löschen) erhalten bleiben.
Voraussetzung: Vergleichbarkeit der Elemente
Damit die Ordnung definiert ist, müssen die gespeicherten Elemente vergleichbar sein. Daher gilt für den Datentyp T:
T implements Comparable<? super T>Das bedeutet:
- Zwei Elemente vom Typ
Tkönnen miteinander verglichen werden. - Die Vergleichslogik darf auch in einer Oberklasse von
Tdefiniert sein.
Der Vergleich erfolgt über: x.compareTo(y) mit:
< 0 : x < y= 0 : x == y> 0 : x > y
Suche (lookup)
Die Suche nutzt die Ordnungseigenschaft.
Prinzip:
- Beginne an der Wurzel.
- Vergleiche den gesuchten Wert
xmit dem aktuellen Knotenwertk. - Falls
x == k, dann Element gefunden. - Falls
x < k, dann suche im linken Teilbaum. - Falls
x > k, dann suche im rechten Teilbaum. - Wiederhole, bis das Element gefunden wird oder ein leerer Teilbaum erreicht ist.
Eigenschaften:
- Es wird immer nur ein Pfad vom Wurzelknoten nach unten verfolgt.
- Keine vollständige Durchsuchung des Baums nötig.
Das Suchen in einem Suchbaum erfordert im Durchschnitt eine Laufzeit der Ordnung \log_2(n), wenn der Baum nicht entartet ist. Das passiert beispielsweise, wenn die Elemente in auf- oder absteigender Reihenfolge eingefügt werden. Dann entartet der Baum zu einer Liste. Dann mutiert der Baum zu einer Liste. Ist er dagegen ausgewogen, beträgt die Höhe des Baumes \log_2(n) in Bezug auf die Anzahl der in ihm gespeicherten Elemente.
Einfügen (insert)
Prinzip:
Das Einfügen folgt exakt dem gleichen Pfad wie die Suche.
- Starte an der Wurzel.
- Vergleiche das neue Element
xmit dem aktuellen Knoten. - Gehe links oder rechts entsprechend der Ordnung.
- Erreiche einen leeren Teilbaum.
- Füge dort einen neuen Knoten mit
xein.
Duplikate:
Falls beim Vergleich
x == kgilt:- Das Element ist bereits im Baum.
- und wird nicht erneut eingefügt.
Dadurch bleibt die Mengen-Eigenschaft erhalten.
Löschen (delete)
Das Löschen ist die komplexeste Operation, da die Baumstruktur sowie die Invariante erhalten bleiben müssen.
Fall 1: Knoten ohne Kinder (Blatt)
Der Knoten wird einfach entfernt.
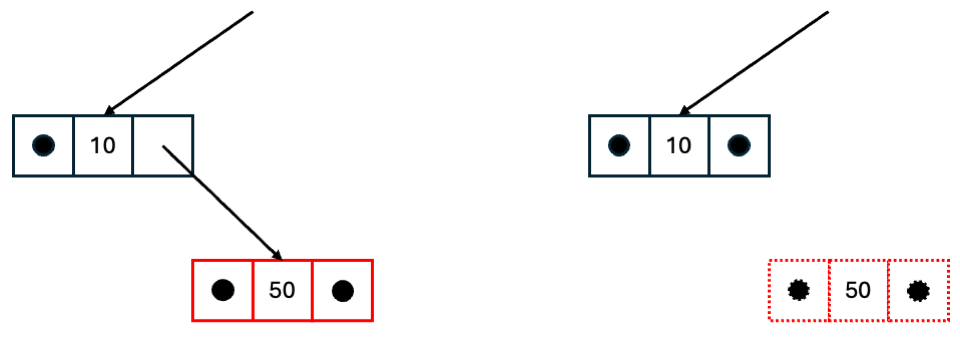
Löschen eines Knotens ohne Sohn Abbildung 5
Fall 2: Knoten mit genau einem Kind
Der Knoten wird entfernt.
Sein Kind rückt an seine Stelle.
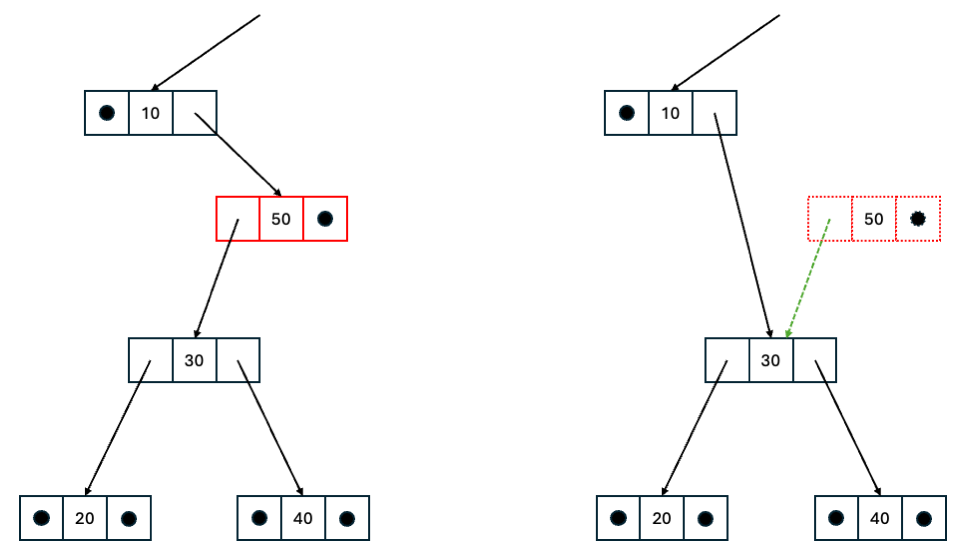
Löschen eines Knotens mit einem Sohn Abbildung 6
Fall 3: Knoten mit zwei Kindern
- Der Knoten wird nicht direkt entfernt.
- Stattdessen wird sein Wert ersetzt durch:
suche das größte Kind des linken Unterbaums
tausche dessen Inhalt mit dem des zu löschenden Knotens, der de facto im Baum verbleibt
lösche das größte Kind des linken Unterbaums
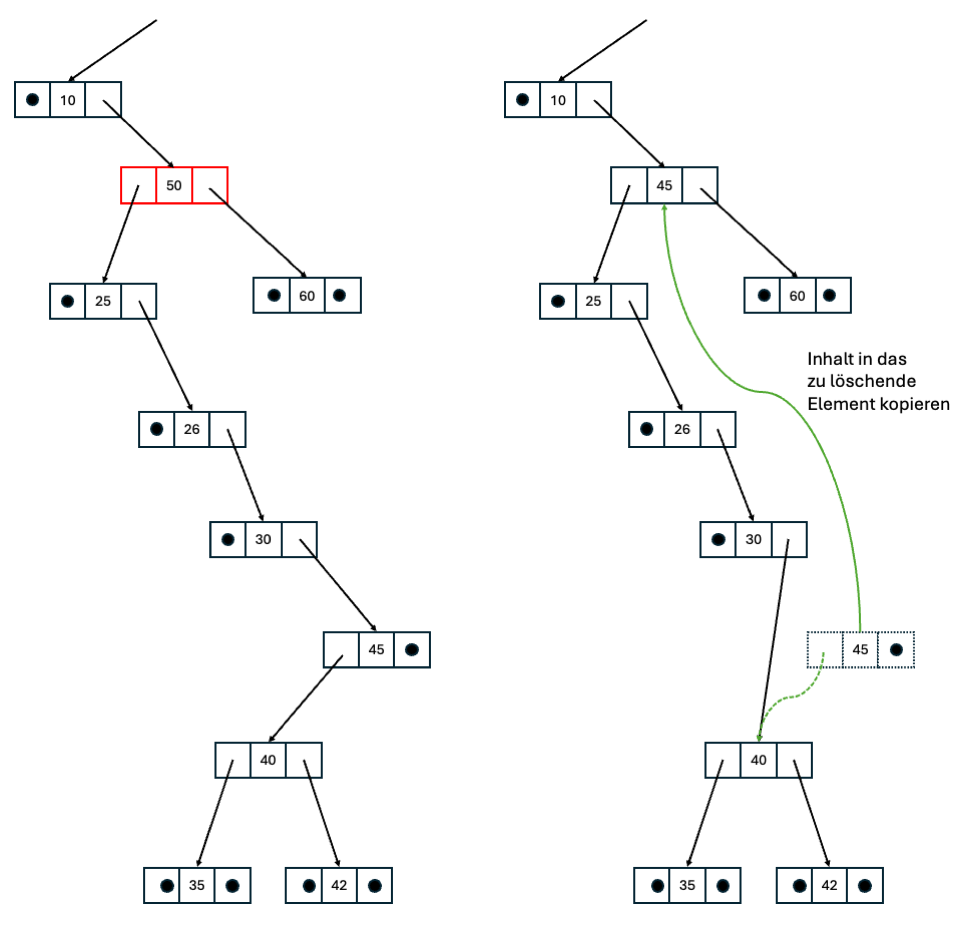
Löschen eines Knotens mit 2 Söhnen Abbildung 7
So bleibt die Suchbaum-Invariante erhalten.
package adt;

/**
 * Ein binärer Suchbaum, der das Interface {@link Set} implementiert.
 * Die Elemente werden basierend auf ihrer natürlichen Ordnung sortiert
 * gespeichert. Duplikate sind nicht erlaubt.
 *
 * @param <T> Elementtyp, muss vergleichbar sein
 */
public class SearchTree<T extends Comparable<? super T>>
        extends ReferenceTree<T>
        implements Set<T> {

    /**
     * Sucht nach einem Element im Baum.
     *
     * @param x Das zu suchende Element.
     * @return Das gefundene Element aus dem Baum oder {@code null},
     *         falls es nicht existiert.
     * @throws IllegalArgumentException wenn {@code x} {@code null} ist.
     */
    @Override
    public T lookup(T x) {
        if (x == null) throw new IllegalArgumentException("x ist null");

        Node<T> cur = root();   // beginne bei Wurzel
        while (cur != null) {   // solange ein Knoten vorliegt ...
            int cmp = x.compareTo(contentOf(cur));
            // wenn gefunden -> liefern
            if (cmp == 0) return contentOf(cur);
            // wenn kleiner -> links absteigen
            if (cmp < 0) cur = leftOf(cur);
            // größer -> rechts absteigen
            else         cur = rightOf(cur);
        }
        // nicht gefunden
        return null;
    }

    /**
     * Fügt ein neues Element in den Suchbaum ein, sofern es noch nicht
     * vorhanden ist.
     *
     * @param x Das einzufügende Element.
     * @return eingefügtes/gefundenes Element
     * @throws IllegalArgumentException wenn {@code x} {@code null} ist.
     */
    @Override
    public T insert(T x) {
        if (x == null) throw new IllegalArgumentException("x ist null");

        // leerer Baum -> neue Wurzel
        if (root() == null) {
            setRoot(newNode(x));
            return x;
        }

        // Platz zum Einfügen finden
        Node<T> cur = root();
        while (true) {
            int cmp = x.compareTo(contentOf(cur));
            if (cmp == 0) {
                // schon vorhanden -> nur Inhalt zurückgeben
                return contentOf(cur);
            }
            if (cmp < 0) {
                // links absteigen
                Node<T> left = leftOf(cur);
                if (left == null) {
                    // freier Platz -> einfügen, zurückgeben
                    setLeft(cur, newNode(x));
                    return x;
                }
                cur = left;
            } else {
                // rechts absteigen
                Node<T> right = rightOf(cur);
                if (right == null) {
                    // freier Platz -> einfügen, zurückgeben
                    setRight(cur, newNode(x));
                    return x;
                }
                cur = right;
            }
        }
    }

    // Hilfsmethode, um das Maximum in einem
    // linken Teilbaum zu suchen (muss rechts sein)
    private Node<T> findMax(Node<T> t) {
        while (rightOf(t) != null)
            t = rightOf(t);
        return t;
    }

    /**
     * Entfernt ein Element aus dem Suchbaum.
     * Dabei werden drei Fälle unterschieden:
     * 1. Der Knoten ist ein Blatt: Er wird einfach entfernt.
     * 2. Der Knoten hat ein Kind: Das Kind rückt an die Stelle des
     *    Knotens nach.
     * 3. Der Knoten hat zwei Kinder: im linken Kind-Baum den größten
     *    Knoten suchen, dessen Inhalt in den aktuellen Knoten
     *    übernehmen und löschen
     *
     * @param x Das zu löschende Element.
     * @return {@code true}, wenn das Element gefunden und
     *                       gelöscht wurde;
     *         {@code false}, falls das Element nicht im Baum
     *                        enthalten war.
     * @throws IllegalArgumentException wenn {@code x} {@code null} ist.
     */
    @Override
    public boolean delete(T x) {
        if (x == null) throw new IllegalArgumentException("x ist null");

        // Knoten suchen
        Node<T> parent = null;    // Hilfsknoten Vater
        Node<T> child = root();   // Hilfsknoten Sohn (init. mit Wurzel)

        // solange Knoten vorhanden und zu löschendes Element
        // nicht gefunden ...
        while (child != null && x.compareTo(contentOf(child))  != 0) {
            // Baum absteigen
            parent = child;
            if (x.compareTo(contentOf(child)) < 0)
                child = leftOf(child);
            else
                child = rightOf(child);
        }

        if (child != null) {
            // Element wurde gefunden -> Ersatzknoten suchen
            Node<T> substitute;  // Ersatzknoten

            // nur einen Sohn oder keine Söhne (Blatt -> übernimm null)
            if (leftOf(child) == null)
                // wenn linker Sohn leer -> rechter Sohn wird Ersatz
                substitute = rightOf(child);
            else if (rightOf(child) == null)
                // wenn rechter Sohn leer -> linker Sohn wird Ersatz
                substitute = leftOf(child);
            else {
            // 2-Söhne-Fall
                // Ersatzknoten ist Sohn selbst
                substitute = child;
                // Inhalt merken
                T tmp = contentOf(findMax(leftOf(substitute)));
                // Element aus Baum löschen löschen
                delete(tmp);
                // Ersatzknoten übernimmt gemerkten Inhalt
                setContent(substitute, tmp);
            }
            // Setze Ersatzknoten in Baum ein
            //
            // Sonderfall: Element war Wurzel
            if (parent == null)
                // Ersatzknoten wird neuer Wurzelknoten
                setRoot(substitute);
            // andernfalls prüfe, ob ...
            else if (x.compareTo(contentOf(root())) < 0)
                // Ersatzknoten neuer linker Knoten
                setLeft(parent, substitute);
            else
                // Ersatzknoten neuer rechter Knoten
                setRight(parent, substitute);
            return true;
        }

        else
            // Element wurde nicht gefunden
            return false;
    }

    /**
     * Sucht Einträge innerhalb der Bereichsgrenzen {@code start} und
     * {code@ stop}.
     *
     * @param start Startwert
     * @param stop Endwert
     * @param inclusiveStop inklusive/exklusive
     * @return Liste der gefundenen Objekte
     */
    public SingleLinkedList<T> findRange(T start, T stop, boolean inclusiveStop) {

        SingleLinkedList<T> resultList = new SingleLinkedList<>();

        class SearchHelper {

            void search(Node<T> n) {
                if (n == null)
                    return;
                if (start.compareTo(contentOf(n)) < 0)
                    search(leftOf(n));
                boolean in_range = false;
                if (inclusiveStop)
                    in_range = (!(contentOf(n).compareTo(start) < 0) &&
                                !(stop.compareTo(contentOf(n)) < 0));
                else
                    in_range = (!(contentOf(n).compareTo(start) < 0) &&
                                contentOf(n).compareTo(stop) < 0);
                if (in_range) {
                    resultList.insert(contentOf(n));
                    resultList.forward();
                }
                if (contentOf(n).compareTo(stop) < 0)
                    search(rightOf(n));
            }
        }

        SearchHelper sh = new SearchHelper();
        sh.search(this.root());
        return resultList;
    }
}
Der Suchbaum hat noch eine Methode findRange() bekommen, um auch Bereichssuche durchführen zu können.
Fallstudie: Cross-Referenz-Liste
Eine Cross-Referenz-Liste, wie wir sie hier implementieren wollen, erstellt eine Textanalyse und -statistik. Ein Text wird über die Standardeingabe gelesen und in Worte zerlegt. Als Wort gelten beliebige Zeichenfolgen aus den Buchstaben des deutschen Alphabets. Die Häufigkeit des Vorkommens der Worte, ohne Berücksichtigung von Groß- und Kleinschreibung, im Text wird gezählt. Zusätzlich wird ein Protokoll gepflegt, in dem festgehalten wird, in jeweils welcher Zeile des Textes das jeweilige Wort gefunden wurde.
Wir verwenden den Suchbaum aus dem vorangegangenen Abschnitt. In ihm speichern wir die gefundenen Worte. Aufgrund seiner Mengeneigenschaft, werden gleiche Worte nicht mehrfach eingefügt. Allerdings müssen die Worte gezählt und das jeweilige Protokoll des Vorkommens fortgeschrieben werden. Wir nutzen hierzu die Eigenschaft von insert(), uns eine Referenz auf das neue oder schon vorhandene Wort zurückzugeben. So können wir ein Wort versuchen einzufügen, um dann im Nachgang, ob gefunden oder neu eingefügt, dessen Statistik fortzuschreiben.
Das Datenelement, in welchem wir jeweils ein Wort speichern, muss das Interface Comparable bezüglich des in ihm gespeicherten Wortes erfüllen.
import adt.EnumList;
import adt.List;
import adt.SingleLinkedList;
import java.util.Enumeration;
/**
* Wort-Information für Cross-Referenz-Anwendungen.
* <p>
* Gespeichert werden:
* </p>
* <ol>
* <li>Wort</li>
* <li>Anzahl der Vorkommen</li>
* <li>Zeilennummern der Vorkommen</li>
* </ol>
*/
public final class WordInfo implements Comparable<WordInfo> {
private final String word; // normalisiert (lowercase)
private int count;
private final List<Integer> lines = new SingleLinkedList<>();
/**
* Konstruktor.
*
* @param word zu speicherndes Wort
*/
public WordInfo(String word) {
this.word = word;
count = 0;
}
/**
* Getter für den Wort-Inhalt.
*
* @return Wort
*/
public String word() { return word; }
/**
* Getter für die Häufigkeit des Vorkommens.
*
* @return Häufigkeit
*/
public int count() { return count; }
/**
* Liste vom Typ {@link adt.List} zur Speicherung der Zeilen,
* in denen das gespeicherte Wort vorkommt.
*
* @return Kopie der Liste
*/
public List<Integer> lines() {
List<Integer> linesCopy = new SingleLinkedList<>();
Enumeration<Integer> iterator = new EnumList<>(lines);
while (iterator.hasMoreElements())
linesCopy.insert(iterator.nextElement());
return linesCopy;
}
/**
* Aktualisierung der Wortstatistik (Anzahl, Zeilen)
*
* @param lineNo Zeile, in der das Wort gefunden wurde
*/
public void seenInLine(int lineNo) {
count++;
lines.insert(lineNo); // Wort einfügen
}
/**
* Implementierung der Schnittstelle {@link Comparable} unter
* Verwendung der in {@code String} implementierten Methode
* {@link String#compareTo}.
*
* @param o Vergleichsobjekt
* @return <0, wenn Objekt kleiner Vergleichsobjekt
* 0, wenn Objekt gleich Vergleichsobjekt
* >0, wenn Objekt größer Vergleichsobjekt
*/
@Override
public int compareTo(WordInfo o) {
String w1 = this.word.toLowerCase();
w1 = w1.replace("ä", "ae").replace("ö", "oe").replace("ü", "ue").replace("ß", "ss");
String w2 = o.word.toLowerCase();
w2 = w2.replace("ä", "ae").replace("ö", "oe").replace("ü", "ue").replace("ß", "ss");
return w1.compareTo(w2);
}
}Mit diesem Datenelement ist es nun einfach, das Programm CrossReference.java zu schreiben. Es liest seine Standardeingabe zeichenweise und sammelt die Zeichen für je ein Wort. Ist ein Wort gefunden, wird es in den Suchbaum eingesetzt. Über die zurückgegebene Referenz wird seenInLine() aufgerufen, um die Statistik des Wortes zu aktualisieren.
import java.util.Enumeration;

import adt.InorderTraverse;
import adt.SearchTree;
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Cross-Referenz-Anwendung.
 */
public class CrossReference {
    // Wort an Suchbaum übergeben und zurücksetzen
    private static void flushWord(SearchTree<WordInfo> tree,
                StringBuilder word,
                int lineNo) {

        if (!word.isEmpty()) {
            WordInfo newWordInfo = new WordInfo(word.toString());
            WordInfo returnedWordInfo = tree.insert(newWordInfo);
            returnedWordInfo.seenInLine(lineNo);
            word.setLength(0);
        }
    }

    /**
     * Über die Standardeingabe wird ein Text eingelesen und eine
     * Cross-Referenz-Statistik erstellt.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args)  {
        SearchTree<WordInfo> tree = new SearchTree<>();
        StringBuilder word = new StringBuilder();
        int lineNo = 1;
        char ch;

        while (StdIn.hasNextChar()) {
            ch = StdIn.readChar();

            if (ch == '\n') lineNo++;
            if (Character.isLetterOrDigit(ch)) {
                word.append(ch);
            }
            else if (!word.isEmpty()) {
                flushWord(tree, word, lineNo);
            }
        }
        // falls Text mit einem Buchstaben endet muss das entsprechende
        // Wort noch im Baum eingetragen werden.
        flushWord(tree, word, lineNo);

        // Inorder-Ausgabe der Wortstatistik
        Enumeration<WordInfo> it = new InorderTraverse<>(tree);
        while (it.hasMoreElements()) {
            WordInfo w = it.nextElement();
            StdOut.printf("%s: %d: %s%n", w.word(), w.count(), w.lines());
        }
    }
}
Beispielsitzung:
$ java CrossReference < oliver.txt
Abendessen: 1: [99]
aber: 5: [2, 70, 71, 92, 107]
Ach: 1: [53]
Adeligen: 1: [106]
ängstlichen: 1: [25]
Ärzten: 1: [26]
alle: 1: [58]
als: 7: [20, 24, 28, 40, 50, 79, 86]
Also: 1: [97]
alt: 1: [56]
alte: 2: [89, 96]
...
zog: 1: [83]
zu: 14: [11, 16, 19, 34, 36, 36, 51, 64, 70, 82, 99, 102, 108, 111]
zugegen: 1: [28]
zugesprochen: 1: [100]
zugewandt: 1: [47]
Zukunft: 1: [71]
zum: 1: [8]
zur: 1: [86]
zurück: 1: [69]
zusammen: 2: [59, 69]
zustoßen: 1: [15]
Zuversicht: 1: [72]
Zweck: 1: [36]
zwei: 1: [58]
zweifelhaft: 1: [10]
$ _
Fallstudie: Wörterbuchsuche
Als eine weitere Anwendung wollen wir eine Wörterbuchsuche mithilfe unsere Suchbaumes implementieren. Sie soll das Folgende leisten:
- Einlesen einer Wörterbuchdatei (ein Wort pro Zeile).
- Prefix-Suche: Wir geben die ersten Buchstaben als Suchbegriff ein. Der Suchbaum liefert alle Treffer.
- Bereichssuche: Wie geben ein Intervall von Präfixen als Suchbegriffe ein. Der Suchbaum liefert alle Worte, die in das so abgesteckte Intervall fallen.
RangeAutocomplete.java liest eine als Kommandozeilenargument angegebene Textdatei ein und baut aus den Worten einen Suchbaum auf. Ist das geschehen, kann der Anwender Worte im Text suchen. Er sucht nach Worten, die mit einer bestimmten Zeichenfolge beginnen oder nach Worten, die sich in einem bestimmten Bereich des Alphabets befinden.
Nach dem Start des Programms soll dem Anwender ein minimalistisches User-Interface angeboten werden. Über einzugebende Kommandos teilt er dem Programm mit, was es tun soll:
$ java RangeAutocomplete german_shuffled.txt
Index aufgebaut. Interaktive Abfragen:
Befehle: prefix <prefix> | range <von> <bis> | quit
>
Kommandos sind notwendig. Ohne entsprechende Kommandos können Suchmuster nicht von möglichen Kommandos unterschieden werden. Beispielsitzung:
$ java RangeAutocomplete data/oliver.txt
Index aufgebaut. Interaktive Abfragen:
Befehle: prefix <prefix> | range <von> <bis> | quit
> prefix Ol
Wörter mit Präfix "Ol":
Stop: Om
  Oliver (6) [16, 24, 31, 40, 106, 112]
1 Treffer
Befehle: prefix <prefix> | range <von> <bis> | quit
> range ma mz
Wörter im Bereich ["ma" .. "mz"]:
  machen (1) [105]
  männlichen (1) [37]
  man (6) [37, 50, 89, 90, 104, 109]
  matt (1) [43]
  mehr (2) [23, 49]
  meisten (1) [3]
  menschlichen (1) [15]
  mich (1) [44]
  mir (3) [58, 58, 82]
  mischte (1) [53]
  mit (8) [18, 31, 49, 55, 58, 68, 74, 83]
  möchte (2) [3, 13]
  Mrs (1) [74]
  Mühen (1) [9]
  mühsam (1) [44]
  murmelte (1) [96]
  muss (1) [91]
  Mutter (1) [61]
18 Treffer
Befehle: prefix <prefix> | range <von> <bis> | quit
> quit
Ende.
$ _
Die Aufgabe ist nicht trivial. Das folgende Diagramm zeigt Ihnen, welche Klassen mit welchen Methoden in meiner Musterlösung beteiligt sind. - Es steht Ihnen natürlich frei, eine ganz andere Lösung zu finden.
RangeAutocomplete beteiligten Klassenimport java.util.Enumeration;
import adt.EnumList;
import adt.SearchTree;
import adt.SingleLinkedList;
import StdLib.StdIn;
import StdLib.StdOut;
import StdLib.TxtFileIn;
/**
* Implementierung einer automatischen Bereichskomplettierung
* in Zusammenhang mit der Klasse {@link adt.SearchTree}.
*/
public class RangeAutocomplete {
// Ein Wort zum Suchbaum hinzufügen
private static void addWord(SearchTree<WordInfo> tree, String w, int lineNo) {
if (!w.isEmpty()) {
WordInfo key = new WordInfo(w);
tree.insert(key).seenInLine(lineNo);
}
}
// Suchbaum aufbauen
private static SearchTree<WordInfo> buildIndexFromFile(String filename) {
SearchTree<WordInfo> tree = new SearchTree<>();
int lineNo = 0;
TxtFileIn file = new TxtFileIn(filename);
while (file.hasNextLine()) {
String line = file.readLine();
if (line == null) break;
lineNo++;
StringBuilder word = new StringBuilder();
for (int i = 0; i < line.length(); i++) {
char ch = line.charAt(i);
if (Character.isLetterOrDigit(ch)) {
word.append(ch);
} else {
if (!word.isEmpty()) {
addWord(tree, word.toString(), lineNo);
word.setLength(0);
}
}
}
if (!word.isEmpty()) {
addWord(tree, word.toString(), lineNo);
}
}
file.close();
return tree;
}
// Präfix-Suche
private static void queryPrefix(SearchTree<WordInfo> tree, String wordPrefix) {
StdOut.printf("Wörter mit Präfix \"%s\":%n", wordPrefix);
String stopStr = "";
if (wordPrefix != "")
stopStr = wordPrefix.substring(0, wordPrefix.length()-1)
+ (char)((int)wordPrefix.charAt(wordPrefix.length()-1)+1);
System.out.println("Stop: " + stopStr);
WordInfo startDummy = new WordInfo(wordPrefix);
WordInfo stopDummy = new WordInfo(stopStr);
SingleLinkedList<WordInfo> result = tree.findRange(startDummy, stopDummy, false);
int hits = 0;
Enumeration<WordInfo> it = new EnumList<>(result);
while (it.hasMoreElements()) {
WordInfo w = it.nextElement();
StdOut.printf(" %s (%d) %s%n", w.word(), w.count(), w.lines());
hits++;
}
StdOut.printf("%d Treffer%n", hits);
}
// Bereichssuche
private static void queryRange(SearchTree<WordInfo> tree, String fromWord, String toWord) {
WordInfo from = new WordInfo(fromWord);
WordInfo to = new WordInfo(toWord);
StdOut.printf("Wörter im Bereich [\"%s\" .. \"%s\"]:%n", fromWord, toWord);
SingleLinkedList<WordInfo> result = tree.findRange(from, to, true);
int hits = 0;
Enumeration<WordInfo> it = new EnumList<>(result);
while (it.hasMoreElements()) {
WordInfo w = it.nextElement();
String s = w.word();
StdOut.printf(" %s (%d) %s%n", s, w.count(), w.lines());
hits++;
}
StdOut.printf("%d Treffer%n", hits);
}
// Kommando-Interface
private static void commandLoop(SearchTree<WordInfo> tree) {
while (true) {
StdOut.println("Befehle: prefix <prefix> | range <von> <bis> | quit");
StdOut.print("> "); // <<< PROMPT
if (!StdIn.hasNextLine()) return; // einfach Return: EOF -> Ende
String[] parts = StdIn.readlnStrings();
if (parts.length == 0 || parts[0].isEmpty()) continue;
String cmd = parts[0].toLowerCase();
switch (cmd) {
case "quit" -> {
StdOut.println("Ende.");
return;
}
case "prefix" -> {
if (parts.length < 2) StdOut.println("Fehler: prefix <prefix>");
else queryPrefix(tree, parts[1]);
}
case "range" -> {
if (parts.length < 3) StdOut.println("Fehler: range <von> <bis>");
else queryRange(tree, parts[1], parts[2]);
}
default -> StdOut.println("Unbekannter Befehl.");
}
}
}
/**
* Suchbaum-Operationen nachdem eine Datei eingelesen wurde.
* <p>
* Operationen:
* </p>
* <ul>
* <li>Präfix-Suche</li>
* <li>Bereichssuche</li>
* <li>Programm beenden</li>
* </ul>
* @param args Dateiname
*/
void main(String[] args) {
if (args.length < 1) {
StdOut.println("Aufruf: java RangeAutocomplete <datei>");
return;
}
SearchTree<WordInfo> tree = buildIndexFromFile(args[0]);
StdOut.println("Index aufgebaut. Interaktive Abfragen:");
commandLoop(tree);
}
}Im Begleitmaterial finden Sie, neben oliver.txt, einem Auszug aus Oliver Twist vom Autor Charles Dickens, auch zwei Wörterbuchdateien. Die eine ist sortiert, die andere, mit shuffeled im Dateinamen, nicht. Sie enthalten jeweils 2,152,638 Worte. Versuchen Sie sie in Ihrem Programm zu laden.
Tipp: Brechen Sie das Laden der sortierten Datei ruhig ab (CTRL-C).
Überlegen Sie, warum das Laden der sortierten Datei ewig dauert, das Laden der shuffeled-Datei aber schnell geht. - Wenn Sie die Antwort wissen, ist dies ein gutes Zeichen dafür, dass Sie binäre Bäume verstanden haben! Wir haben nun gesehen, dass die Leistungsfähigkeit eines Suchbaums nicht nur vom Algorithmus, sondern entscheidend von der Einfüge-Reihenfolge der Daten abhängt.
Laufzeitverhalten binärer Bäume
Die Laufzeit hängt von der Höhe des Baums ab.
- Idealfall (balanciert):
- Höhe: \mathcal{O}(\log_2(n))
- lookup, insert, delete: \mathcal{O}(\log_2(n))
- Schlechtester Fall (entartet, sortierte Einfügefolge):
- Höhe: \mathcal{O}(n)
- Operationen:
- Suchen/Löschen/Einfügen: \mathcal{O}(n)
- Aufbau eines Baumes aus n sortierten Elementen: \mathcal{O}(n^2)
Ein einfacher SearchTree ist nicht selbstbalancierend. AVL-, Red-Black-Bäume lösen dieses Problem.