Graphen
Graphen stellen ein weites und interessantes Betätigungsfeld dar. Wenn Sie Informatik studieren, werden Sie sich allein mindestens ein Semester speziell mit dieser Datenstruktur auseinandersetzen. Das kann dieses Seminar nicht leisten. Graphen sind jedoch auch ein vielfältiges Anwendungsgebiet für die ADTs, die wir uns in den vergangenen Kapiteln erarbeitet haben. In Bezug auf Graphen stellen Sie in ihrer Summe einen Werkzeugkasten bereit, der es ihnen ermöglicht, Graphen leicht, elegant und effizient zu verarbeiten. Aus diesem Grund, Ihnen dies beispielhaft zu demonstrieren, behandeln wir in diesem Kapitel ausgewählte Graphen und Graphalgorithmen.
Ein Graph ist eine abstrakte Struktur zur Darstellung von paarweisen Beziehungen zwischen Objekten, bestehend aus einer Menge von Knoten (Ecken) und verbindenden Kanten.
Ein gerichteter Graph G = (V, E) besteht aus Knotenmenge V (Vertices) und Kantenmenge E \subseteq V \times V (Edges).
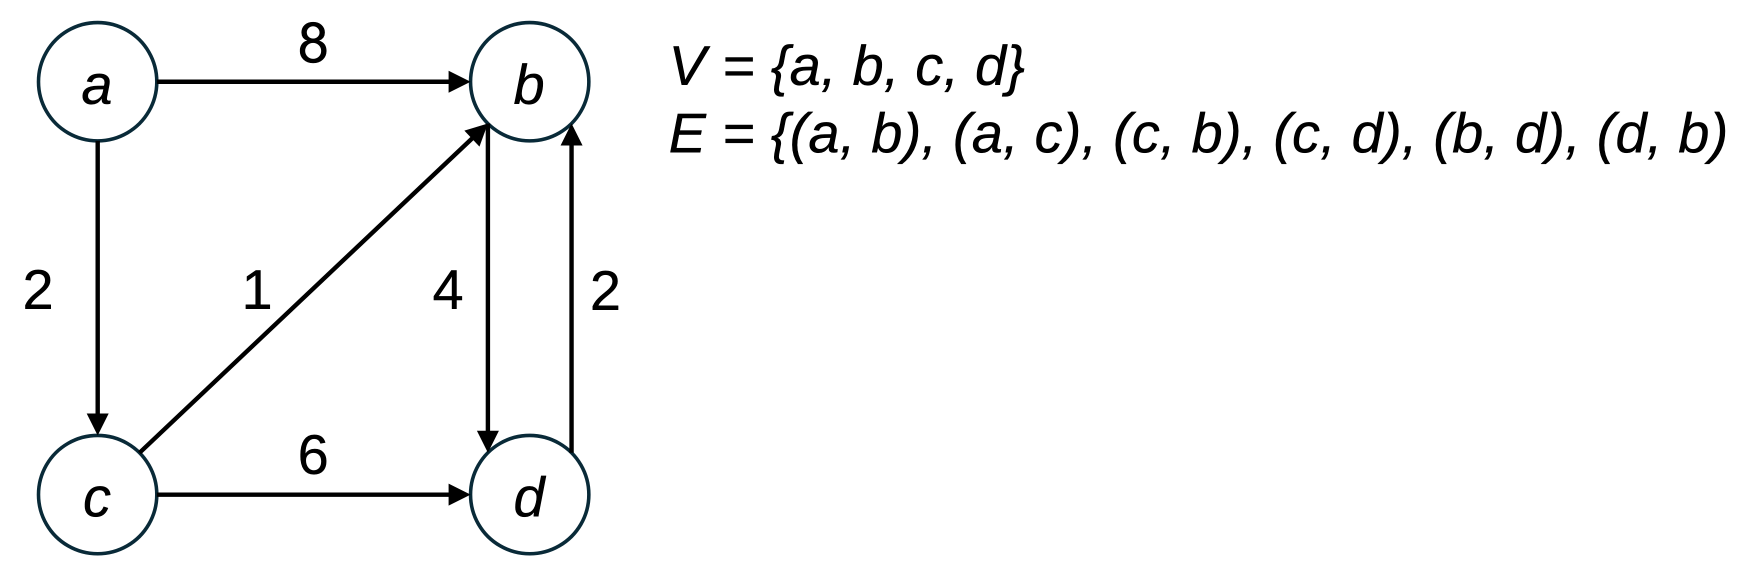
Ein ungerichteter Graph G = (V, E) besteht aus Knotenmenge V und Kantenmenge E \subseteq P_2(V). Dabei sind P_2(V) alle 2-elementigen Teilmengen von V.
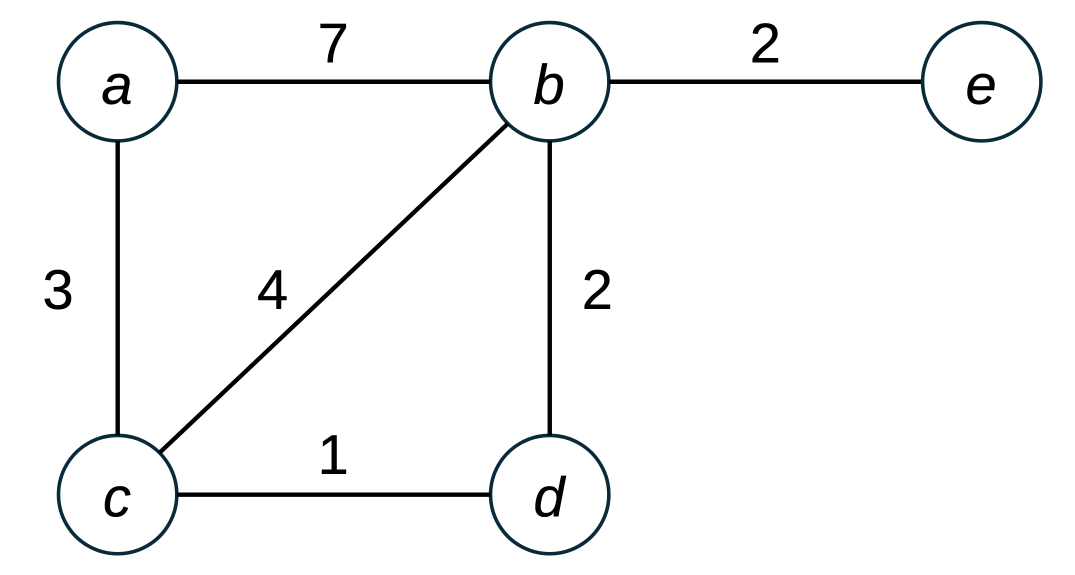
Kanten können gewichtet sein durch eine Kostenfunktion c: E \rightarrow \mathbb{R}. In vielen Anwendungen sind diese Kosten nicht-negativ (z.B. Entfernungen oder Zeiten). Sie modellieren Entfernungen, Zeitdauern oder sonstige Aufwände.
Mittels Graphen können binäre Beziehungen zwischen Objekten modelliert werden. Die Objekte werden durch die Knoten, die Beziehungen durch die Kanten abgebildet.
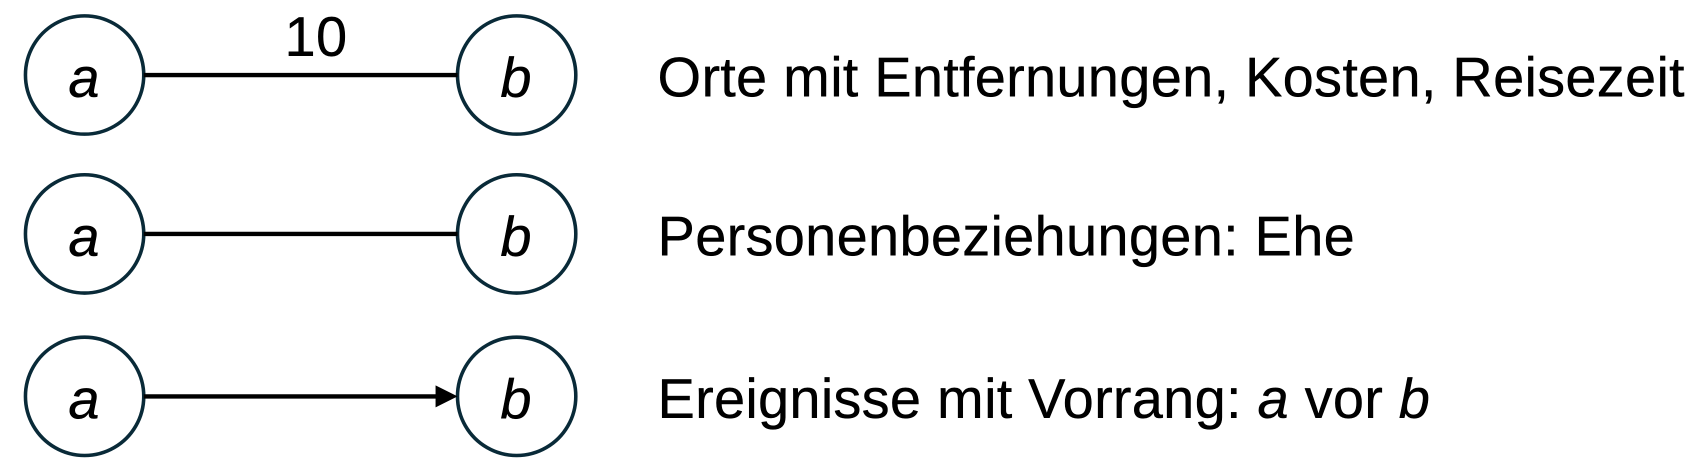
In der Graphentheorie existieren ein paar Begriffe, die man kennen sollte. Ich habe sie, um sie gleich zu visualisieren, in den folgenden zwei Skizzen notiert.
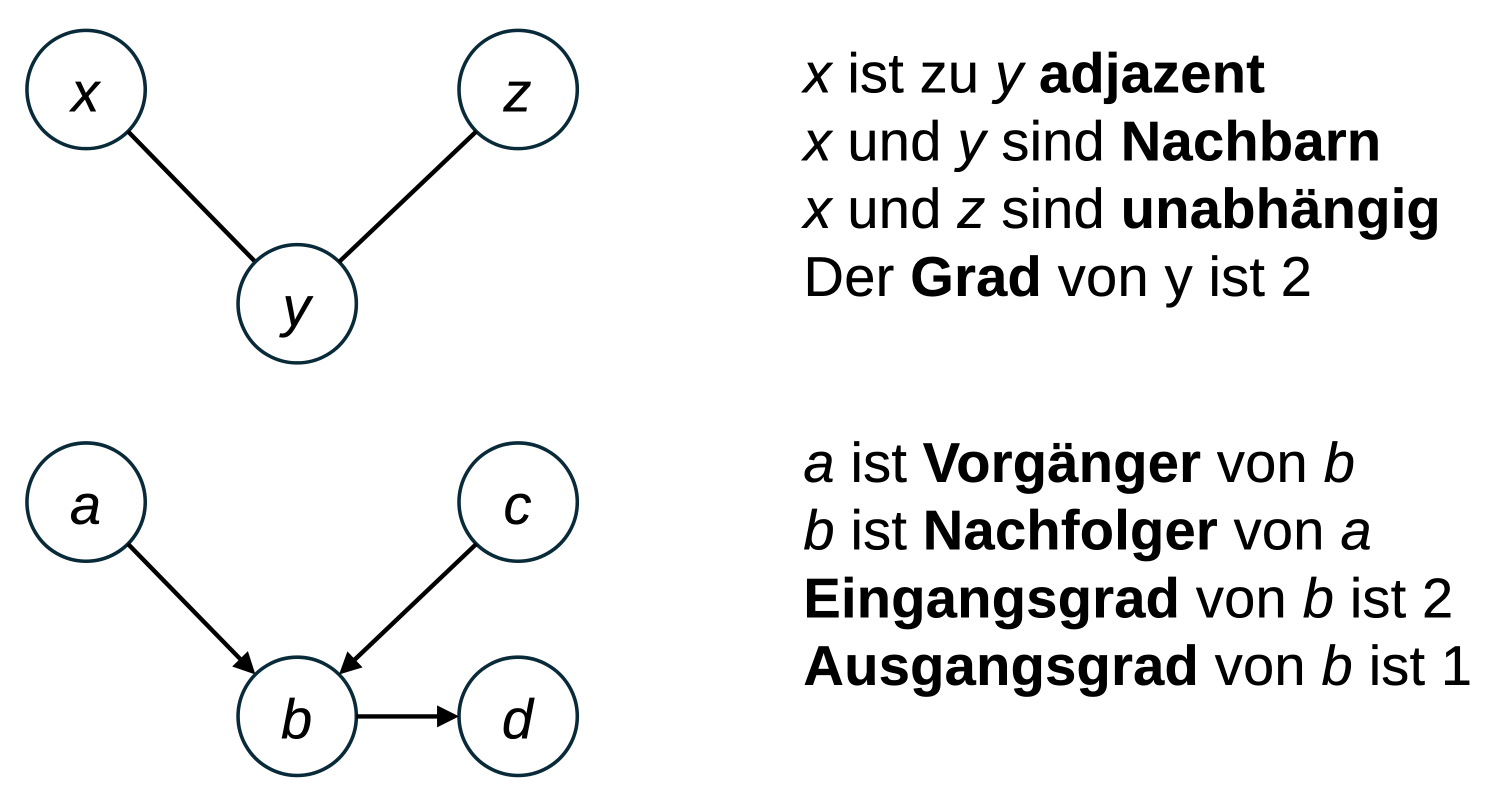
Wir nennen eine Kante (x,y) inzident zum Knoten x und zum Knoten y. Ein Weg ist eine Folge von Knoten v_0, v_1, \dots, v_k, sodass zwischen v_{i-1} und v_i jeweils eine Kante existiert. Bei einem Kreis gilt: v_0 = v_k.
Implementierung von Graphen
Es sei jedem Knoten ein eindeutiger Index zugeordnet. Damit können wir Graphen mit Arrays (und später Matrizen) abbilden. Bei nicht-numerischen Knotennamen benötigen wir eine schnelle Zuordnung von Namen zu Indizes (z. B. über eine Hash-Tabelle). Für den gerichteten Graphen (Abbildung 1) ergibt sich:
| Index | Knoten |
|---|---|
| 0 | a |
| 1 | b |
| 2 | c |
| 3 | d |
Implementierung durch Adjazenzmatrizen
Kanten ohne Bewertung:
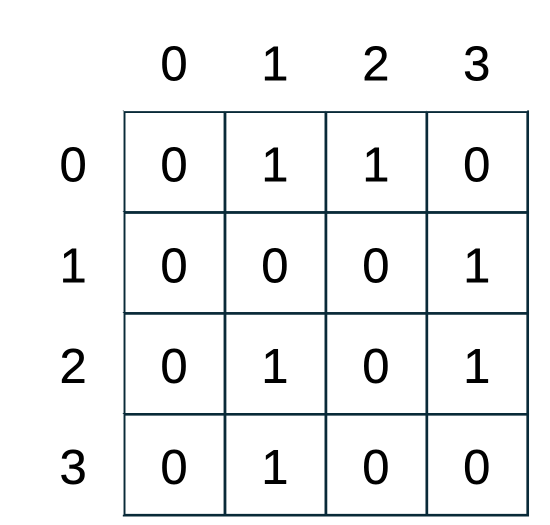
m[i][j]:= \left\{ \begin{array}{ll} 1, & \text{falls } (i,j) \in E \\ 0 & sonst \end{array} \right.
Gerichtete Kanten mit Bewertung:
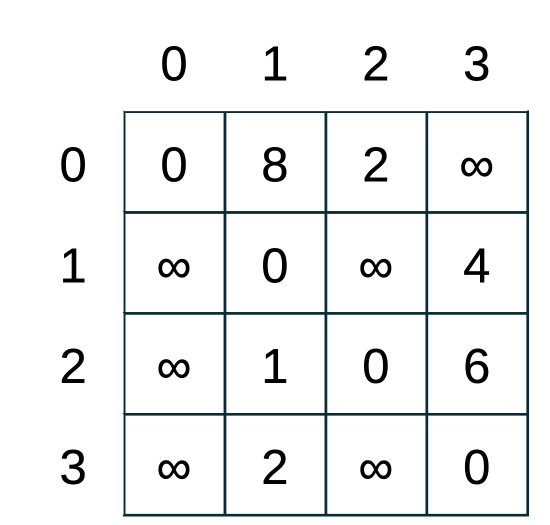
m[i][j]:= \left\{ \begin{array}{ll} c(i, j), & \text{falls } (i,j) \in E \\ 0 & \text{falls } i = j \\ \infty & \text{sonst} \end{array} \right.
Eigenschaften von Adjazenzmatrizen:
- Speicherplatzbedarf = \mathcal{O}(|V|^2)
- Direkter Zugriff auf Kante (i, j) in konstanter Zeit möglich.
- Kein effizientes Verarbeiten der Nachbarn eines Knotens.
- Sinnvoll bei dicht besetzten Graphen.
- Sinnvoll bei Algorithmen, die wahlfreien Zugriff auf eine Kante erfordern.
Implementierung gerichteter Graphen durch klassische Adjazenzlisten
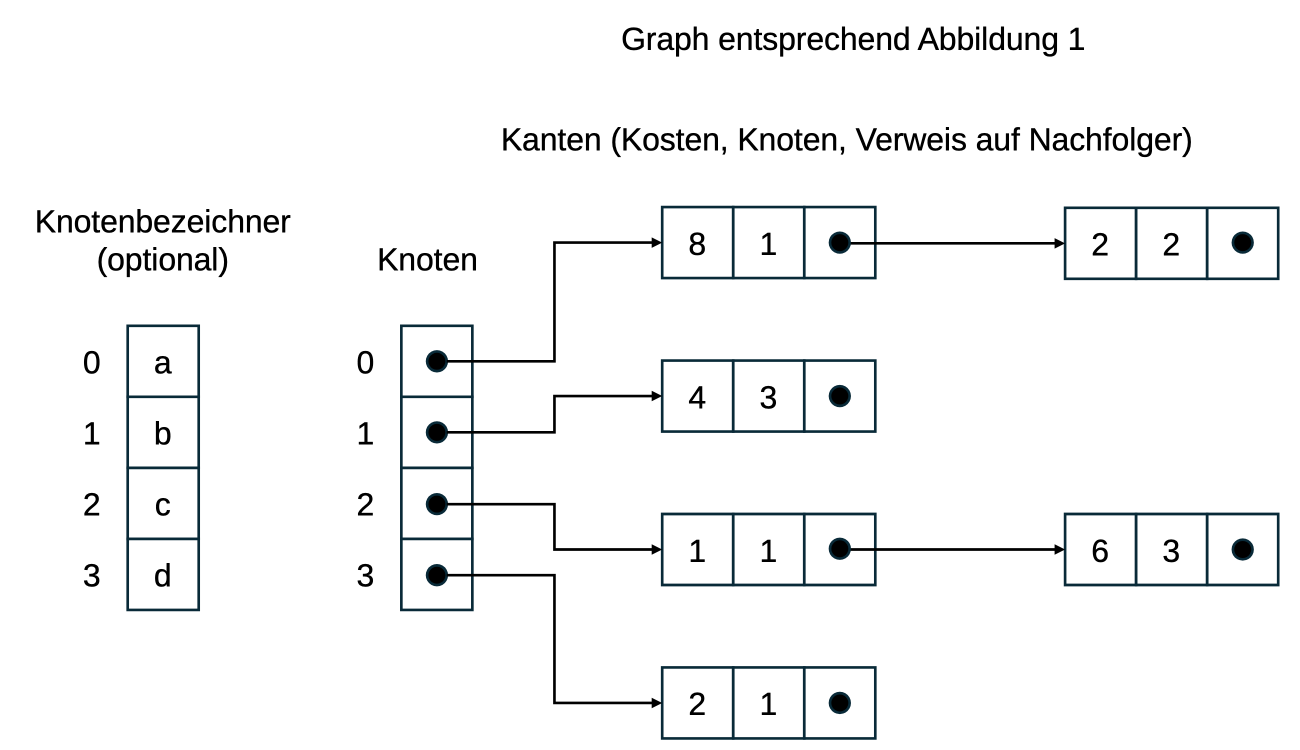
Wenn die Knoten des Graphen über ihren Index identifiziert werden, bietet sich zusätzlich zum Namens-Array (eine Hash-Tabelle als Hash-Map) ein Array von Integer-Listen an. Die an Position i beginnende Liste enthält die Nachbarn von i, genauer gesagt, sie enthält die Indizes der Nachbarn von i. Für bewertete Graphen muss ein Listeneintrag innerhalb der i-ten Liste neben der Knotennummer j auch die Kosten der Kante (i, j) enthalten. Für den obigen gerichteten Graphen (Abbildung 1) ergibt sich dann sich dann das folgende Schema:
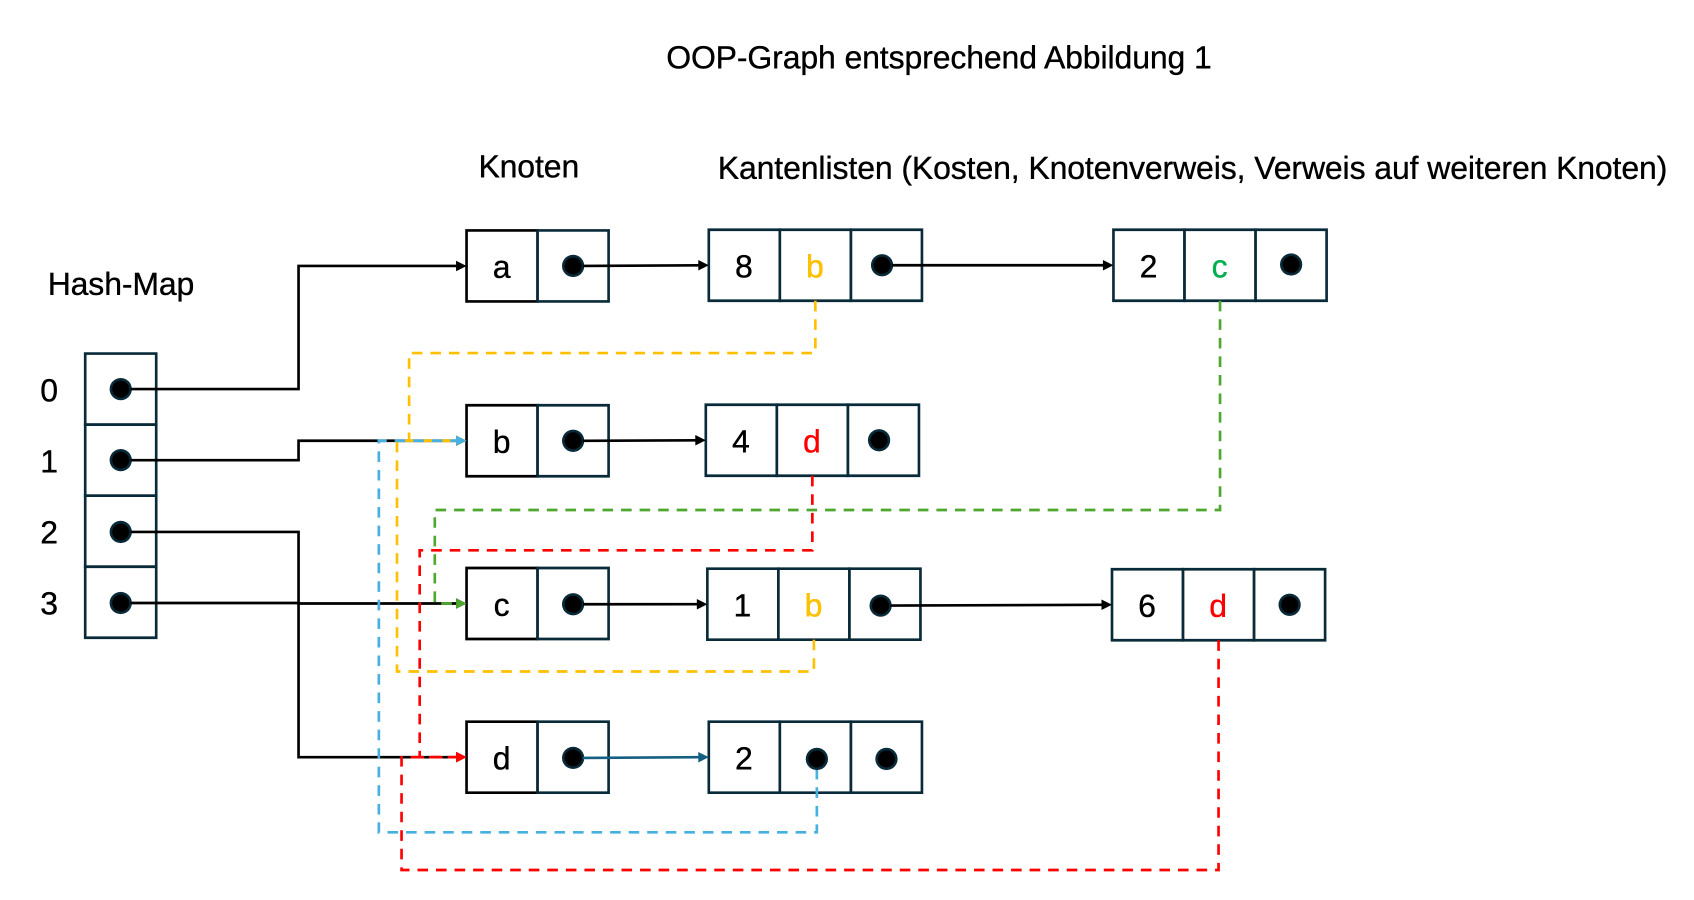
Eine objektorientierte Codierung modelliert die Knoten als Objekte, welche ihren Namen als String speichern und ihre Nachbarn als Kantenliste. Die Einträge der Kantenliste bestehen jeweils aus den Kosten der Kante und einem Verweis auf den Zielknoten, mit dem sie verbinden. Über ein assoziatives Array (implementiert als Hash-Map) gelangt man vom Namen eines Knotens zu seinem Objekt. Für den gerichteten Graphen auf Seite ergibt sich dann das folgende Schema:
Eigenschaften von Adjazenzlisten:
- Speicherplatzbedarf = \mathcal{O}(|E|)
- Kein effizienter Zugriff auf Kante (x, y) möglich.
- Sinnvoll bei dünn besetzten Graphen.
- Sinnvoll bei Algorithmen, die gegeben ein Knoten x, dessen Nachbarn verarbeiten müssen.
Graphalgorithmen für Adjazenzmatrizen gerichteter Graphen
Die Klasse Floyd löst das all-pairs-shortest-path-Problem mit dem Algorithmus von Floyd. Für eine (n × n)-Ausgangsmatrix C (Adjazenzmatrix) mit den Kantenkosten werden sukzessive die (n × n)-Matrizen D^0, D^1, D_2, \dots, D_{n-1} (Distanzmatrizen) berechnet. Die Matrix D^k enthält die Kosten der kürzesten Wege zwischen zwei Knoten i und j, die als Zwischenknoten nur die Knoten 0, 1, 2, \dots, k verwenden. Setze D^{-1} := C (Initialisierung der Kantenkosten). Dann lässt sich {D^k}_{i,j} errechnen durch das Minimum von D_{i,j}^{k-1} und D_{i,k}^{k-1} + D_{k,j}^{k-1}.
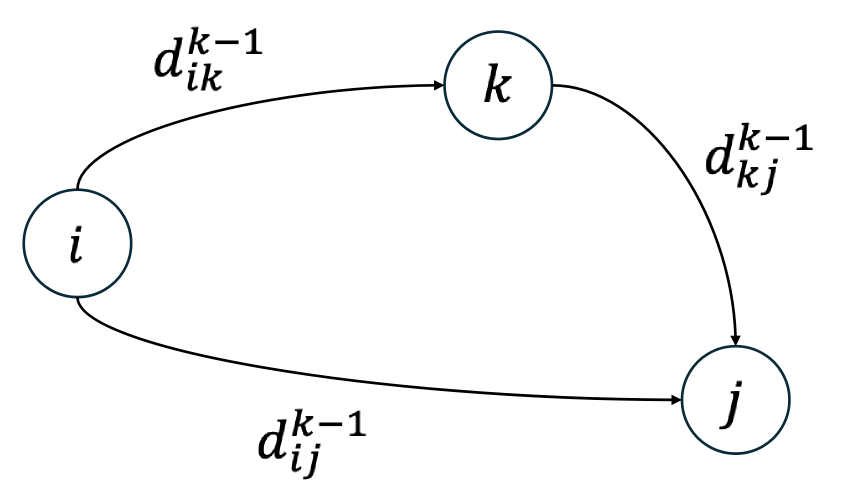
Beispiel
Für den Weg von Knoten a nach d haben wir:
- a nach b mit Kosten 8 und a nach c mit Kosten 2.
- Wegen c nach b mit Kosten 1 udn 2 + 1 = 3 < 8 ist der kürzeste Weg von a nach b, den wir uns merken (a, b) mit Kosten 3
- Von b nach d betragen die Kosten 4. Also betragen die Kosten für (a, d) 3 + 4 = 7.
Um auch die zugehörige Kantenfolge rekonstruieren zu können, wird parallel dazu eine Folge von (n × n)-Matrizen P^0, P^1, P^2, \dots, P^{n-1} aufgebaut, die an Position P_{i,j}^k den vorletzten Knoten auf dem kürzesten Weg von i nach j notiert, der nur über die Zwischenknoten 0, 1, 2, \dots, k läuft.
package graph;

/**
 * Implementierung des Floyd-Algorithmus (<em>all-pairs-shortest-path</em>).
 */
public class Floyd {
    /**
     * Floyd-Algorithmus.
     *
     * @param n Matrix-Dimension
     * @param c Adjazenz-Kosten-Matrix
     * @param d errechnete Distanzmatrix
     * @param p errechnete Wegematrix
     */
    public static void floyd(int n,          // Matrix-Dimension
                             double[][] c,   // Adjazenzmatrix mit Kosten
                             double[][] d,   // errechnete Kostenmatrix
                             int   [][] p) { // errechnete Wegematrix
        int i, j, k;                         // Laufvariablen

        // Initialisierung
        for (i = 0; i < n; i++) {            // für jede Zeile
            for (j = 0; j < n; j++) {        // für jede Spalte
                d[i][j] = c[i][j];           // initialisiere Kantenkosten
                p[i][j] = i;                 // vorletzte Knoten
            }
        }                                    // D^-1

        for (k = 0; k < n; k++) {            // für jede Knotenobergrenze
            for (i = 0; i < n; i++) {        // für jede Zeile
                for (j = 0; j < n; j++) {    // für jede Spalte
                    // prüfe, ob Abkürzung möglich
                    if (d[i][k] + d[k][j] < d[i][j]) {
                        // wenn ja, notiere Abkürzung
                        d[i][j] = d[i][k] + d[k][j];
                        // und vorletzten Knoten
                        p[i][j] = p[k][j];
                    }
                }
            }
        } // D^k
    }
}
Mit dem folgenden Treiber-Programm testen wir die Klasse Floyd.
import StdLib.StdOut;
import graph.Floyd;

/**
 * Testclient für die Klasse {@link graph.Floyd}.
 */
public class FloydTest {
    final static double INF = Double.POSITIVE_INFINITY;

    // Matrix ausgeben
    private static void printMatrix(double[][] m) {
        for (int i = 0; i < m.length; i++) {
            for (int j = 0; j < m.length; j++) {
                if (m[i][j] == INF) StdOut.print("   INF");
                else                StdOut.printf("%6.1f", m[i][j]);
            }
            StdOut.println();
        }
        StdOut.println();
    }

    // Hilfsmethode zur Pfad-Rekonstruktion
    private static String printPath(int[][] p,
                                    int i,
                                    int j,
                                    String path) {
        if (i == j) return path + i;
        else {
            path = printPath(p, i, p[i][j], path) + "-";
            return path + j;
        }
    }

    // Pfad ausgeben
    private static void printPathMatrix(int[][] p, double[][] d) {
        String path = "";
        for (int i = 0; i < p.length; i++) {
            for (int j = 0; j < p[i].length; j++) {
                if (d[i][j] == INF) StdOut.printf("%10s", "???");
                else {
                    path = printPath(p, i, j, "");
                    StdOut.printf("%10s", path);
                }
            }
            StdOut.println();
        }
    }

    public static void main(String[] args) {
        final int N = 4;
        double[][] C = {{0.0, 8.0, 2.0, INF},     // Kostenmatrix
                        {INF, 0.0, INF, 4.0},
                        {INF, 1.0, 0.0, 6.0},
                        {INF, 2.0, INF, 0.0}};

        double[][] D = new double[N][N];  // errechnete Distanzmatrix
        int   [][] P = new int   [N][N];  // vorletzter Knoten auf Weg

        StdOut.println("Gegebene Kostenmatrix:");
        printMatrix(C);

        Floyd.floyd(N, C, D, P);
        StdOut.println("Errechnete Distanzmatrix:");
        printMatrix(D);

        StdOut.println("Errechnete Wegematrix:");
        printPathMatrix(P, D);
    }
}
Wir verwenden den Graphen in Abbildung 1 als Eingabe und erhalten die folgende Ausgabe.
Gegebene Kostenmatrix:
   0.0   8.0   2.0   INF
   INF   0.0   INF   4.0
   INF   1.0   0.0   6.0
   INF   2.0   INF   0.0

Errechnete Distanzmatrix:
   0.0   3.0   2.0   7.0
   INF   0.0   INF   4.0
   INF   1.0   0.0   5.0
   INF   2.0   INF   0.0

Errechnete Wegematrix:
         0     0-2-1       0-2   0-2-1-3
       ???         1       ???       1-3
       ???       2-1         2     2-1-3
       ???       3-1       ???         3
Der Weg von Knoten a zu Knoten d kostet 7 Einheiten und führt, so wie manuell ermittelt, über c und b nach d.
Der Floyd-Algorithmus hat eine Laufzeit von \mathcal{O}(n^3). In den Zeilen 27 bis 39 von Floyd.java haben wir drei ineinander geschachtelte for-Schleifen, die jeweils n-mal durchlaufen werden. Das ist typisch für viele Graphalgorithmen.
Objektorientierte Implementierung gerichteter Graphen durch Adjazenzlisten
Wir orientieren uns am Schema von Abbildung 8.
Jeder Knoten der Klasse Vertex enthält eine Liste von Kanten; jede Kante der Klasse Edge besteht aus Kosten und Zielknoten. Die Klasse Graph realisiert den Graph als Assoziation von Knotennamen und Knoten. Die Klasse GraphIO liest einen Graph aus einer Datei ein und zeigt seine Adjazenzlisten an. Die Klasse Result enthält Routinen zum Anzeigen einer Lösung, welche von dem jeweiligen Algorithmus in den Arbeitsvariablen (AlgoFields) der Knoten hinterlegt wurde. Die Klasse GraphTest, das Treiberprogramm, liest einen gerichteten Graphen ein und wendet verschiedene Graphalgorithmen darauf an.
Die Klasse Vertex
Die für verschiedene Algorithmen relevanten Arbeitsvariablen werden zentral in der Klasse Vertex implementiert. Sie sind seitens eines jeden Algorithmus zurückzusetzen. Das besorgt die Methode resetAlgoFields().
Ein Knoten hat einen Namen und eine Liste der von ihm ausgehenden Kanten.
Knoten müssen miteinander verglichen werden können. Die dabei entscheidende Größe sind die in einem Knoten kumulierten Kosten. Ein Knoten implementiert daher die Schnittstelle Comparable.
package graph;
import adt.EnumList;
import adt.List;
import adt.SingleLinkedList;
/**
* Repräsentation eines Knotens.
*/
public class Vertex implements Comparable<Vertex>{
private static final double INF = Double.POSITIVE_INFINITY;
private final String name; // Name es Knotens
private final List<Edge> edges; // Nachbarn als Knotenliste
/* AlgoFields - berechnete Datenfelder */
private int nr = -1; // Knotennummer
private int indegrees = 0; // Eingangsgrad
private double cost = INF; // Kosten für diesen Knoten
private boolean seen = false; // Besuchsstatus
private Vertex prev = null; // Vorgänger des Knotens
/**
* Konstruktor für einen Knoten.
*
* @param name Name des Knotens
* @throws IllegalArgumentException wenn Name leer oder null
*/
public Vertex(String name) {
if (name == null || (name.trim()).isEmpty())
throw new IllegalArgumentException("Name darf nicht leer oder null sein.");
this.name = name; // Name des Knotens
edges = new SingleLinkedList<Edge>(); // initialisiere Nachbarschaftsliste
}
/**
* Prüfung, ob Knoten in Nachbarschaftsliste.
*
* @param vertex zu prüfender Knoten
* @return {@code true}, wenn Knoten enthalten, sonst {@code false}
*/
public boolean hasEdge(Vertex vertex) {
Edge e;
EnumList<Edge> iter = new EnumList<>(edges);
while (iter.hasMoreElements()) {
e = iter.nextElement();
if (e.getDest() == vertex)
return true;
}
return false;
}
/**
* Vergleich von Knoten und anderem Knoten.
*
* @param other anderer Knoten
* @return <0, wenn Knoten kleiner anderem Knoten<br>
* >0, wenn Knoten größer anderem Knoten<br>
* 0, wenn Knoten gleich sind
*/
@Override
public int compareTo(Vertex other) {
return Double.compare(this.cost, other.cost);
}
/**
* Namen des Knoten liefern.
*
* @return Knotenname
*/
public String getName() { return name; }
/**
* Nummer des Knoten liefern.
*
* @return Knotennummer
*/
public int getNr() { return nr; }
/**
* Setzen der Knotennummer.
*
* @param nr Knotennummer
* @throws IllegalArgumentException wenn Knotennummer negativ
*/
public void setNr(int nr) {
if (nr < 0)
throw new IllegalArgumentException(
"Knoten kann nicht negativ sein.");
this.nr = nr;
}
/**
* Eingangsgrad des Knoten liefern.
*
* @return Eingangsgrad
*/
public int getIndegrees() { return indegrees; }
/**
* Eingangsgrad des Knoten setzen.
*
* @param indegrees Eingangsgrad
* @throws IllegalArgumentException wenn Eingangsgrad kleiner als 0
*/
public void setIndegrees(int indegrees) {
if (indegrees < 0)
throw new IllegalArgumentException(
"Eingangsgrad kann nicht negativ sein.");
this.indegrees = indegrees;
}
public void decIndegree() {
indegrees--;
}
public void incIndegrees() {
indegrees++;
}
/**
* Kosten/Distanz des Knotens liefern.
*
* @return Kosten/Distanz
*/
public double getCost() { return cost; }
/**
* Setzen der Kosten/Distanz des Knotens.
*
* @param cost Kosten/Distanz
*/
public void setCost(double cost) {
this.cost = cost;
}
/**
* Besuchsstatus liefern.
*
* @return Besuchsstatus
*/
public boolean getSeen() { return seen; }
public void setSeen(boolean seen) {
this.seen = seen;
}
/**
* Vorgängerknoten liefern.
*
* @return Vorgängerknoten
*/
public Vertex getPrev() { return prev; }
/**
* Vorgängerknoten setzen.
*
* @param prev Vorgängerknoten
*/
public void setPrev(Vertex prev) {
this.prev = prev;
}
/**
* Rückgabe der Kantenliste.
*
* @return Kantenliste
*/
public List<Edge> getEdges() {
return edges;
}
/**
* Hinzufügen einer Kante.
*
* @param edge Kante
* @throws IllegalArgumentException wenn Kante gleich null
*/
public void addEdge(Edge edge) {
if (edge == null)
throw new IllegalArgumentException(
"Kante kann nicht null sein.");
edges.insert(edge);
}
/**
* Zurücksetzen der berechneten Arbeitsvariablen.
*/
public void resetAlgoFields() {
nr = -1;
indegrees = 0;
cost = Double.POSITIVE_INFINITY;
seen = false;
prev = null;
}
}Die Klasse Edge
In einer Kante speichern wir den Zielknoten der Kante und die für die Zielerreichung anfälligen Kosten. Der Startknoten einer Kante ergibt sich aus der Modellierung der Knoten. Jeder Knoten verwaltet eine Liste der von ihm ausgehenden Kanten, sodass wir zu jeder Kante die entscheidenden Parameter kennen: Startknoten, Zielknoten, Kosten.
package graph;

/**
 * Repräsentation einer Kante.
 */
public class Edge {

    private final Vertex dest;     // Zielknoten der Kante
    private final double cost;     // Kosten der Kante

    /**
     * Konstruktor für eine Kante.
     *
     * @param dest Zielknoten
     * @param cost Kosten
     * @throws IllegalArgumentException falls Zielknoten null
     */
    public Edge(Vertex dest, double cost) {
        if (dest == null)
            throw new IllegalArgumentException(
                "Knoten kann nicht null sein.");
        this.dest = dest;
        this.cost = cost;
    }

    /**
     * Gibt den Zielknoten zurück.
     *
     * @return Zielknoten
     */
    public Vertex getDest() {
        return dest;
    }

    /**
     * Gibt die Kosten der Kante zurück.
     *
     * @return Kosten
     */
    public double getCost() {
        return cost;
    }
}
Die Klasse Graph
Die Klasse Graph verwaltet die Knoten eines Graphen mithilfe einer Hash-Tabelle. Schlüssel ist der Bezeichner eines Knotens, sein Name. Als jeweiliger Wert zu jedem Schlüssel, wird der entsprechende Knoten eingetragen.
Es sind zwei Methoden zum Finden eines Knotens im Graphen implementiert. Die Methode find() findet einen im Graphen angelegten Knoten und liefert ihn an den Aufrufer zurück. Wird der gesuchte Knoten nicht gefunden, wird null zurückgegeben. Die Methode getVertex() ist demgegenüber als sogenannte Factory-Methode implementiert. Das bedeutet: Wird ein Knoten gesucht und gefunden, wird er an den Aufrufer zurückgegeben. Wird der gesuchte Knoten jedoch nicht gefunden, wird er automatisch erzeugt. Der neu generierte Knoten wird an den Aufrufer zurückgegeben. - Das macht es leicht und effizient, Knoten im Graphen einzufügen. Doppelungen werden durch die als Hash-Map verwendete Hash-Tabelle automatisch unterbunden. Jeder Knotenbezeichner (und damit auch jeder Knoten) ist somit eindeutig.
package graph;

import adt.ClosedHashTable;

/**
 * Implementierung eines Graphen, basierend auf {@link graph.Vertex}
 * und {@link graph.Edge}.
 *
 * Der Graph wird als Hash-Map<String, Vertex> implementiert, d.h.
 * als eine Hash-Tabelle mit Schlüssel vom Typ {@code String} und
 * Werten vom Typ {@link Vertex}. Vertex-Objekte sind eindeutig pro
 * Name.
 */
public class Graph {

    private final ClosedHashTable<String, Vertex> graph;

    /**
     * Konstruktor für einen Graphen.
     *
     * @param size Größe/Mindestanzahl der Knoten
     */
    public Graph(int size) {
        // prüfe die angegebene Größe der Hash-Tabelle
        // - Die hier geprüfte Mindestgröße ist lediglich eine
        //   "formale" Größe.
        // - De facto muss die Tabelle groß genug sein, um alle
        //   Knoten speichern zu können.
        if (size < 1)
            throw new IllegalArgumentException("Die Größe kann nicht kleiner 1 sein.");
        graph = new ClosedHashTable<>(size);
    }

    /**
     * Prüfung, ob Graph leer.
     *
     * @return {@code true}, wenn Graph leer, sonst {@code false}
     */
    public boolean empty() {
        return graph.empty();
    }

    /** Rückgabe eines (evtl. auch leeren) Arrays mit den Knoten
     * des Graphen.
     *
     * @return Knoten-Array
     */
    public Vertex[] vertices() {
        return graph.getValues(Vertex.class);
    }

    /**
     * Liefert den Knoten mit dem Namen {@code name}.
     *
     * Wenn der gewünschte Knoten nicht vorhanden ist, wird er
     * erzeugt und dem Graphen hinzugefügt.
     *
     * @param name Knotenname
     * @return Knoten
     */
    public Vertex getVertex(String name) {
        if (name == null || (name.trim()).isEmpty())
            throw new IllegalArgumentException(
                "Der Knotenname darf nicht leer oder null sein.");
        Vertex v = graph.lookup(name);
        if (v == null) {
            v = new Vertex(name);
            graph.insert(name, v);
        }
        return v;
    }

    /**
     * Finden eines bestimmten Knoten.
     *
     * @param name Name des Knotens
     * @return Knoten oder null, wenn nicht gefunden.
     */
    public Vertex find(String name) {
        return graph.lookup(name);
    }

    public void addEdge(String source,
                        String dest,
                        double cost) {
        if (source == null || (source.trim()).isEmpty() ||
            dest == null || (dest.trim()).isEmpty())
            throw new IllegalArgumentException(
                "Quelle und Ziel dürfen nicht leer oder null sein.");
        Vertex vSource = getVertex(source);
        Vertex vDest = getVertex(dest);
        vSource.addEdge(new Edge(vDest, cost));
    }
}
Die Klasse GraphTest
Die Klasse GraphTest wird genutzt, um einen Graphen aus Datei einzulesen, Algorithmen auszuführen und die entsprechenden Ergebnisse auszugeben. Dazu bedient sich GraphTest verschiedener Hilfsklassen. Das sind die Klassen GraphIO um Graphen einlesen und ausgeben zu können. Die Klasse Result stellt verschiedene Ausgabe-Methoden bereits, die zum Teil spezifisch für bestimmte Algorithmen sind. Die Algorithmen selbst werden in jeweils einer eigenen Klasse implementiert. - So ist ein sauberes OOP-Design gewährleistet.
import StdLib.StdErr;
import graph.Graph;
import graph.GraphIO;
import graph.Reachable;

/**
 * Die Klasse {@code GraphTest} dient alas Grundgerüst zum
 * Testen von Graph-Algorithmen.
 *
 * Der Quellcode ist für die jeweiligen Tests zu editieren.
 */
public class GraphTest {
    public static void main(String[] args) {
        if (args.length < 2) {
            StdErr.println("Usage: java GraphTest size filename");
            System.exit(1);
        }

        int size = Integer.parseInt(args[0]);
        Graph g = GraphIO.readGraph(size, args[1]);
        GraphIO.printGraph(g);
        Reachable.reachableVertices(g);
    }
}
Gegeben sein folgender Graph kleidung.txt:
Unterhemd Pullover 0
Pullover Mantel 0
Unterhose Hose 0
Hose Mantel 0
Hose Schuhe 0
Socken Schuhe 0
Dann liefert GraphTest in der im Code vorgenommenen Konfiguration das folgende Ergebnis:
$ java GraphTest.java 10 kleidung.txt
Adjazenzlisten des Graphen:
(Unterhemd, Pullover) = 0.00
(Pullover, Mantel) = 0.00
(Socken, Schuhe) = 0.00
(Unterhose, Hose) = 0.00
(Hose, Schuhe) = 0.00   (Hose, Mantel) = 0.00

Tiefensuche (all) - Traversierungsreihenfolge:
  0 Schuhe
  1 Unterhemd
  2 Pullover
  4 Socken
  3 Mantel
  5 Unterhose
  6 Hose

Breitensuche (Start Unterhemd): Traversierungsreihenfolge:
  0 Unterhemd
  1 Pullover
  2 Mantel

Die Sortierung lautet:
  5 Schuhe
  0 Unterhemd
  3 Pullover
  1 Socken
  6 Mantel
  2 Unterhose
  4 Hose

Kosten 0.00:
Unterhemd -> Pullover -> Mantel
$ _
Die Klasse GraphIO trennt den Graphen sowie auch den Testclient von der Ein- und Ausgabe des originären Graphen.
package graph;

import adt.EnumList;
import adt.SingleLinkedList;
import StdLib.StdIn;
import StdLib.StdOut;
import StdLib.TxtFileIn;

/**
 * Die Klasse {@code GraphIO} liest gerichtete Graphen ein
 * und gibt sie auf der Standardausgabe aus.
 */
public class GraphIO {
    /**
     * Einlesen eines Graphen aus einer Datei.
     * <p>
     * Die Datei muss wie folgt aufgebaut sein:
     * </p>
     * <pre>
     * source   destination  cost
     * </pre>
     * <p>
     * Die Spalten sind durch Leerzeichen oder Tabulatoren zu trennen.
     * </p>
     * @param size Größe des Graphen
     * @param filename Dateiname
     * @return Graph
     * @throws IllegalArgumentException wenn Größe kleiner als 1 oder
     *                                  Dateiname fehlt
     */
    public static Graph readGraph(int size, String filename) {
        if (filename == null || (filename.trim()).isEmpty())
            throw new IllegalArgumentException("Dateiname darf nicht leer oder null sein.");
        Graph g = new Graph(size);
        TxtFileIn file = new TxtFileIn(filename);
        while (StdIn.hasNextLine()) {
            // Zeile anhand von Leerzeichen und/oder Tabs aufsplitten
            String line = (file.readLine()).trim();
            if (!line.isEmpty()) {
                String[] parts = line.split("\\s+");
                if (parts.length == 3) {
                    String source = parts[0];
                    String dest = parts[1];
                    double cost = Double.parseDouble(parts[2]);
                    g.addEdge(source, dest, cost);
                }
            }
        }
        file.close();
        return g;
    }

    /**
     * Ausgabe des Graphen {@code g} auf der Standardausgabe.
     *
     * Die Ausgabereihenfolge ist zufällig.
     *
     * @param g Graph
     */
    public static void printGraph(Graph g) {
        StdOut.println("Adjazenzlisten des Graphen:");
        Vertex[] v = g.vertices();
        for (int i= 0; i < v.length; i++) {
            SingleLinkedList<Edge> sl = (SingleLinkedList<Edge>)v[i].getEdges();
            if (!sl.empty()) {
                EnumList<Edge> el = new EnumList<>(sl);
                while (el.hasMoreElements()) {
                    Edge e = el.nextElement();
                    StdOut.printf("(%s, %s) = %.2f   ",
                                    v[i].getName(),
                                    (e.getDest().getName()),
                                    e.getCost());
                }
                StdOut.println();
            }
        }
        StdOut.println();
    }
}
Die Klasse Result stellt verschiedene Ausgaberoutinen zur Verfügung, die je angewendeten Algorithmus zu wählen sind, um jeweils eine adäquate Ausgabe zu generieren. Auch hier wurde das Prinzip der Trennung von Verarbeitung und Ausgabe beachtet.
package graph;

import StdLib.StdOut;

/**
 * Routinen zum Anzeigen der Lösungen, kodiert in den Arbeitsvariablen
 * von {@link Vertex}.
 */
public class Result {

    /** Ausgabe einer Graphentraverse, gestützt auf den Knotennummern
     *
     * @param g Graph
     */
    public static void printTraverse(Graph g) {
        StdOut.println("Traversierungsreihenfolge:");
        Vertex[] v = g.vertices();
        for (int i = 0; i < v.length; i++)
            if (v[i].getSeen()) // nur besuchte Knoten ausgeben
                StdOut.printf("%3d %s\n", v[i].getNr(), v[i].getName());
        StdOut.println();
    }

    /**
     * Ausgabe für einen topologisch sortierten Graphen.
     *
     * @param g Graph
     */
    public static void printTopoSort(Graph g) {
        int i;
        boolean success = true;
        Vertex[] vertices = g.vertices();
        for (i = 0; i < vertices.length; i++)
            if (vertices[i].getNr() < 0)
                success = false;
        if (success) {
            StdOut.println("Die Sortierung lautet:");
            for (i = 0; i < vertices.length; i++)
                StdOut.printf("%3d %s\n", vertices[i].getNr(), vertices[i].getName());
        } else
            StdOut.println("Graph kann nicht topologisch sortiert werden.");
        StdOut.println();
    }

    /* Ausgabe kürzester Wege */

    // private Hilfsmethode
    private static void printPath(Vertex dest) {
        if (dest.getPrev() != null) {
            printPath(dest.getPrev());
            StdOut.print(" -> ");
        } StdOut.print(dest.getName());
    }

    /**
     * Pfadausgabe kürzester Wege.
     *
     * @param g Graph
     * @param v Startknoten
     */
    public static void printPath(Graph g, Vertex v) {
        if (v.getCost() == Double.POSITIVE_INFINITY)
            StdOut.println("%s ist nicht erreichbar");
        else {
            StdOut.printf("Kosten %.2f:\n", v.getCost());
            printPath(v);
        }
    }
}
Unter der Voraussetzung, alle in GraphTest aufgerufenen Algorithmen sind implementiert und die Parameter im Code für den zu analysierenden Graphen gesetzt, wird die Klasse wie folgt aufgerufen. Das Beispiel bezieht sich auf den Beispiel-Graphen in Abbildung 1.
$ java GraphTest 10 graph1.txt
Adjazenzlisten des Graphen:
(d, b) = 2.00
(a, c) = 2.00   (a, b) = 8.00
(b, d) = 4.00
(c, d) = 6.00   (c, b) = 1.00

Traversierungsreihenfolge:
  0 d
  2 a
  1 b
  3 c

Graph kann nicht topologisch sortiert werden.

Kosten 7.00:
a -> c -> b -> d
$ _
Traversieren von Graphen
Tiefensuche
Eine Graphentraverse auf einem gerichteten Graphen lässt sich beispielweise durch eine rekursiv organisierte Tiefensuche implementieren, wobei die Nummern der Knoten in der Reihenfolge vergeben werden, in der sie besucht werden. Dabei wird einem noch nicht besuchten Nachfolger jeweils so weit wie möglich in die Tiefe gefolgt. Erst wenn dies nicht mehr möglich ist, wird zum vorherigen Knoten zurückgekehrt. Bei nicht zusammenhängenden Graphen muss dazu die Suche mehrfach gestartet werden.
Ich habe für die Implementierung der Tiefensuche einen rekursiven Algorithmus verwendet.
Breitensuche
Die Breitensuche in einem gerichteten Graphen besucht Knoten schichtweise, ausgehend von einem Startknoten, indem sie Warteschlangen nutzt, um Nachfolger zu verarbeiten.
package graph;
import adt.EnumList;
import adt.ReferenceQueue;

/** Graph-Traversen: Breiten- und Tiefensuche */
public class GraphTraverse {
    private static int id;            // Variable zum Nummerieren

    // Knoten nach dem Prinzip der Tiefensuche besuchen.
    //
    // Bei Besuch: 1. Nummer vergeben, 2. besucht markieren
    private static void visit(Vertex v) {
        v.setNr(id++);                     // nächste Nummer
        v.setSeen(true);                   // markiere als besucht
        // Enumeration der Kantenliste
        EnumList<Edge> edges = new EnumList<>(v.getEdges());
        while (edges.hasMoreElements()) {  // für jede Kante ...
            // Nachbarknoten ermitteln
            Vertex vertex = (edges.nextElement()).getDest();
            // wenn nicht besucht
            if (!vertex.getSeen())
                // dann besuchen
                visit(vertex);
            // bereits besucht = Basisfall -> keine weitere Rekursion
        }
    }

    /**
     * Rekursive Tiefensuche.
     *
     * Die Knotennummern werden in der Reihenfolge vergeben, in der
     * sie besucht werden. Bei nicht zusammenhängenden Graphen muss
     * dazu die Suche mehrfach gestartet werden.
     *
     * @param g Graph
     */
    public static void dfsAll(Graph g) {
        int i;                                             // Laufvariable
        id = 0;                                            // Zähler initialisieren
        Vertex[] vertices = g.vertices();                  // Knotenliste holen
        for (i = 0; i < vertices.length; i++)              // alle Knoten als
            vertices[i].resetAlgoFields();                 // nicht besucht markieren

        for (i = 0; i < vertices.length; i++)              // alle Knoten
            if (!vertices[i].getSeen())                    // besuchen, wenn noch
                visit(vertices[i]);                        // nicht besucht
    }

    /**
     * Breitensuche.
     *
     * Die Knotennummern werden in der Reihenfolge vergeben.
     *
     * @param g Graph
     * @param start Startknoten
     */
    public static void bfsFromVertex(Graph g, Vertex start) {
        ReferenceQueue<Vertex> q = new ReferenceQueue<>();
        int i;                                             // Laufvariable
        id = 0;                                            // Zähler initialisieren
        Vertex[] vertices = g.vertices();                  // Knotenliste holen
        for (i = 0; i < vertices.length; i++)              // alle Knoten als
            vertices[i].resetAlgoFields();                 // nicht besucht markieren


        q.enqueue(start);
        while (!q.empty()) {
            Vertex vertex = q.dequeue();
            if (vertex.getSeen()) continue;

            vertex.setSeen(true);
            vertex.setNr(id++);

            EnumList<Edge> eList = new EnumList<>(vertex.getEdges());
            while (eList.hasMoreElements()) {
                Edge edge = (eList.nextElement());
                Vertex neighbour = edge.getDest();
                q.enqueue(neighbour);
            }
        }
    }
}
Beispielsitzung für den Graphen breitensuche.txt:
$ java GraphTest 10 breitensuche.txt
Adjazenzlisten des Graphen:
(a, c) = 0.00   (a, b) = 0.00
(b, e) = 0.00   (b, d) = 0.00
(c, g) = 0.00   (c, f) = 0.00

Tiefensuche (all) - Traversierungsreihenfolge:
  0 d
  1 e
  2 f
  3 g
  4 a
  6 b
  5 c

Breitensuche (Start a): Traversierungsreihenfolge:
  6 d
  5 e
  4 f
  3 g
  0 a
  2 b
  1 c

  $ _
Topologisches Sortieren
Das Problem des topologischen Sortierens auf einem gerichteten Graphen besteht darin, eine Knotennummerierung f : V \rightarrow \mathbb{N} zu finden, die mit den Kantenrichtungen kompatibel ist, d.h. (x, y) \in E \Rightarrow f (x) < f (y).
Begonnen wird die Nummerierung bei einem Knoten mit Eingangsgrad 0 (der die erste Nummer erhalten kann).
Sei x der Knoten, der zuletzt nummeriert wurde. Dann werden nun die von x ausgehenden Kanten (virtuell) entfernt und somit die (virtuellen) Eingangsgrade der von ihm erreichbaren Knoten vermindert. Verwendet wird dabei eine Schlange, welche solche Knoten speichert, deren virtueller Eingangsgrad im Laufe der Berechnung inzwischen auf 0 gesunken ist und daher für die nächste zu vergebene Nummer infrage kommt. Auf diese Weise wird verhindert, dass immer wieder nach einem Knoten mit Eingangsgrad 0 gesucht werden muss.
Am einfachsten kann man sich das topologische Sortieren anhand des Anziehens vorstellen. Das topologische Sortieren bringt abhängige Knoten, z. B. Vorgänge des Anziehens, in eine Reihenfolge.
Gegeben sei der folgende Graph. Die Kosten einer Kante betragen hier jeweils 0.0:
Unterhemd   Pullover    0.0
Pullover    Mantel      0.0
Unterhose   Hose        0.0
Hose        Mantel      0.0
Hose        Schuhe      0.0
Socken      Schuhe      0.0
Das Unterhemd ist vor dem Pullover anzuziehen. Die Unterhose muss der Hose vorangehen. Ob Sie aber erst die Unterhose oder das Unterhemd anziehen, ist Ihrem persönlichen Gusto überlassen.
package graph;

import adt.EnumList;
import adt.Queue;
import adt.ReferenceQueue;

/** Topologisches Sortieren. */
public class TopoSort {
    /**
     * Graph {@code g} topologisch sortieren.
     *
     * @param g Graph
     */
    public static void sortGraph(Graph g) {
        int i;                                                 // Laufvariable
        Vertex[] vertices = g.vertices();                      // Knotenliste holen
        for (i = 0; i < vertices.length; i++)                  // alle Knoten als
            vertices[i].resetAlgoFields();                     // nicht besucht markieren

        for (i = 0; i < vertices.length; i++) {
            EnumList<Edge> edges = new EnumList<>(vertices[i].getEdges());
            while (edges.hasMoreElements()) {                  // für jede Kante ...
                Vertex vertex = (edges.nextElement()).getDest();  // Nachbarknoten ermitteln
                int aktIndegree = vertex.getIndegrees();       // und den jeweiligen
                vertex.setIndegrees(aktIndegree+1);            // Eingangsgrad inkrementieren
            }
        }

        Queue<Vertex> l = new ReferenceQueue<>();
        // Schlange von Knoten mit Eingangsgrad 0
        for (i = 0; i < vertices.length; i++) {                // jeden Knoten
            if (vertices[i].getIndegrees() == 0)               // mit Eingangsgrad 0
                l.enqueue(vertices[i]);                        // anfügen
        }

        int id = 0;
        while (!l.empty()) {
            Vertex v = l.dequeue();
            v.setNr(id++);
            EnumList<Edge> edges = new EnumList<>(v.getEdges());
            while (edges.hasMoreElements()) {
                Edge e = edges.nextElement();
                Vertex w = e.getDest();
                w.setIndegrees(w.getIndegrees() - 1);
                if (w.getIndegrees() == 0)
                    l.enqueue(w);
            }
        }
    }
}
Topologisches Sortieren ist nur für Graphen ohne Zyklen definiert.
Während das topologische Sortieren Abhängigkeiten berücksichtigt, suchen wir im nächsten Abschnitt nach optimalen Wegen.
Kürzeste Wege
Das Problem der kürzesten Wege besteht darin, in einem gerichteten, mit nicht-negativen Kosten gewichteten Graphen die kürzesten Wege von einem Startknoten zu allen anderen Knoten auszurechnen (single-source-shortest-paths).
Der Algorithmus von Dijkstra verwendet dabei eine Priority-Queue, welche die vorläufigen Kosten eines Weges vom Startknoten zu einem Zielknoten in Form eines mit diesen Kosten bewerteten Knotens speichert.
Zu Beginn haben alle Knoten die vorläufigen Kosten \infty; der Startknoten erhält die vorläufigen Kosten 0.0. Jeweils der billigste Knoten aus der Menge der vorläufig markierten Knoten kann seine endgültigen Kosten erhalten und fügt ggf. die durch ihn verbilligten vorläufigen Kosten zu seinen Nachbarn in Form von Knoten in die Schlange ein.
Die PriorityQueue speichert Referenzen auf die Knoten. Wird cost eines Knotens verändert, ändert sich damit auch der Vergleichswert eines bereits in der Queue vorhandenen Eintrags. Seine Position in der verketteten Liste wird dadurch jedoch nicht automatisch angepasst. Deshalb wird die Referenz auf den Knoten mit der neuen Priorität erneut eingefügt. Der neue Eintrag befindet sich anschließend an der richtigen Position. Alte Einträge auf denselben Knoten können später in der Queue verbleiben. Da Dijkstra die Kosten nur verringert, stehen diese alten Einträge höchstens zu weit hinten. Sobald der Knoten über einen korrekt positionierten Eintrag verarbeitet wurde, ist er als seen markiert; später entnommene Einträge desselben Knotens werden deshalb ignoriert.
Hinweis: Einen kleinen Nebeneffekt hat die hier implementierte Konstruktion allerdings: Die interne Aussage „ListPriorityQueue ist sortiert“ gilt während unseres Dijkstras streng genommen zeitweise nicht mehr, weil sich der Vergleichswert bereits gespeicherter Objekte nachträglich ändert. Für diesen Dijkstra funktioniert das aus dem oben genannten Grund trotzdem. Eine Kostenverbesserung bedeutet immer eine Verringerung. Der alte Eintrag kann dadurch nur zu weit hinten, niemals zu weit vorne stehen. Gleichzeitig wird die Referenz mit dem neuen Wert erneut korrekt einsortiert.
package graph;

import adt.EnumList;
import adt.ListPriorityQueue;

/**
 * Kürzeste Wege nach Dijkstra.
 *
 * <p>Es sind nur nicht-negative Kantenkosten zulässig.</p>
 */
public class Dijkstra {

    /**
     * Dijkstra-Algorithmus auf Graph {@code g} für den Startknoten {@code start}
     * ausführen (Kürzeste Wege ermitteln).
     *
     * @param g Graph
     * @param start Startknoten
     */
    public static void dijkstra(Graph g, Vertex start) {
        // Prioritätswarteschlange zum Verwalten der günstigsten Knoten
        ListPriorityQueue<Vertex> pq = new ListPriorityQueue<>();
        int i;

        // Reset der Arbeitsdaten
        Vertex[] vertices = g.vertices();
        for (i = 0; i< vertices.length; i++)
            vertices[i].resetAlgoFields();

        start.setCost(0.0);                      // Startknoten hat Kosten 0.0
        pq.enqueue(start);                       // erster Eintrag in PQ

        while (!pq.empty()) {                    // solange noch Einträge in PQ
            Vertex vertex = pq.dequeue();        // billigster Knoten
            if (vertex.getSeen()) continue;      // falls bereits bearbeitet -> ignorieren
            vertex.setSeen(true);                // als bearbeitet markieren

            EnumList<Edge> eList = new EnumList<>(vertex.getEdges());
            // für jede Nachbarkante edge nach neighbour
            while (eList.hasMoreElements()) {
                Edge edge = (eList.nextElement());
                Vertex neighbour = edge.getDest();          // besorge Zielknoten
                double cost = edge.getCost();               // besorge Kosten
                if (cost < 0)
                    throw new RuntimeException("negativ");
                // falls Vergünstigung möglich, dann Kosten aktualisieren
                // und verursachenden Vorgänger notieren
                if (neighbour.getCost() > vertex.getCost() + cost) {
                    neighbour.setCost(vertex.getCost() + cost);
                    neighbour.setPrev(vertex);
                    pq.enqueue(neighbour);  // neuer Eintrag in PQ
                }
            }
        }
    }
}
Wenn Sie den Code der Methode dijkstra() aufmerksam lesen, wird Ihnen auffallen, dass ein Nachbarknoten bei einer Kostenaktualisierung über pq.enqueue(neighbour) einfach erneut in die Warteschlange eingefügt wird. Warum lösen wir das so und ändern nicht einfach das bestehende Element in der Schlange?
Der Grund liegt in der Funktionsweise unserer selbst implementierten ListPriorityQueue. Sie ist beim Einfügen eines Elements intern bereits nach Priorität sortiert (siehe Listing adt.ListPriorityQueue.java). Wenn wir nun im Nachhinein die Kosten (cost) eines Knotens ändern, der bereits auf einem Speicherplatz in der Liste liegt, merkt die Liste davon nichts - sie sortiert sich nicht automatisch neu.
Um den Knoten an die seiner neuen Priorität entsprechende, korrekte Position zu befördern, müssten wir die Liste aufwendig durchsuchen, das Element entfernen und neu einsortieren. In der Praxis der Informatik nutzt man daher oft diesen eleganteren Trick: Wir werfen den Knoten mit seinen neuen, günstigeren Kosten einfach frisch oben drauf. Das führt dazu, dass manche Knoten als „Karteileichen“ mehrfach in der Queue existieren. Das ist jedoch kein Problem für unseren Algorithmus: Sobald die günstigste Variante des Knotens aus der Queue geholt und verarbeitet wurde, wird sie über vertex.setSeen(true) markiert. Erreichen wir später die ältere, teurere Kopie desselben Knotens, wird sie in Zeile 35 über die Anweisung if (vertex.getSeen()) continue; blitzschnell und völlig lautlos übersprungen.
Zum Testen habe ich den Klassiker, ein Streckennetz, gewählt. Der Client ist wie folgt konfiguriert, um den kürzesten Weg von Osnabrück nach Berlin zu ermitteln:
import StdLib.StdErr;
import graph.Dijkstra;
import graph.Graph;
import graph.GraphIO;
import graph.TopoSort;
import graph.Result;

/**
 * Die Klasse {@code GraphTest} dient alas Grundgerüst zum
 * Testen von Graph-Algorithmen.
 *
 * Der Quellcode ist für die jeweiligen Tests zu editieren.
 */
public class GraphTest {
    /**
     * Hauptprogramm.
     *
     * @param args <br>
     * [0] - Größe der Hash-Tabelle<br>
     * [1] - Dateiname
     */
    public static void main(String[] args) {
        if (args.length < 2) {
            StdErr.println("Usage: java GraphTest <size> <filename>");
            System.exit(1);
        }

        int size = Integer.parseInt(args[0]);
        Graph g = GraphIO.readGraph(size, args[1]);
        GraphIO.printGraph(g);
        Dijkstra.dijkstra(g, g.getVertex("Osnabrück"));
        Result.printPath(g, g.getVertex("Berlin"));
    }
}
$ java GraphTest 30 data/streckennetz.txt
Adjazenzlisten des Graphen:
(Bremen, Osnabrück) = 126.00 (Bremen, Hamburg) = 121.00
(Muenchen, Frankfurt_aM) = 392.00 (Muenchen, Stuttgart) = 231.00
(Münster, Dortmund) = 71.00 (Münster, Osnabrück) = 61.00
(Berlin, Hamburg) = 289.00 (Berlin, Hannover) = 286.00
(Kassel, Hannover) = 165.00 (Kassel, Dortmund) = 167.00
(Dortmund, Köln) = 95.00 (Dortmund, Frankfurt_aM) = 221.00 (Dortmund, Kassel) = 167.00 (Dortmund, Hannover) = 213.00 (Dortmund, Münster) = 71.00
(Osnabrück, Münster) = 61.00 (Osnabrück, Bremen) = 126.00
(Stuttgart, Muenchen) = 231.00 (Stuttgart, Köln) = 368.00
(Hannover, Dortmund) = 213.00 (Hannover, Kassel) = 165.00 (Hannover, Berlin) = 286.00 (Hannover, Hamburg) = 152.00
(Frankfurt_aM, Dortmund) = 221.00 (Frankfurt_aM, Köln) = 193.00
(Hamburg, Bremen) = 121.00 (Hamburg, Berlin) = 289.00 (Hamburg, Hannover) = 152.00 (Hamburg, Flensburg) = 157.00
(Flensburg, Hamburg) = 157.00
(Köln, Stuttgart) = 368.00 (Köln, Frankfurt_aM) = 193.00 (Köln, Dortmund) = 95.00
Kosten 536.00:
Osnabrück -> Bremen -> Hamburg -> Berlin
$ _Zusammenfassung Graphen
Graphen bieten ein extrem weites und spannendes Betätigungsfeld. In diesem Kapitel haben wir uns auf ausgewählte Algorithmen auf gerichteten Graphen konzentriert, die in der Praxis häufig eingesetzt werden.
Die objektorientierte Modellierung ungerichteter Graphen unterscheidet sich hiervon nur in Details. Eine ungerichtete Kante kann in beide Richtungen traversiert werden. Auch ungerichtete Graphen können gewichtete Kanten besitzen; bei manchen Fragestellungen wird jedoch lediglich die Anzahl der durchlaufenen Kanten betrachtet.
Versuchen Sie eigene Graphen aufzustellen und Algorithmen zu entwickeln, die eine bestimmte Fragestellung beantworten. Denken Sie dabei zum Beispiel an die Reihenfolge von Vorgängen in der Projektplanung, die jeweiligen Vorgangsdauern und Abhängigkeiten. Ein Projektplan bietet zahlreiche Möglichkeiten mithilfe eines Graphen modelliert und verarbeitet zu werden. Diese und ähnliche Aufgaben sind typisch in der Graphentheorie.
Graphen bilden damit den Übergang von grundlegenden Datenstrukturen zu anspruchsvolleren algorithmischen Fragestellungen.
Wichtig: Anhand der besprochenen Beispiele haben Sie vielfältige Einsatzmöglichkeiten für die ADTs praktisch erleben können. ADTs gehören zu den Standard-Werkzeugen eines jeden Informatikers.