Hashing
Wie haben uns jetzt eine ganze Zeit mit Bäumen und deren Ordnung befasst (sortieren, suchen). Jetzt untersuchen wir eine Datenstruktur, die ein Finden ohne Sortieren erlaubt. Das ist das sogenannte Hashing.
Beim Hashing verwenden wir eine Funktion, welche die Objekte auf eine natürliche Zahl abbildet.
f:Objekte \rightarrow \mathbb{N}
Diese natürliche Zahl steht für den Speicherort des Objekts. Funktion f angewendet auf Objekt x liefert eine positive Ganze Zahl, die Adresse, an der x abgelegt bzw. gefunden werden kann.
Stellen Sie sich ein Array mit N Speicherplätzen vor. Die sind von 0 bis N-1 durchnummeriert. Darin wollen Sie beispielsweise Namen speichern. Dann könnte eine einfache Funktion, welche die Adresse im Array bestimmt, wo ein Name abgelegt wird, wie folgt aussehen. s sei die Zeichenkettendarstellung eines Objekts x (s = str(x)).
f(s) = \left(\sum\limits_{i=0}^{N-1}\text{ord}(s_i)\right) \text{ MOD } N
Wir addieren die Codierung der einzelnen Zeichen und teilen die Summe ganzzahlig mit Rest durch N. Die Modulo-Operation stellt sicher, als Indexwert für die Speicherung eines Namens, einen Wert im Intervall [0, N-1] zu erhalten, einer gültigen Index-Adresse im Array. - Eine solche Funktion heißt Hash-Funktion. Der Preis für die dadurch gewonnene Geschwindigkeit ist, dass wir mit Kollisionen umgehen müssen - schauen wir uns gleich an.
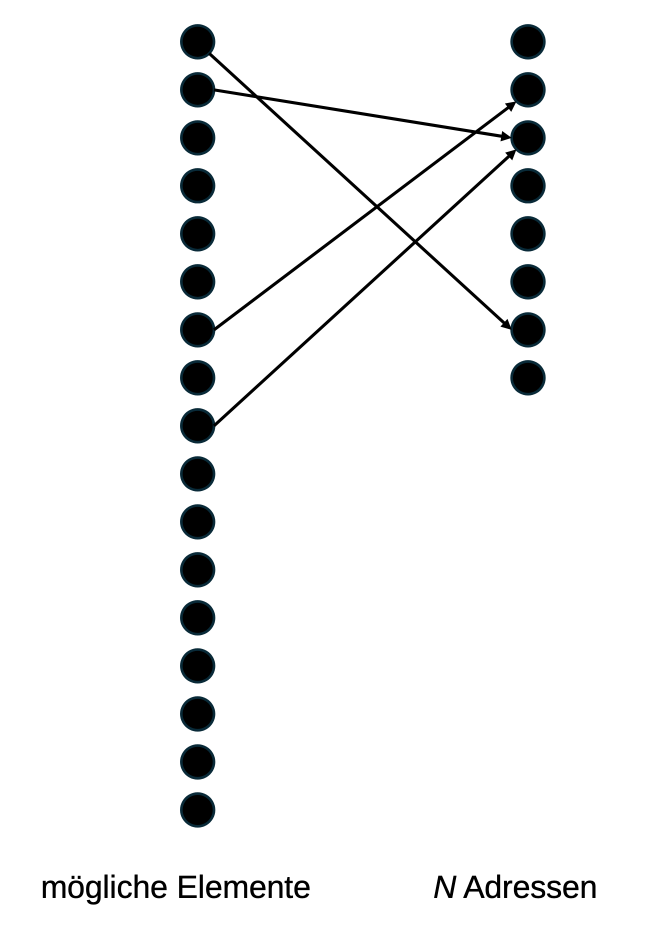
Üblicherweise wird es mehrere Einträge (hier Namen) geben, für die die Hash-Funktion denselben Index berechnet. Werden für verschiedene Objekte gleiche Adressen bestimmt, dann kollidieren sie. Wir nennen das dann jeweils eine Kollision.
Problem: Anzahl der möglichen Elemente ist größer als die Anzahl der Adressen.
Eine Hash-Funktion, auch als Streuwertfunktion bezeichnet, ist eine Abbildung, die eine große Eingabemenge, die Schlüssel, auf eine kleinere Zielmenge, die Hashwerte, abbildet. Eine Hash-Funktion ist daher im Allgemeinen nicht injektiv. Aus den Hashwerten lassen sich die ursprünglichen Werte nicht rekonstruieren.
Die Hash- oder Streuwerte sind meist skalare Werte aus einer begrenzten Teilmenge der natürlichen Zahlen. Eine gute Hash-Funktion liefert dabei für die Eingabedaten Werte derart, dass zwei unterschiedliche Eingaben auch zu unterschiedlichen Ausgabewerten führen. Wir sprechen dann von einer perfekten Hash-Funktion.
In der Regel kennen wir die Eingabedaten jedoch nicht, sodass wir keine perfekte Hash-Funktion konstruieren können. Wir müssen also eine Strategie finden, mit Kollisionen umzugehen. Eine Kollision liegt vor, wenn für zwei ungleiche Objekte x und y f(x) = f(y) gilt.
Die beiden Strategien, mit denen Kollisionen begegnet wird, sind das offene und das geschlossene Hashing.
Zum Speichern mittels Hashing werden sogenannte Hash-Tabellen verwendet. Eine grundlegende Eigenschaft dieser Tabellen ist es, sich wie Mengen zu verhalten, also keine Mehrfachspeicherung eines Datenwertes zuzulassen.
Merke: Eine Hash-Tabelle kann man als Verwandte einer Menge auffassen. Deshalb ähneln sich die Operationen (z. B. einfügen, suchen, löschen) - die Hash-Tabelle benötigt beim Einfügen jedoch zusätzlich einen Wert, weil sie im Gegensatz zur Menge nicht nur Elemente speichert. Eine Hash-Tabelle speichert Schlüssel-Wert-Paare.
package adt;

/**
 * Schnittstelle für Hash-Tabellen-Operationen.
 *
 * @param <V> Datentyp der gespeicherten Werte
 */
public interface HashTable<K, V> {
    /**
     * Prüft, ob Hash-Tabelle leer ist.
     *
     * @return {@code true}, wenn leer, sonst {@code false}
     */
    boolean empty();
    /**
     * Sucht Wert mit Schlüssel {@code key} in Hash-Tabelle.
     * @param key gesuchtes Element
     * @return {@code value}, wenn gefunden, sonst {@code null}
     */
    V lookup(K key);
    /**
     * {@code value} mit Schlüssel {@code key} einfügen, wenn
     * Schlüssel noch nicht vorhanden.
     *
     * @param key Schlüssel
     * @param value einzufügendes Element
     * @return {@code true}, wenn erfolgreich, sonst {@code false}
     */
    boolean insert(K key, V value);
    /**
     * {@code key} aus Hash-Tabelle löschen.
     *
     * @param key Schlüssel des zu löschenden Elements
     * @return {@code true} bei Erfolg, sonst {@code false}
     */
    boolean delete(K key);
}
Das Interface einer Hash-Tabelle ist daher dem Interface einer Menge, aufgrund seiner Verwandtschaft, sehr ähnlich. Die Operationen haben dieselbe Semantik.
Offenes Hashing
Beim offenen Hashing verwendet man im Allgemeinen ein Array, dessen Indizes die Hashwerte repräsentieren. Jedem Array-Element ist eine Liste zugewiesen. In der Liste eines Array-Elements i werden die Werte gespeichert, die jeweils i als Hashwert haben. Bereits vorhandene Werte werden kein zweites Mal gespeichert.
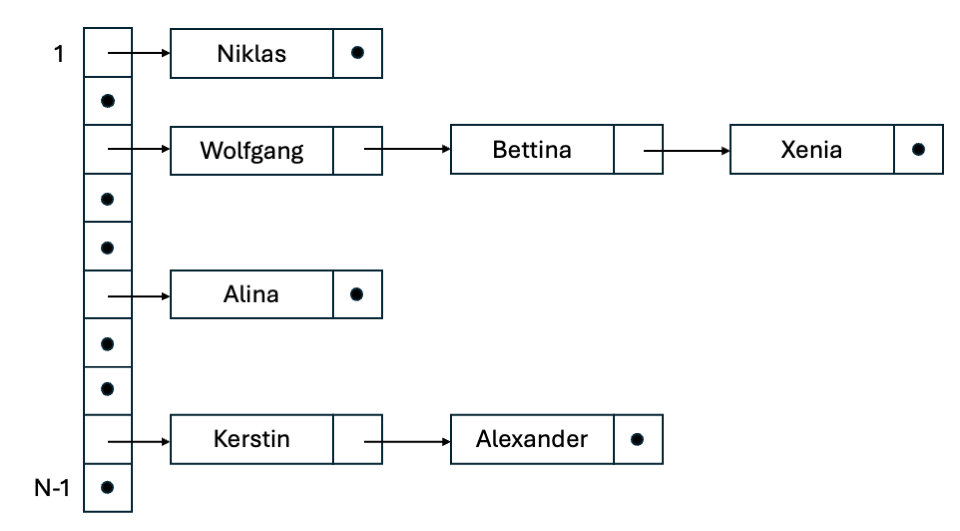
Zu Beginn sind alle Listen im Array [a] der Hash-Tabelle leer. Werden nun Einträge hinzugefügt, wird für jeden neuen Eintrag der zugehörige Indexwert, der Hash-Wert, mithilfe der Hash-Funktion berechnet. Hat dieser Hash-Wert den Wert i, wird der neue Eintrag an die Liste a[i] angefügt. Aufgrund der Mengeneigenschaft einer Hash-Tabelle ist zu prüfen, ob es nicht bereits ein wertgleiches Element in dieser Liste gibt. Wenn ja, wird das Einfügen des neuen Elements abgelehnt. Andernfalls wird es der Liste a[i] hinzugefügt.
Zum Suchen eines Elements in der Hash-Tabelle wird dessen Schlüssel verwendet. Wir errechnen dessen Hash-Wert und erhalten damit den Index der Liste, in welcher der Wert sich befinden muss, wenn er in der Hash-Tabelle gespeichert ist. Wir durchsuchen dann die entsprechende Liste.
package adt;

/**
 * Hash-Tabelle für ein offenes Hashing.
 *
 *  Hinweis: Der Datentyp {@code K} muss hashable sein, also
 *           {@code equals} und {@code hashCode} implementieren.
 */
public class OpenHashTable<K, V> implements HashTable<K, V> {
    private SingleLinkedList<HashNode<K, V>>[] hashtable;
    private int capacity;  // maximale Anzahl der Array-Elemente
    private int count;     // Anzahl der Elemente in der Hash-Tabelle

    // privates Speicherelement
    private static  class HashNode<K, V> {
        private K key;     // Schlüssel
        private V value;   // Wert

        // Konstruktor
        private HashNode(K key, V value) {
            this.key = key;
            this.value = value;
        }

        // liefert Schlüssel
        private K getKey() {
            return key;
        }

        // liefert Wert
        private V getValue() {
            return value;
        }
    }

    /**
     * Konstruktor für offene Hash-Tabelle.
     *
     * @param N Kapazität/Größe des zu verwendenden Arrays
     * @throws IllegalArgumentException wenn die Kapazität kleiner 1 ist
     */
    @SuppressWarnings("unchecked")
    public OpenHashTable(int N) {
        if (N < 1)
            throw new IllegalArgumentException("Kapazität mindestens 1.");
        capacity = N;
        count = 0;
        hashtable = new SingleLinkedList[N];
        for (int i = 0; i < N; i++)
            hashtable[i] = new SingleLinkedList<>();
    }

    // Hash-Funktion, nutzt die Java-interne Methode hashCode()
    private int hash(K key) {
        int h = key.hashCode();
        if (h < 0) {
            // bei Integer.MIN_VALUE ist Negation ebenfalls negativ,
            // weil abs(Integer.MIN_VALUE) < Integer.MAX_VALUE
            if (h == Integer.MIN_VALUE) h = 0;
            else                        h = -h;
        }
        return h % capacity;
    }

    /**
     * Prüft, ob Hash-Tabelle leer ist.
     *
     * @return {@code true}, wenn leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return count == 0;
    }

    /**
     * Gibt die Anzahl der aktuell verwalteten Element zurück.
     *
     * @return Anzahl verwalteter Elemente
     */
    public int count() {
        return count;
    }

    /**
     * Sucht Wert mit Schlüssel {@code key} in Has-Tabelle.
     * @param key gesuchtes Element; @{code null} wenn nicht gefunden
     * @return {@code value}, wenn gefunden, sonst {@code null}
     * @throws IllegalArgumentException wenn Schlüssel gleich null
     */
    @Override
    public V lookup(K key) {
        if (key == null)
            throw new IllegalArgumentException("Schlüssel darf nicht null sein.");
        int index = hash(key);
        if (hashtable[index].empty())
            // Liste ist leer, nichts gefunden
            return null;
        else {
            // Liste ist nicht leer -> Schlüssel suchen
            HashNode<K, V> x;
            EnumList<HashNode<K, V>> e = new EnumList<>(hashtable[index]);
            while (e.hasMoreElements()) {
                x = (e.nextElement());
                if (key.equals(x.getKey()))
                    return x.getValue();  // gefunden
            }
        }
        // Liste durchsucht und nichts gefunden
        return null;
    }

    /**
     * {@code value} mit Schlüssel {@code key} einfügen, wenn
     * Schlüssel noch nicht vorhanden.
     *
     * @param key Schlüssel
     * @param value einzufügendes Element
     * @return {@code true}, wenn erfolgreich, sonst {@code false}
     * @throws IllegalArgumentException wenn Schlüssel gleich null
     */
    @Override
    public boolean insert(K key, V value) {
        if (key == null)
            throw new IllegalArgumentException("Schlüssel darf nicht null sein.");
        int index = hash(key);
        HashNode<K, V> node = new HashNode<>(key, value);

        // prüfe auf eventuelle Kollisionen
        if (hashtable[index].empty()) {
            // Liste ist noch leer, keine Kollision -> direkt einfügen
            hashtable[index].insert(node);
            count++;
            return true;  // Erfolg
        } else {
            // Liste ist nicht leer -> prüfe, ob Wert bereits vorhanden
            HashNode<K, V> x;
            EnumList<HashNode<K, V>>e = new EnumList<>(hashtable[index]);
            while (e.hasMoreElements()) {
                x = (e.nextElement());
                if (key.equals(x.getKey()))
                    // Kollision und Wert vorhanden
                    // -> Element ablehnen
                    return false;  // kein Erfolg
            }
        }
        // Kollision, jedoch Wert noch nicht vorhanden
        // -> einfügen
        hashtable[index].insert(node);
        count++;
        return true;  // Erfolg
    }

    /**
     * {@code key} aus Hash-Tabelle löschen.
     *
     * @param key Schlüssel des zu löschenden Elements
     * @return {@code true} bei Erfolg, sonst {@code false}
     * @throws IllegalArgumentException wenn Schlüssel gleich null
     */
    @Override
    public boolean delete(K key) {
        if (key == null)
            throw new IllegalArgumentException("Schlüssel darf nicht null sein.");
        int index = hash(key);

        if (hashtable[index].empty())
            // Liste leer -> sicher, dass Element nicht vorhanden
            //            -> kann also auch nicht gelöscht werden
            return false;  // kein Erfolg
        else {
            // Liste nicht leer -> durchsuchen
            hashtable[index].reset();
            while (!hashtable[index].endpos()) {
                if (key.equals((hashtable[index].content()).getKey())) {
                    // Schlüssel gefunden -> löschen (Erfolg)
                    hashtable[index].delete();
                    count--;
                    return true;
                }
                hashtable[index].forward();
            }
        }
        // Schlüssel nicht gefunden: kein Erfolg
        return false;
    }
}
Die Effizienz des offenen Hashings ist stark von der Größe des Arrays und den davon abhängigen Längen der jeweiligen Listen beeinflusst. Je kürzer die Listen, umso effizienter sind die Operationen auszuführen.
Geschlossenes Hashing
Beim geschlossenen Hashing werden alle Datenwerte direkt in einem Array abgelegt. Bei den meisten Programmiersprachen sind Arrays nicht dynamisch, sodass der benötigte Speicherplatz zu Beginn alloziert werden muss.
Falls y = f(x) schon belegt ist, so wird bei geschlossenen Hashing, im Falle einer Kollision, systematisch ein alternativer Speicherplatz gesucht.
Dabei unterscheiden wir verschiedene Strategien, sogenannte Sondierungsstrategien.
- y+1, y+2, y+3, y+4, \dots - lineares Sondieren
- y+1, y+4, y+9, y+16, \dots - quadratisches Sondieren
- y +f_2(x), y + 2\cdot f_2(x), \dots - Double Hashing mit zweiter Hash-Funktion; Schrittweite wird durch zweite Hash-Funktion bestimmt
Alle Berechnungen werden jeweils Modulo N durchgeführt. Insgesamt werden höchstens N-1 Sondierschritte verursacht. Beim quadratischen Sondieren werden gegebenenfalls nicht alle Array-Elemente besucht. Das vermeidet Clusterbildung, die beim linearen Sondieren auftreten kann.
In jedem Array-Element werden drei Dinge gespeichert. Der Schlüssel, der eigentliche Datenwert und der Status des Array-Elements (leer, belegt, gelöscht). Die drei Status sind erforderlich, um beim Suchen eines alternativen Speicherplatzes bei Kollisionen den nächsten freien Platz im Array zu finden. Gelöschte Werte werden nicht entfernt, sondern als gelöscht markiert.
Beispiel: Nehmen wir an, wir wollen Susi und Sören in die Hash-Tabelle einfügen. Beide haben denselben Hash-Wert und Susi steht bereits in der Tabelle. Den gleichen Speicherplatz dürfen die beiden nicht belegen. Daher ist für Sören ein neuer Platz zu finden. Wir nutzen als Sondierungsstrategie das lineare sondieren.
- Fall: Das nächste Array-Element ist als leer gekennzeichnet. Dann speichern wir Sören an dieser Stelle.
- Fall: Auch das nächste Array-Element ist belegt. Dann suchen wir weiter, bis ein Speicherplatz leer oder als gelöscht markiert ist.
Beim Suchen müssen wir etwas beharrlicher sein. Finden wir den gesuchten Schlüssel nicht direkt an der Index-Position seines Hash-Wertes, kann er nachfolgend gespeichert sein. Die Suche kann enden, wenn wir auf ein als leer gekennzeichnetes Array-Element treffen. Alle als gelöscht oder belegt gekennzeichneten Elemente stellen jedoch potenzielle Fundorte dar und sind bei der Suche zu berücksichtigen.
Fazit: Wir benötigen drei Status. Das sind „frei“, „belegt“ und „gelöscht“.
Beim Suchen kann es passieren, dass wir „überdrehen“. Das Array ist analog einem Ringpuffer (RingBuffer.java) aufgebaut. Wir brauchen also einen Wächter, der verhindert, dass wir ständig im Kreis suchen, wenn das Array entsprechend besetzt ist und wir nichts gefunden haben.
package adt;

import java.lang.reflect.Array;

/**
 * Implementierung einer Hash-Tabelle für geschlossenes Hashing.
 * @param <K> Schlüssel
 * @param <V> Wert
 */
public class ClosedHashTable<K, V> implements HashTable<K, V> {

    // privates Speicherelement
    private static class HashNode<K, V> {
        private K key;      // Schlüssel
        private V value;    // Wert
        private char state; // Status: E = Empty, D = Deleted, O = Occupied

        // Konstruktor - zu Beginn ist Element leer
        private HashNode(K key, V value) {
            this.key = key;
            this.value = value;
            this.state = 'E';
        }
        // Schlüssel liefern
        private K getKey() {
            return key;
        }
        // Schlüssel setzen
        private void setKey(K key) {
            this.key = key;
        }
        // Wert liefern
        private V getValue() {
            return value;
        }
        // Wert setzen
        private void setValue(V value) {
            this.value = value;
        }
        // Status liefern
        private char getState() {
            return state;
        }
        // Status setzen
        private void setState(char state) {
            this.state = state;
        }
    }

    private Object[] hashtable;  // Array als interner Speicher
    private int capacity;        // maximal mögliche Anzahl Tabellenelemente
    private int count;           // Anzahl der Tabellenelemente

    /**
     * Konstruktor für die Hash-Tabelle.
     *
     * Jedes Array-Element wird mit einem leeren Node initialisiert.
     *
     * @param N Kapazität/Größe des Arrays
     * @throws IllegalArgumentException wenn Größe nicht mindestens 1
     */
    public ClosedHashTable(int N) {
        if (N < 1)
            throw new IllegalArgumentException("Kapazität mindestens 1.");
        capacity = N;
        count = 0;
        hashtable = new Object[N];
        for (int i = 0; i < N; i++) {
            hashtable[i] = new HashNode<K, V>(null, null);
        }
    }

    // Hash-Funktion, nutzt die Java-interne Methode hashCode()
    private int hash(K key) {
        int h = key.hashCode();
        if (h < 0) {
            // bei Integer.MIN_VALUE ist Negation ebenfalls negativ,
            // weil abs(Integer.MIN_VALUE) < Integer.MAX_VALUE
            if (h == Integer.MIN_VALUE)
                h = 0;
            else
                h = -h;
        }
        return h % capacity;
    }

    /**
     * Prüft, ob Hash-Tabelle leer ist.
     *
     * @return {@code true}, wenn leer, sonst {@code false}
     */
    @Override
    public boolean empty() {
        return count == 0;
    }

    /**
     * Gibt die Anzahl der aktuell verwalteten Element zurück.
     *
     * @return Anzahl verwalteter Elemente
     */
    public int count() {
        return count;
    }

    /**
     * Prüft, ob Hash-Tabelle voll ist.
     *
     * @return {@code true}, wenn Tabelle voll, sonst {@code false}
     */
    public boolean full() {
        return count == capacity;
    }

    /**
     * Rückgabe der Kapazität.
     *
     * @return Kapazität
     */
    public int capacity() {
        return capacity;
    }

    /**
     * Sucht Wert mit Schlüssel {@code key} in Has-Tabelle.
     *
     * @param key gesuchtes Element; {@code null} wenn nicht gefunden
     * @return {@code value}, wenn gefunden, sonst {@code null}
     * @throws IllegalArgumentException wenn Schlüssel gleich null
     */
    @SuppressWarnings("unchecked")
    @Override
    public V lookup(K key) {
        if (key == null)
            throw new IllegalArgumentException("Schlüssel darf nicht null sein.");

        if (empty())
            // Hash-Tabelle leer, es gibt nichts zu finden
            return null; // kein Erfolg

        int sentinel = hash(key);  // Wächter, um "Überdrehen" zu erkennen
        int index = sentinel;

        // solange Status belegt oder gelöscht suchen
        HashNode<K,V> node = (HashNode<K,V>) hashtable[index];
        while (node.getState() == 'O' || node.getState() == 'D') {
            // wenn Schlüssel in einem belegten Feld gefunden -> liefern
            if (((HashNode<K, V>) hashtable[index]).getState() == 'O' &&
                    key.equals(((HashNode<K, V>) hashtable[index]).getKey())) {
                return ((HashNode<K, V>) hashtable[index]).getValue();
            }
            // // weiter im Array voranschreiten
            index = (index + 1) % capacity;
            // wenn Wächter erreicht -> nichts gefunden
            if (index == sentinel)
                return null; // überdreht
        }
        // nichts in der Nachbarschaft des Hash-Wertes gefunden
        return null;
    }

    /**
     * {@code value} mit Schlüssel {@code key} einfügen, wenn
     * Schlüssel noch nicht vorhanden.
     *
     * @param key Schlüssel
     * @param value einzufügendes Element
     * @return {@code true}, wenn erfolgreich, sonst {@code false}
     * @throws IllegalArgumentException wenn Schlüssel gleich null
     */
    @SuppressWarnings("unchecked")
    public boolean insert(K key, V value) {
        if (key == null)
            throw new IllegalArgumentException("Schlüssel darf nicht null sein.");

        // wenn Array voll, kann nichts mehr eingefügt werden
        if (full())
            return false;

        int sentinel = hash(key);  // Wächter, um vor "Überdrehen" zu schützen
        int index = sentinel;
        int firstDeleted = -1;     // merke gelöschte Elemente

        while (true) {
            HashNode<K, V> node = (HashNode<K, V>) hashtable[index];
            char state = node.getState();

            if (state == 'E') {
                // Ende der Probe-Sequenz: hier (oder früheres D) einfügen
                if (firstDeleted != -1)
                    index = firstDeleted;
                node = (HashNode<K, V>) hashtable[index];
                node.setKey(key);
                node.setValue(value);
                node.setState('O');
                count++;
                return true;
            }

            if (state == 'O') {
                if (key.equals(node.getKey()))
                    return false; // Key existiert schon
            } else { // state == 'D'
                // ersten Tombstone merken, aber weiter suchen (Key könnte später kommen!)
                if (firstDeleted == -1)
                    firstDeleted = index;
            }

            index = (index + 1) % capacity;
            if (index == sentinel) {
                // kompletter Umlauf: nur möglich, wenn kein 'E' mehr existiert
                if (firstDeleted != -1) {
                    HashNode<K, V> d = (HashNode<K, V>) hashtable[firstDeleted];
                    d.setKey(key);
                    d.setValue(value);
                    d.setState('O');
                    count++;
                    return true;
                }
                return false;
            }
        }
    }

    /**
     * Rückgabe eines Arrays mit den in der Tabelle gespeicherten Werten.
     *
     * @param type Datentyp der Werte (z.B.: String.class)
     * @return Array mit Werten der Hash-Tabelle
     * @throws IllegalArgumentException wenn Typangabe null
     */
    @SuppressWarnings("unchecked")
    public V[] getValues(Class<V> type) {
        if (type == null)
            throw new IllegalArgumentException("type darf nicht null sein.");
        V[] values = (V[]) Array.newInstance(type, count);
        int j = 0;
        for (int i = 0; i < capacity; i++) {
            if (((HashNode<K, V>) hashtable[i]).getState() == 'O')
                values[j++] = ((HashNode<K, V>) hashtable[i]).getValue();
        }
        return values;
    }

    /**
     * {@code key} aus Hash-Tabelle löschen.
     *
     * @param key Schlüssel des zu löschenden Elements
     * @return {@code true} bei Erfolg, sonst {@code false}
     * @throws IllegalArgumentException wenn Schlüssel gleich null
     */
    @SuppressWarnings("unchecked")
    public boolean delete(K key) {
        if (key == null)
            throw new IllegalArgumentException("Schlüssel darf nicht null sein.");
        if (empty())
            return false;

        int sentinel = hash(key);  // Wächter
        int index = sentinel;

        HashNode<K,V> node = (HashNode<K,V>) hashtable[index];
        while (node.getState() == 'O' || node.getState() == 'D') {
            if (node.getState() == 'O' && key.equals(node.getKey())) {
                node.setState('D');
                count--;
                return true;
            }

            index = (index + 1) % capacity;
            if (index == sentinel)
                return false;
        }
        return false;
    }
}
Fallstudie: Wörterbuchsuche mit Hash-Tabelle
Versuchen Sie das folgende Programm HashTableDict.java zuerst selbst zu implementieren. Es liest, ganz analog zu RangeAutocomplete.java, eine Wörterbuchdatei ein. Das Programm soll, nach dem Einlesen der Datei, eine Benutzerschnittstelle zum Suchen von Worten, anbieten. Mit dem Kommando quit verlässt der Benutzer das Programm.
Folgende Überlegungen sollten Sie anstellen:
- Welche Art von Wortsuche ist mithilfe einer Hash-Tabelle sinnvoll durchzuführen?
- Welchen Einfluss hat es auf die Ladezeit, ob eine Wörterbuchdatei sortiert ist oder nicht?
Begründen Sie das Ergebnis Ihrer Überlegungen.
import adt.HashTable;
import adt.ClosedHashTable;
import StdLib.StdErr;
import StdLib.StdIn;
import StdLib.StdOut;
import StdLib.TxtFileIn;

/**
 * Wörterbuch-Modellierung mithilfe einer Hash-Tabelle.
 */
public class HashTableDict {
    // Ein Wort zum Suchbaum hinzufügen
    private static void addWord(HashTable<String, WordInfo> table, String w, int lineNo) {
        if (!w.isEmpty()) {
            WordInfo wordinfo = new WordInfo(w);
            wordinfo.seenInLine(lineNo);
            table.insert(w, wordinfo);
        }
    }

    // HashTable aufbauen
    private static HashTable<String, WordInfo> buildIndexFromFile(String filename, int size) {
        TxtFileIn file = new TxtFileIn(filename);
        HashTable<String, WordInfo> table = new ClosedHashTable<>(size);
        int lineNo = 0;

        while (file.hasNextLine()) {
            String line = file.readLine();
            if (line == null) break;
            lineNo++;

            StringBuilder word = new StringBuilder();
            for (int i = 0; i < line.length(); i++) {
                char ch = line.charAt(i);
                if (Character.isLetterOrDigit(ch)) {
                    word.append(ch);
                } else {
                    if (!word.isEmpty()) {
                        addWord(table, word.toString(), lineNo);
                        word.setLength(0);
                    }
                }
            }
            if (!word.isEmpty()) {
                addWord(table, word.toString(), lineNo);
            }
        }
        file.close();
        return table;
    }

    // Wort-Suche
    private static void queryWord(HashTable<String, WordInfo> table, String word) {
        WordInfo wordinfo = table.lookup(word);
        if (wordinfo == null)
            StdOut.printf("%s nicht gefunden%n", word);
        else
            StdOut.printf("%s gefunden%n", word);
    }

    // Kommando-Interface
    private static void commandLoop(HashTable<String, WordInfo> table) {

        while (true) {
            StdOut.println("Befehle: search <word> | quit");
            StdOut.print("> ");                 // <<< PROMPT
            if (!StdIn.hasNextLine()) return;   // einfach Return: EOF -> Ende

            String[] parts = StdIn.readlnStrings();
            if (parts.length == 0 || parts[0].isEmpty()) continue;

            String cmd = parts[0].toLowerCase();

            switch (cmd) {
                case "quit" -> {
                    StdOut.println("Ende.");
                    return;
                }
                case "search" -> {
                    if (parts.length < 2) StdOut.println("Fehler: search <word>");
                    else queryWord(table, parts[1]);
                }
                default -> StdOut.println("Unbekannter Befehl.");
            }
        }
    }

    /**
     * HashTable-Suche in einem Wörterbuch nachdem eine Datei eingelesen wurde.
     * <p>
     * Operationen: exakte Wortsuche
     * </p>
     * @param args [0] - Größer der Hash-Tabelle<br> [1] - Dateiname
     */
    void main(String[] args) {
        int size = 0;  /// Größe der Hash-Tabelle

        if (args.length < 2) {
            StdOut.println("Usage: java <size> HashTableDict <filename>");
            return;
        }

        try {
            size = Integer.parseInt(args[0]);
        } catch(Exception e1) {
            StdErr.println(e1);
            System.exit(1);  // Fehlerstatus, Programmende
        }

        HashTable<String, WordInfo> tree = buildIndexFromFile(args[1], size);

        StdOut.println("Index aufgebaut. Interaktive Abfragen:");
        commandLoop(tree);
    }
}
Beobachtung
Bei einer geschlossenen Hash-Tabelle hat eine mögliche Sortierung der Eingabedaten keinen Einfluss auf die Ladezeit. Bei geeignet gewählter Tabellengröße und damit begrenztem Auslastungsgrad hängt die durchschnittliche Suchzeit nicht unmittelbar von der Anzahl der gespeicherten Elemente ab. Dank der Hash-Funktion finden wir stets direkt den entsprechenden Speicherplatz. Lediglich Kollisionen können dazu führen, dass der Aufwand für das Suchen sich erhöht. Die Anzahl möglicher Kollisionen hängt im Wesentlichen von der Größe des gewählten Arrays ab. Je größer das Array der Hash-Tabelle ist, umso geringer ist die Wahrscheinlichkeit einer Kollision. - In jedem Fall muss beim geschlossenen Hashing hinreichend Platz in der Tabelle sein, um alle Einträge aufnehmen zu können.
Laufzeit beim geschlossenen Hashing
Die folgende Laufzeitbetrachtung erfolgt ohne direkten Nachweis. Sie können Sie jedoch in jedem guten Informatik-Buch zum Thema Hashing nachlesen.
Sei n die Anzahl der in der Hash-Tabelle zur Zeit gespeicherten Objekte und N die Anzahl der möglichen Speicherpositionen.
Sei ferner \alpha = \frac{n}{N} < 1 der Auslastungsgrad.
Dann ergibt sich für die Anzahl der Schritte mit Double-Hashing als Kollisionsstrategie bei
- erfolgloser Suche: \approx \frac{1}{1 - \alpha} = 5.0 für \alpha = 0.8
- erfolgreicher Suche: \approx -\frac{\ln(1 - \alpha)}{\alpha} = 2.01 für \alpha=0.8
Das heißt, in durchschnittlich 2 Schritten wird bei einem Auslastungsgrad von 0.8, in einer Hash-Tabelle der Größe 1.25 Millionen mit 1 Million Elementen, das richtige Objekt gefunden. Ein AVL-Baum, eine optimierte Version unseres Baumes, benötigt dafür etwa 20 Vergleiche. Dazu kommt, dass der Aufwand in der Hash-Tabelle für einen konkreten Auslastungsgrad jeweils konstant ist. Die Anzahl der Schritte hängt nicht von n ab, sondern vom Auslastungsgrad. Bei 1 Milliarde Elementen sind, wenn der Auslastungsgrad weiterhin 0.8 beträgt, auch nur durchschnittlich 2 Schritte zum Finden eines Objekts erforderlich. Bei Baum wären das etwa 30 Vergleiche.
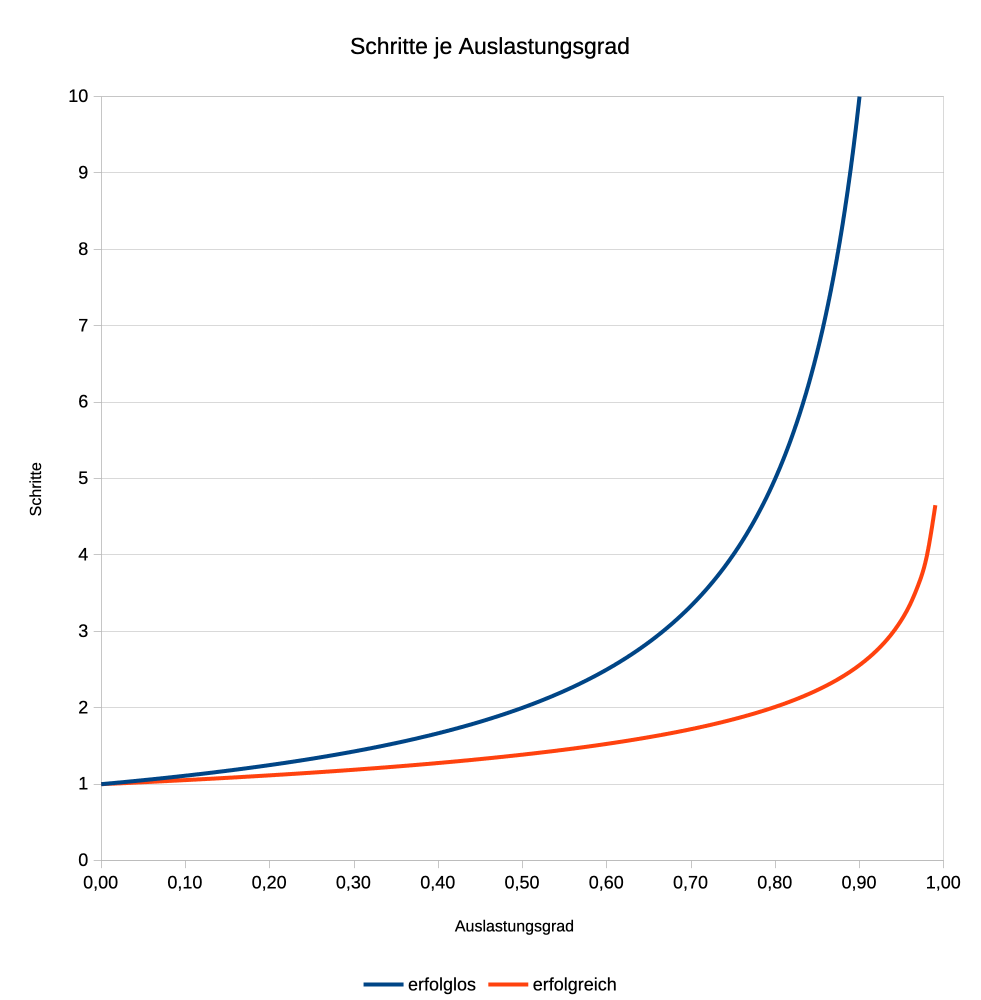
Die y-Achse zeigt die durchschnittliche Anzahl der benötigten Schritte.
Vergleich mit AVL-Bäumen
| AVL-Baum | Geschlossenes Hashing | |
|---|---|---|
| Laufzeit | logarithmisch | konstant |
| Speicherbedarf | dynamisch wachsend | in Sprüngen wachsend |
| Sortierung | möglich durch Traversierung | nicht möglich |
Merkbox zum Hashing
Denkfalle: Hashing ist keine Ordnung!
Eine häufige Fehlvorstellung ist, dass eine Hash-Tabelle die gespeicherten Schlüssel „irgendwie sortiert“ oder zumindest in einer festen Reihenfolge verwaltet.
Tatsächlich erzeugt die Hash-Funktion keine Ordnung, sondern lediglich eine Abbildung von Schlüsseln auf Speicheradressen. Zwei Schlüssel, die logisch „nah beieinander liegen“, können an völlig unterschiedlichen Positionen gespeichert werden - und umgekehrt.
Folgen dieser Denkfalle:
- Iterieren über eine Hash-Tabelle liefert keine wohldefinierte Reihenfolge.
- Operationen wie „kleinstes Element“, „nächstgrößerer Schlüssel“ oder Bereichsanfragen sind mit Hashing nicht effizient möglich. Für solche Aufgaben sind geordnete Datenstrukturen (z. B. Suchbäume) erforderlich.
Merke: Hashing optimiert das Finden einzelner Elemente, nicht das Arbeiten mit geordneten Mengen.