Übungsaufgaben und Musterlösungen
Übungen zu Kapitel Einleitung
Ablaufprotokoll
Spielen Sie Computer. Führen Sie den folgenden Algorithmus mit Papier und Bleistift durch. Erstellen Sie Ablaufprotokolle für verschiedene Eingaben, beispielweise: 1, 2, 3 und 4.
lies eine positive Ganzzahl n ein
setze x auf 2
setze y gleich n
setze z auf 1
SOLANGE y > 0:
    WENN y ungerade DANN:
        setze z gleich z mal x
        vermindere y um 1

    SONST:
        quadriere x
        halbiere y
gib z aus
Notieren Sie für jeden Schleifendurchlauf die Werte von x, y und z tabellarisch.
Nachdem Sie den obigen Algorithmus mehrfach durchgespielt haben, was meinen Sie wird berechnet?
Ablaufprotokoll
Bitte eine ganze Zahl n: 1
          x=undef. y=undef. z=undef.
Zeile  2: x=    2  y=undef. z=undef.
Zeile  3: x=    2  y=    1  z=undef.
Zeile  4: x=    2  y=    1  z=    1
Zeile  7: x=    2  y=    1  z=    2
Zeile  8: x=    2  y=    0  z=    2

Bitte eine ganze Zahl n: 2
          x=undef. y=undef. z=undef.
Zeile  2: x=    2  y=undef. z=undef.
Zeile  3: x=    2  y=    2  z=undef.
Zeile  4: x=    2  y=    2  z=    1
Zeile 11: x=    4  y=    2  z=    1
Zeile 12: x=    4  y=    1  z=    1
Zeile  7: x=    4  y=    1  z=    4
Zeile  8: x=    4  y=    0  z=    4
Zeile 13: x=    4  y=    0  z=    4

Bitte eine ganze Zahl n: 3
          x=undef. y=undef. z=undef.
Zeile  2: x=    2  y=undef. z=undef.
Zeile  3: x=    2  y=    3  z=undef.
Zeile  4: x=    2  y=    3  z=    1
Zeile  7: x=    2  y=    3  z=    2
Zeile  8: x=    2  y=    2  z=    2
Zeile 11: x=    4  y=    2  z=    2
Zeile 12: x=    4  y=    1  z=    2
Zeile  7: x=    4  y=    1  z=    8
Zeile  8: x=    4  y=    0  z=    8
Zeile 13: x=    4  y=    0  z=    8
Interpretation
Der Algorithmus berechnet für eine Eingabezahl n den Wert von 2^n.
Übungen zu Kapitel Java
Windchill
Als Windchill (t_{wc}) wird die gefühlte Lufttemperatur bezeichnet, die von der gemessenen Temperatur, in Abhängigkeit von der Windgeschwindigkeit, abweicht. Bei einer gemessenen Temperatur t in Grad Celsius und einer gegebenen Windgeschwindigkeit v in Kilometern pro Stunde definiert der Deutsche Wetterdienst die effektive Temperatur (Windchill) wie folgt:
t_{wc} = 13.12 + 0.6215 \cdot t + (0.3965 \cdot t - 11.37) \cdot v^{0.16}
Schreiben Sie ein Programm Windchill.java, das zwei double-Werte, gemessene Temperatur (°C) und Windgeschwindigkeit (km/h) einliest und die Windchill-Temperatur berechnet.
$ java Windchill
Lufttemperatur (°C).......: 10.0
Windgeschwindigkeit (km/h): 25.0
Windchill-Temperatur: 6.9 °C
$ _Hier der Java-Code zur Windchill-Berechnung:
import StdLib.StdOut;
import StdLib.StdIn;

/**
 * Berechnung der Windchill-Temperatur.
 */
public class Windchill {
    /**
     * Gemessene Temperatur in °C und Windgeschwindigkeit in km/h
     * werden interaktiv eingelesen, um die gefühlte Temperatur
     * (Windchill) zu berechnen.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        double t = StdIn.readlnDouble("Lufttemperatur (°C).......: ");
        double v = StdIn.readlnDouble("Windgeschwindigkeit (km/h): ");
        // Windchill-Temperatur
        double w;

        w = 13.12 + 0.6215 * t + (0.3965 * t -11.37) * Math.pow(v, 0.16);
        StdOut.printf("Windchill-Temperatur: %.1f °C", w);
    }
}
Wochentag
Schreiben Sie ein Programm Weekday.java, das ein Datum in Form von drei Werten, Tag, Monat und Jahr, einliest und den entsprechenden Wochentag ausgibt. Dabei soll der Anwender nicht die u.g. Monats- und Jahresumrechnungen vornehmen. Das ist Aufgabe Ihres Programms.
w = (d + \lfloor 2.6 \cdot m - 0.2\rfloor + y + \lfloor y/4 \rfloor + \lfloor c/4 \rfloor -2 \cdot c) \text{ mod } 7
Hinweis:
- d: Tag des Monats
- m: Monatsnummer (März = 1, April = 2, …, Februar = 12). Januar und Februar gehören zum Vorjahr.
- y: Die letzten beiden Stellen der Jahreszahl (bei Januar und Februar des Vorjahres)
- c: Die ersten beiden Stellen der Jahreszahl
- \lfloor \dots \rfloor ist Abrundungsfunktion (ganzzahliger Anteil ohne Nachkommastellen)
mod: damit ist die Java-MethodeMath.floorMod()gemeint.
Die Divisionen sind ganzzahlig auszuführen. Das Resultat 0 steht für Sonntag, 1 für Montag usw.
$ java Weekday
Tag..: 16
Monat: 7
Jahr.: 1965
Freitag
$ _Hier der Java-Code zur Wochentag-Berechnung:
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Bestimmung des Wochentags für ein bestimmtes Datum.
 * <p>
 * Die Berechnungsvorschrift bezieht sich auf den
 * gregorianischen Kalender.</p>
 */
public class Weekday {
    /**
     * Tag, Monat und Jahr werden eingelesen, um daraus den
     * Wochentag zu ermitteln.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        int d = StdIn.readlnInt("Tag..: ");
        int month = StdIn.readlnInt("Monat: ");
        int year = StdIn.readlnInt("Jahr.: ");

        int w, m, y, c;  // Hilfsvariablen
        if (month >= 3 && month <= 12) {
            m = month - 2;
        }
        else {
            m = month + 11;
            year -= 1;
        }
        y = year % 100;
        c = year / 100;

        int value = d + (int)(2.6 * m - 0.2) + y + y/4 + c/4 - 2*c;

        w = Math.floorMod(value, 7);

        switch (w) {
            case 0  -> StdOut.println("Sonntag");
            case 1  -> StdOut.println("Montag");
            case 2  -> StdOut.println("Dienstag");
            case 3  -> StdOut.println("Mittwoch");
            case 4  -> StdOut.println("Donnerstag");
            case 5  -> StdOut.println("Freitag");
            case 6  -> StdOut.println("Samstag");
            default -> StdOut.println("Unbekannter Wochentag");
        }
    }
}
CMYK-Farben
Computerbildschirme nutzen in der Regel zur Farbdarstellung das RGB-Farbmodell, bestehend aus den Farben Rot, Grün und Blau. Jeder dieser drei Farbkanäle kann Werte aus dem Intervall [0, 255] annehmen. Damit lassen sich 16,777,216 verschiedene Farben codieren.
Beim Drucken von Büchern oder Zeitschriften wird das CMYK-Farbmodell verwendet. Die Buchstabenkürzel stehen für Cyan, Magenta, Yellow und Black.
Schreiben Sie ein Programm RGB2CMYK.java, welches drei zulässige RGB-Werte einliest und die CMYK-Codierung berechnet. Sind alle RGB-Werte gleich 0, sollen die Werte für CMY jeweils mit 0 ausgegeben werden. K ist dann 1 (100%). Ansonsten gelten folgende Formeln:
\begin{array}{lcl} w & = & max(r/255, g/255, b/255) \\ c & = & (w-(r/255))/w \\ m & = & (w-(g/255))/w \\ y & = & (w-(b/255))/w \\ k & = & 1-w \\ \end{array}
Hinweis: CMYK-Werte sind Prozentwerte! Verwenden Sie zur Bestimmung des Maximums Math.max().
$ java RGB2CMYK
Rot  [0..255]: 30
Grün [0..255]: 68
Blau [0..255]: 90
C=0.67 M=0.00 Y=0.24 K=0.65
$ _Hier der Java-Code zur CMYK-Berechnung:
import StdLib.StdErr;
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Umrechnung von RGB nach CMYK.
 */
public class RGB2CMYK {
    /**
     * Einlesen der RGB-Codierung, Berechnung und
     * Ausgabe der CMYK-Codierung.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        int r = StdIn.readlnInt("Rot  [0..255]: ");
        int g = StdIn.readlnInt("Grün [0..255]: ");
        int b = StdIn.readlnInt("Blau [0..255]: ");

        if (r < 0 || r > 255 || b < 0 || b > 255 || g < 0 || g > 255)
            StdErr.println("Ungültige RGB-Werte.");
        else {
            if (r == 0.0 && g == 0.0 && b == 0.0)
                StdOut.printf("C=0.00 M=0.00 Y=0.00 K=1.00\n");
            else {
                double rd = r / 255.0;
                double gd = g / 255.0;
                double bd = b / 255.0;
                double w = Math.max(Math.max(rd, gd), bd);

                double c = (w-rd)/w;
                double m = (w-gd)/w;
                double y = (w-bd)/w;
                double k = 1 - w;

                StdOut.printf("C=%.2f M=%.2f Y=%.2f K=%.2f\n", c, m, y, k);
            }
        }
    }
}
Gambler
Schreiben Sie ein Simulationsprogramm GamblersRuin.java.
Angenommen, ein Spieler geht mit einem gegebenen Startkapital eine Reihe von fairen 1-Euro-Wetten ein. Irgendwann, das ist bekannt, verliert er alles. Wie sieht es jedoch aus, wenn wir dem Spiel Grenzen auferlegen? – Der Spieler soll aussteigen, seine Wetten beenden, wenn er entweder sein komplettes Geld verspielt oder aber ein gestecktes Ziel erreicht hat. Wie hoch sind die Chancen, dass der Spieler gewinnt? Wie viele Wetten sind nötig, um das Spiel zu gewinnen oder zu verlieren?
$ java GamblersRuin
Startkapital.......: 100
Ziel...............: 200
Anzahl Simulationen: 100000
49% Gewinne
Durchsch. Anzahl Wetten: 10001
$ _
Führen Sie verschiedene Simulationen durch. Ist es sinnvoll, seinen Lebensunterhalt auf diese Weise verdienen zu wollen? - Argumentieren Sie.
Hier der Java-Code zum Ruin des Spielers:
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Simulation von <i>GamblersRuin</i>.
 */
public class GamblersRuin {
    /**
     * Simulation von 1-Euro-Wetten. Am Ende wird eine
     * Statistik ausgegeben.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        int budget = StdIn.readlnInt("Startkapital.......: ");
        int goal   = StdIn.readlnInt("Ziel...............: ");
        int n      = StdIn.readlnInt("Anzahl Simulationen: ");
        int bets = 0;
        int wins = 0;
        // n Simulationen durchführen
        for (int i = 0; i < n; i++) {
            int cash = budget;
            // solange wetten bis pleite oder Ziel erreicht
            while (cash > 0 && cash < goal) {
                // Simulation einer Wette
                bets++;
                if (Math.random() < 0.5) cash++;
                else cash--;
            } // entweder pleite oder Gewinnziel erreicht
            if (cash == goal) wins++;
        }
        StdOut.println(100 * wins / n + "% Gewinne");
        StdOut.println("Durchsch. Anzahl Wetten: " + bets / n);
    }
}
$ java GamblersRuin
Startkapital.......: 100
Ziel...............: 200
Anzahl Simulationen: 100000
49% Gewinne
Durchsch. Anzahl Wetten: 10001
$ _Die Gewinnchance liegt im Beispiel knapp unter 50%. Auch wenn das noch Ihrer Risikobereitschaft entsprechen mag, ist das keine solide Lebensgrundlage. Erschwerend kommt die Anzahl der durchschnittlich zu bestreitenden Wetten hinzu. Sie werden es an einem Tag kaum schaffen, rund 10,000 Wetten durchzuführen.
$ java GamblersRuin
Startkapital.......: 100
Ziel...............: 1000
Anzahl Simulationen: 100000
10% Gewinne
Durchsch. Anzahl Wetten: 4647
$ _
In dieser Konstellation, bei sehr hochgesteckten Zielen, ist die Gewinnwahrscheinlichkeit auf 10\% gesunken.
Sie können das anhand weiterer Simulationen gerne verifizieren. Je größer die Anzahl der durchgeführten Simulationen gewählt wird, umso genauer ist das Ergebnis. Je weiter Start- und Zielkapital auseinanderklaffen, umso weniger wahrscheinlich ist es, das gesteckte Ziel zu erreichen.
Pepys-Problem
Im Jahr 1693 fragte Samuel Pepys, Staatssekretär im englischen Marineamt, den Universalgelehrten Isaac Newton, was wahrscheinlicher ist:
- Mindestens ein Mal eine 1 zu würfeln, wenn man sechs Mal würfelt.
- Mindestens zwei Mal eine 1 zu würfeln, wenn man zwölf mal würfelt.
Schreiben Sie ein (Simulations-)Programm , welches Newton, wenn er es damals hätte nutzen können, eine schnelle Antwort geliefert hätte. - Das Ergebnis mag erstaunen, ist jedenfalls nicht offensichtlich.
$ java PepysProblem
Anzahl Simulationen: 100000
Test1: 66.719
Test2: 61.82299999999999
$ _Hier der Code für die Simulation:
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * Simulation zur Beantwortung der Frage von Pepys an Newton, was
 * wahrscheinlicher ist.
 *
 * <ol>
 * <li>Mindestens ein Mal eine 1 zu würfeln,
 *      wenn man sechs Mal würfelt.</li>
    <li>Mindestens zwei Mal eine 1 zu würfeln,
        wenn man zwölf mal würfelt.</li>
 * </ol>
 */
public class PepysProblem {

    /**
     * Einlesen der Anzahl gewünschter Simulationen, Simulation
     * und Ausgabe des Ergebnisses.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        int trials = StdIn.readlnInt("Anzahl Simulationen: ");

        int succ1 = 0; int succ2 = 0;
        for (int i = 0; i < trials; i++) {
            int sixes1 = 0;
            for (int j = 0; j < 6 ; j++) {
                int r = 1 + (int) (Math.random() * 6);
                if (r == 1)
                    sixes1 +=1;
            }
            if (sixes1 >= 1)
                succ1 += 1;

            int sixes2 = 0;
            for (int j = 0; j < 12 ; j++) {
                int r = 1 + (int) (Math.random() * 6);
                if (r == 1)
                    sixes2 +=1;
            }
            if (sixes2 >= 2)
                succ2 += 1;
        }

        StdOut.println("Test1: " + 100*((double)succ1/(double)trials));
        StdOut.println("Test2: " + 100*((double)succ2/(double)trials));
    }
}
Anzahl Simulationen: 1000000
Test1: 66.4917
Test2: 61.93729999999999
$ _Die Wahrscheinlichkeit bei sechs Würfen mindestens eine Eins zu werfen ist geringfügig größer als die Wahrscheinlichkeit bei 12 Würfen mindestens zwei Einser zu erzielen.
Das Original-Problem zwischen Newton und Pepys betrachtete außerdem den Fall von mindestens drei Einsern in 18 Würfen. Diese Wahrscheinlichkeit liegt bei ca. 59.7\%.
Übungen zu Kapitel Arrays
Sammler-Problem
Jeder kennt sie, die Sammelbilder, die an den Supermarktkassen verkauft werden.
Wir nehmen an, dass in jedem Sammelbildpäckchen nur ein Bild enthalten ist. Schreiben Sie Programm PicCollector.java, welches das Sammeln von N verschiedenen Bildern simuliert. Wie viele Bilder müssen Sie durchschnittlich kaufen, bis Sie die N verschiedenen Bilder für ein Album vollständig gesammelt haben?
$ java PicCollector 50 10000
50 Bilder -> durchschnittlich 224 Käufe
$ _
Führen Sie Simulationen mit verschiedenen Anzahlen zu sammelnder Bilder aus. Was beobachten Sie?
import StdLib.StdOut;

/**
 * Simulation des Bildersammelns.
 */
public class PicCollector {
    /**
     * Die Zahl {@code N}, die Anzahl der verschiedenen Bilder,
     * die zu sammeln sind, werden, wie auch die Anzahl der
     * durchzuführenden Simulationen, als Kommandozeilenargument
     * an Programm übergeben.
     *
     * @param args <br>[0] - Anzahl zu sammelnder Bilder
     *             <br>[1] - Anzahl der Simulationen
     */
    public static void main(String[] args) {
        int N = Integer.parseInt(args[0]);  // Bilderanzahl
        int t = Integer.parseInt(args[1]);  // Trials

        boolean[] pics = new boolean[N];    // gesammelte Bilder

        int total = 0;        // Gesamtanzahl der Käufe
        int count;            // Anzahl der Käufe
        int collected;        // Anzahl gesammelter Bilder

        for (int i = 0; i < t; i++) {
            // vor jedem Simulationslauf Reset
            for (int j = 0; j < N; j++) // Initialisierung Album
                pics[j] = false;        // Bild nicht gesammelt
            count = 0;                  // Anzahl Käufe initialisieren
            collected = 0;              // noch nichts gesammelt
            while (collected < N) {

                // zufälliges Bild kaufen
                int pic = (int)(Math.random() * N);
                count++;                // Käufe zählen
                if (!pics[pic]) {       // wenn noch nicht gesammelt...
                    pics[pic] = true;   // Bild gesammelt
                    collected++;        // gesammelte Bilder zählen
                }
            }
            total += count;
        }
        StdOut.printf("%d Bilder -> durchschnittlich %d Käufe",
                      N, total / t);
    }
}
$ java PicCollector 50 10000
50 Bilder -> durchschnittlich 224 Käufe
$ _Die Bilderhersteller verdienen gut an den Sammlern.
Self-Avoiding-Walk
Die nächste Aufgabe implementiert einen sogenannten Self-Avoiding Walk. Wir nehmen an, ein Hund wird mitten in einer Stadt ausgesetzt. Die Straßen der Stadt bilden ein Gittermuster. Wir gehen von N Straßen aus, die von Osten nach Westen beziehungsweise von Norden nach Süden führen. Sie kreuzen sich an den Gitterpunkten. Bei seiner Flucht aus der Stadt entscheidet sich der Hund an jeder Kreuzung jeweils zufällig für die einzuschlagende Richtung. Dabei betritt er niemals eine Kreuzung, die er bereits besucht hat. Er kann daher, wenn er seinen Weg unglücklich wählt, in eine Sackgasse geraten. Dann findet er keinen Ausweg aus der Stadt. Ein Ausweg ist gefunden, wenn er einen Stadtrand erreicht.
Hinweis: Self-Avoiding Walks spielen in der Wissenschaft, zum Beispiel beim Studium von Polymeren eine große Rolle. Damit modelliert man beispielsweise Polymerketten, die langsam aber stetig wachsen, bis kein Wachstum mehr möglich ist.
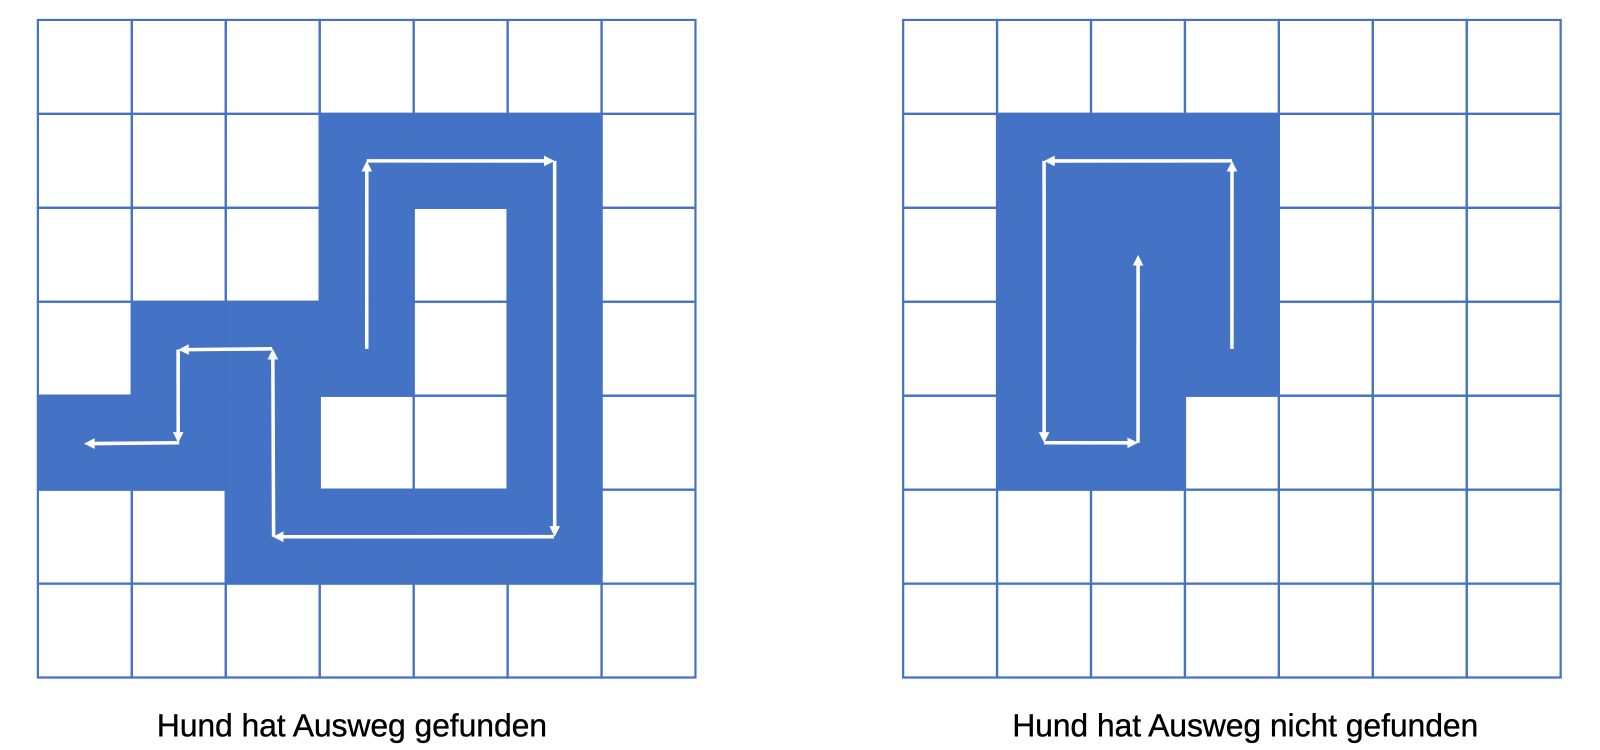
Das Programm liest die Dimensionierung des Stadtplans sowie die Anzahl der durchzuführenden Simulationen als Kommandozeilenargumente ein. Am Ende wird eine Statistik ausgegeben, die über die Erfolgschancen, einen Ausweg gefunden zu haben, informiert.
Es ist interessant zu bemerken, wie rapide die Chancen des Hundes sinken, einen Ausweg zu finden, wenn die Stadt größer wird. Im 3-dimensionalen Raum hat der Hund fast immer eine Chance zu entkommen, egal wie groß der Raum gewählt wird.
import StdLib.StdOut;

/**
 * Self-Avoiding-Walk.
 */
public class SelfAvoidingWalk {
    /**
     * Die Dimensionen und die Anzahl der Simulationen werden
     * als Kommandozeilenargumente eingelesen.
     *
     * @param args <br>[0] - Dimension des Stadtplans
     *             <br>[1] - Anzahl der Simulationsläufe
     */
    public static void main(String[] args) {
        int N = Integer.parseInt(args[0]);  // Dimensionierung
        int T = Integer.parseInt(args[1]);  // Anzahl Simulationen

        int deadEnds = 0;                   // Anzahl Sackgassen

        for (int t = 0; t < T; t++) {
            // neuer Stadtplan, automatisch mit false initialisiert
            boolean[][] city = new boolean[N][N];

            int x,y;
            x = y = N/2;                    // Koordinaten des Hundes

            // solange Stadtrand nicht erreicht -> weiter
            while (x>0 && x<N-1 && y>0 && y<N-1) {
                city[x][y] = true;          // Weg markieren

                // prüfe, ob Hund noch Bewegungsspielraum hat
                if (city[x-1][y] && city[x+1][y] &&
                    city[x][y-1] && city[x][y+1]) {
                    deadEnds++;
                    break;  // Hund steckt fest -> Abbruch
                }
                // wähle zufällige Richtung
                double r = Math.random();
                if      (r < 0.25) { if (!city[x-1][y])   x--; }
                else if (r < 0.50) { if (!city[x+1][y])   x++; }
                else if (r < 0.75) { if (!city[x][y-1])   y--; }
                else               { if (!city[x][y+1])   y++; }
            }
        }
        double fails = 100.0 * deadEnds / T;
        StdOut.printf("%.2f%% Sackgassen\n", fails);
    }
}
Fallstudie: Zufallssurfer
Die folgende Aufgabe ist komplex. - Sie ist für „mutige“ Seminarteilnehmer konzipiert.
Die Kommunikation über das Web ist inzwischen ein fester Bestandteil unseres Alltags geworden. Dass diese Form der Kommunikation möglich ist, verdanken wir nicht zuletzt wissenschaftlichen Studien zu Aufbau und Struktur des Webs, die seit den Anfängen des Webs Gegenstand der Forschung sind. Wir betrachten ein einfaches Modell des Webs, das sich als besonders erfolgreicher Ansatz erwiesen hat, um Erkenntnisse über diverse Eigenschaften des Webs zu gewinnen. Komplexere Varianten dieses Modells werden häufig zur Analyse herangezogen und haben eine erhebliche Rolle bei der explosiven Zunahme von Suchanwendungen im Web gespielt.
Das Modell ist als Zufallssurfer-Modell bekannt und leicht zu beschreiben. Wir betrachten das Web als eine feste Menge von Seiten, und jede Seite enthält eine feste Menge von Hyperlinks (kurz Links genannt), wobei jeder Link ein Verweis auf eine andere Seite ist. Wir untersuchen, was passiert, wenn eine Person (der Zufallssurfer) sich wahllos von Seite zu Seite bewegt, indem sie entweder eine Webadresse in die Adressleiste eingibt oder einen Link auf der aktuellen Seite anklickt.
Das dem Web-Modell zugrundeliegende mathematische Modell wird als Graph bezeichnet. Graphen sind ein ganz eigenes Thema in der Informatik. - Auch wir werden uns gegen Ende des Seminars mit diesem spannenden Thema auseinandersetzen.
Hier wollen wir uns lediglich auf die Berechnungen für ein natürliches und eingehend untersuchtes Wahrscheinlichkeitsmodell konzentrieren, welches das Verhalten des Zufallssurfers genau beschreibt.
Der erste Schritt bei der Analyse des Zufallssurfer-Modells besteht darin, es genauer zu formulieren. Der Knackpunkt dabei ist, festzulegen, was damit gemeint ist, sich wahllos von Seite zu Seite zu bewegen. Die folgende intuitive 90/10-Regel berücksichtigt zwei Methoden, eine neue Seite anzusteuern: Angenommen wird, dass der Zufallssurfer in 90% aller Fälle einen Zufalls-Link auf der aktuellen Seiten anklickt (jeder Link wird mit gleicher Wahrscheinlichkeit gewählt) und in 10% die Zufallsseite direkt aufruft (alle Seiten im Web werden mit gleicher Wahrscheinlichkeit gewählt).
Sie werden sicher sofort erkennen, dass dieses Modell Mängel aufweist, da Sie aus eigener Erfahrung wissen, dass das Verhalten eines echten Websurfers nicht so einfach zu beschreiben ist:
- Kein Websurfer wählt Links oder Seiten mit gleicher Wahrscheinlichkeit aus.
- Es ist grundsätzlich nicht möglich, jede Seite im Web direkt anzusteuern.
- Die Aufschlüsselung in 90/10 (oder ein anderes Verhältnis) ist nur eine Schätzung.
- Weder die Zurück-Schaltfläche noch das Surfen mit Lesezeichen werden berücksichtigt.
- Wir können nur mit einer kleinen Stichprobe aus dem Web arbeiten.
Trotz dieser Mängel ist das Modell aussagekräftig genug, um den Informatikern eine Menge über bestimmte Eigenschaften des Webs zu verraten. Um ein besseres Gespür für das Modell zu bekommen, sollten Sie das kleine Beispiel in der folgenden Abbildung betrachten. Es beschreibt die Verlinkung von fünf Webseiten. Für jeden Link ist eine Kante eingezeichnet, welche die Knoten (Seiten) miteinander verknüpfen.
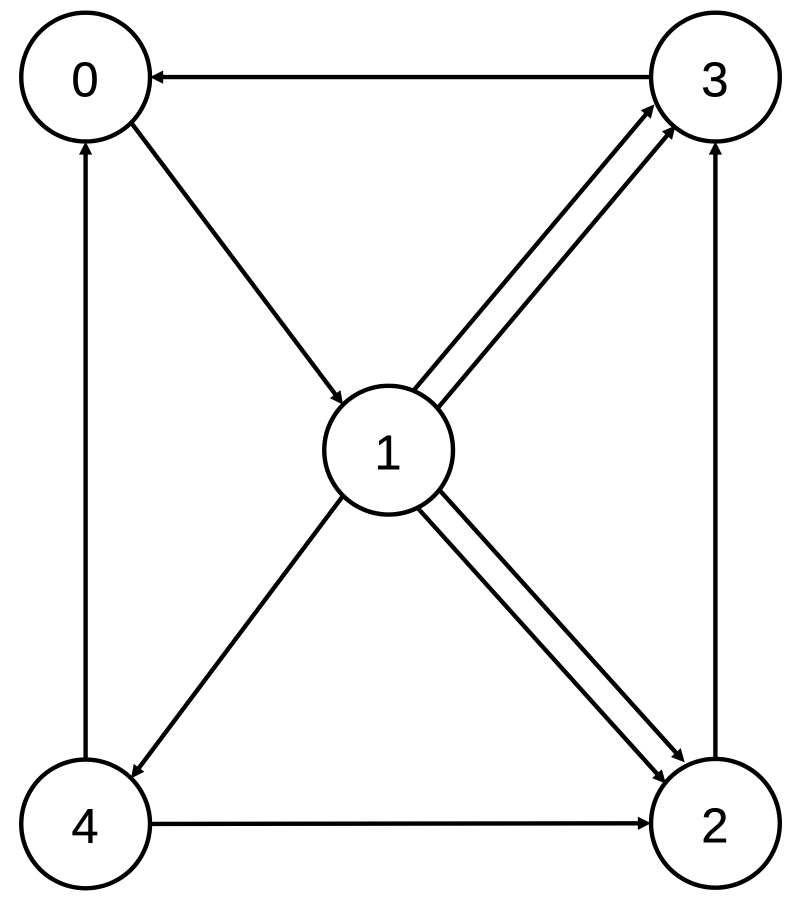
Welche Seite wird der Zufallssurfer am wahrscheinlichsten besuchen? - Jede Person im Web verhält sich ein wenig wie der Zufallssurfer, sodass diejenigen, die Webanwendungen erstellen oder eine Web-Infrastruktur aufbauen, ein sehr großes Interesse daran haben, die Entscheidungswege des Zufallssurfers nachzuvollziehen. Das Modell ist ein Werkzeug, um Einblicke in die Verhaltensmuster von Hunderten von Millionen Webnutzern zu erhalten. In diesem Abschnitt werden Sie die bisher in diesem Kapitel vorgestellten grundlegenden Programmierwerkzeuge verwenden, um das Modell und seine Auswirkungen zu analysieren.
Eingabeformat
Unser Wunsch ist es, das Verhalten des Zufallssurfers nicht nur an einem, sondern an verschiedenen Web-Modellen zu studieren. Aus diesem Grund werden wir datengesteuerten Code schreiben, d. h., wir verwalten die Daten in Dateien und schreiben Programme, die die Daten über die Standardeingabe einlesen. Der erste Schritt bei diesem Ansatz besteht darin, ein Eingabeformat zu definieren, mit dem wir die Informationen in den Eingabedateien strukturieren. Welches Eingabeformat wir definieren, bleibt ganz uns überlassen.
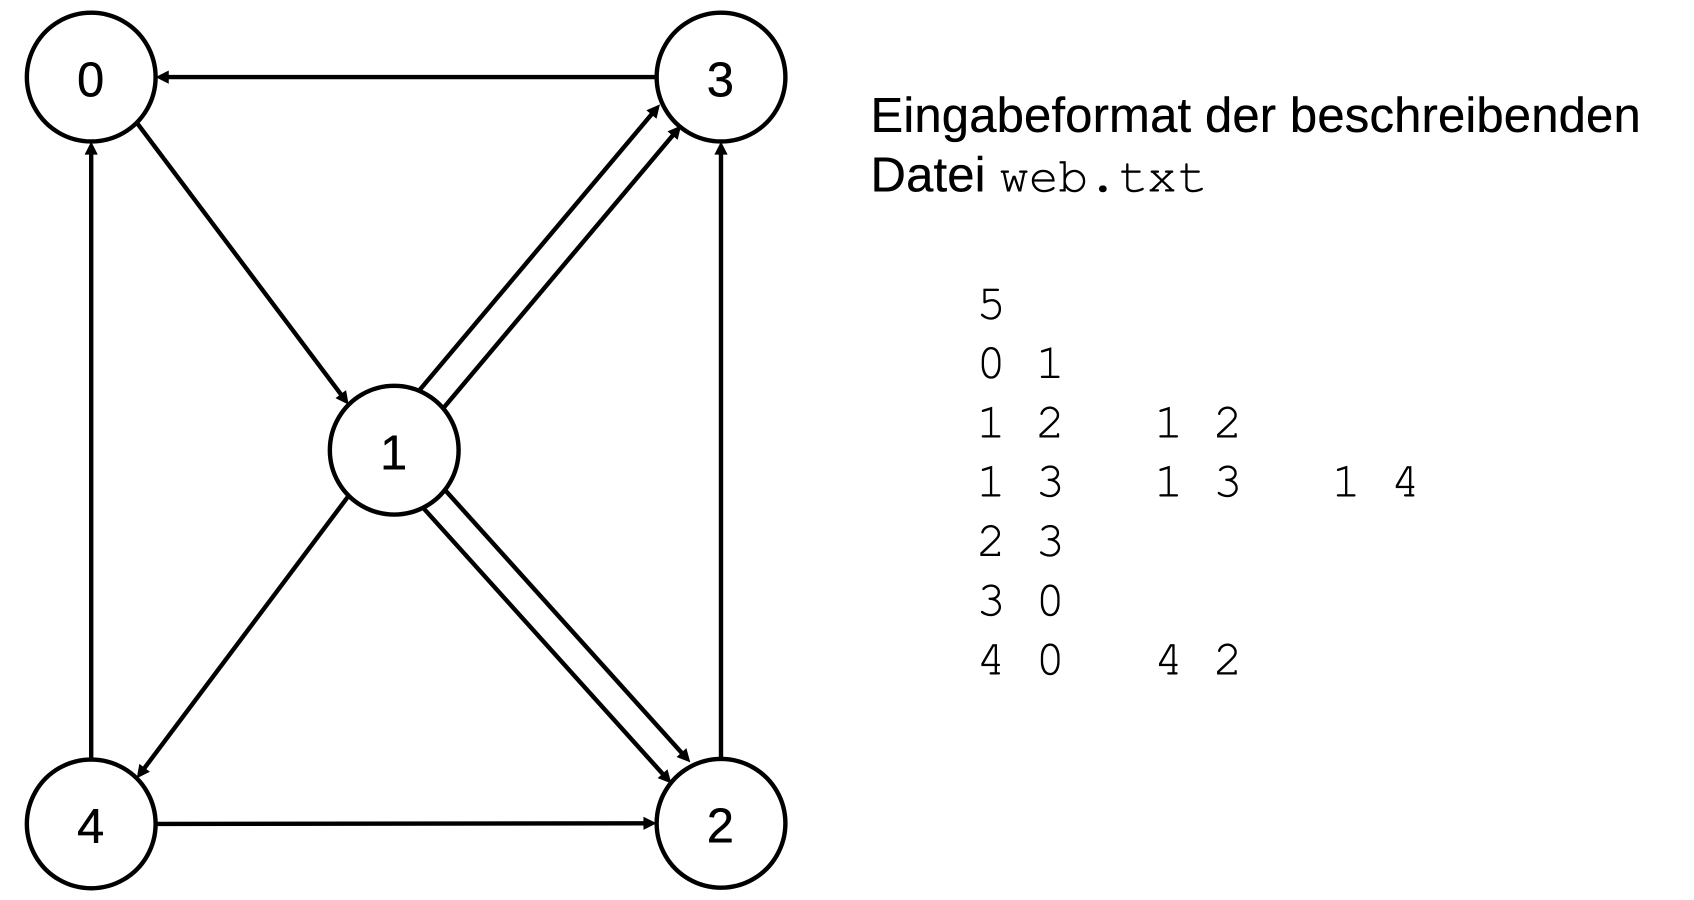
Für unser aktuelles Beispiel genügt es jedoch, wenn wir einfach davon ausgehen, dass es n Webseiten gibt, durchnummeriert von 0 bis n-1. Die Links repräsentieren wir durch geordnete Paare dieser Zahlen, wobei die erste Zahl die Seite angibt, die den Link enthält, und die zweite die Seite, auf die verlinkt wird. Gemäß diesen Konventionen ist ein einfaches Eingabeformat für das Zufallssurfer-Problem ein Eingabestrom, der einen Integer (den Wert von n) und eine Folge von Integer-Paaren (die Repräsentationen aller Links) aufweist. Da StdIn alle Folgen von Whitespace-Zeichen als einen einzigen Begrenzer behandelt, können wir frei entscheiden, ob wir pro Zeile nur einen Link oder mehrere Links angeben.
Übergangsmatrix
Wir verwenden eine zweidimensionale Matrix, die wir als Übergangsmatrix bezeichnen, um das Verhalten des Zufallssurfers vollständig festzulegen. Für n Webseiten definieren wir eine n\times n-Matrix, sodass das Element in Zeile i und Spalte j die Wahrscheinlichkeit angibt, dass der Zufallssurfer von Seite i zur Seite j surft. Unsere erste Aufgabe besteht nun darin, Code zu schreiben, der eine solche Matrix für jede beliebige Eingabe erzeugen kann. Für die 90/10-Regel ist diese Berechnung nicht besonders schwer. Wir gehen in drei Schritten vor:
- Wir lesen n ein und erzeugen die Arrays
counts[][]undoutDegree[]. - Wir lesen die Links ein und akkumulieren deren Zahl, sodass
counts[i][j]die Links von i nach j zählt undoutDegree[i]die Links von i nach überallhin. - Wir berechnen die Wahrscheinlichkeiten gemäß der 90/10-Regel.
Die ersten beiden Schritte sind ganz einfach und der dritte ist auch nicht viel schwerer: Multiplizieren Sie counts[i][j] mit 0.90/outDegree[i], wenn es einen Link von i nach j gibt (steuert einen Zufalls-Link mit der Wahrscheinlichkeit 0.9 an), und addieren Sie dann zu jedem Element 0.10/n (steuert eine Zufallsseite mit der Wahrscheinlichkeit 0.1 an). Problematisch ist es nur, wenn eine Seite keine ausgehenden Links hat. Dann kann ein Surfer nur manuelle Adressen eingeben (1.0/n).
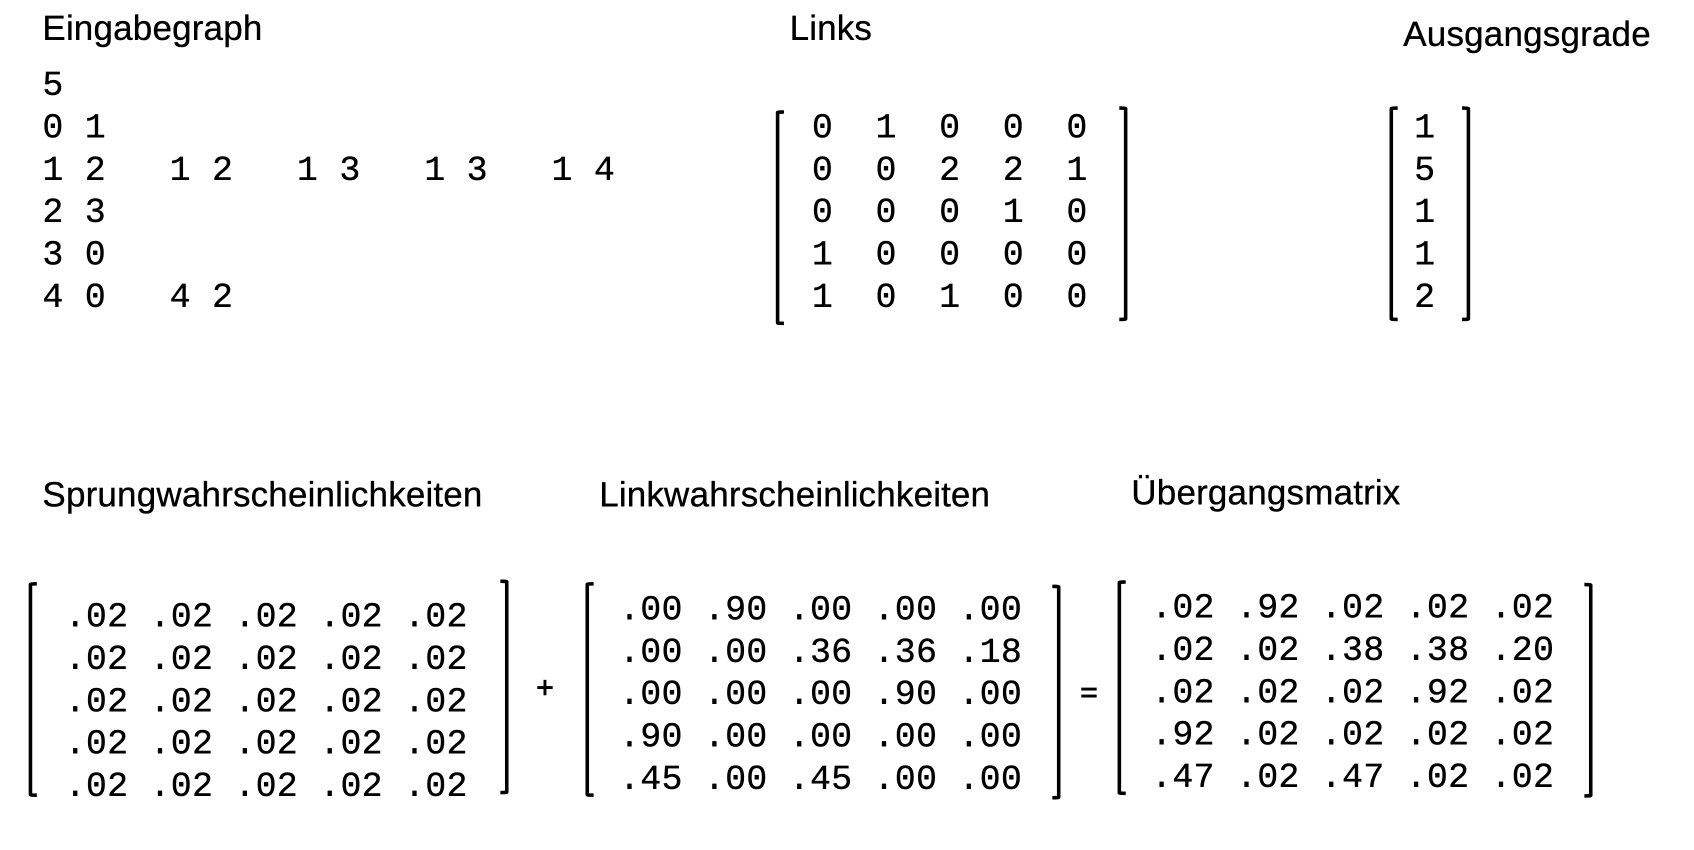
Die Übergangsmatrix ist vor allem deshalb so bedeutsam, weil jede Zeile eine diskrete Wahrscheinlichkeitsverteilung repräsentiert - die Einträge beschreiben vollständig den nächsten Schritt des Zufallssurfers, basierend auf den Wahrscheinlichkeiten für das Surfen zu jeder Seite. Beachten Sie insbesondere, dass die Summe der Einträge immer 1 ist (der Surfer steuert immer irgendeine Seite an). Die Ausgabe von Transition definiert ein anderes Dateiformat, und zwar eines für Matrizen von double-Werten. Es besteht aus den beiden Werten für die Anzahl der Zeilen und Spalten gefolgt von den Werten für die Matrixelemente. Jetzt können wir ein Programm schreiben, die Web-Beschreibung einlesen, zu verarbeiten und die entsprechende Übergangsmatrix auszugeben.
$ java Transition < data/web.txt
5 5
 0.02000  0.92000  0.02000  0.02000  0.02000
 0.02000  0.02000  0.38000  0.38000  0.20000
 0.02000  0.02000  0.02000  0.92000  0.02000
 0.92000  0.02000  0.02000  0.02000  0.02000
 0.47000  0.02000  0.47000  0.02000  0.02000
$ _
Simulation
Mit der Übergangsmatrix benötigen wir erstaunlich wenig Code, um das Verhalten des Websurfers zu simulieren.
Der Schlüssel zur Berechnung ist die Zufallsbewegung, die durch die Übergangsmatrix definiert wird. Wir richten eine Variable page ein, deren Wert die jeweils aktuelle Position des Surfers angibt. Die Zeile page der Matrix gibt für jedes j die Wahrscheinlichkeit an, dass sich der Surfer zum nächsten j bewegt. Mit anderen Worten, wenn sich der Surfer auf page befindet, ist es unsere Aufgabe – gemäß der Verteilung, die durch die Zeile page in der Übergangsmatrix (das eindimensionale Array p[page]) gegeben ist – einen zufälligen Integer zwischen 0 und n-1 zu erzeugen.
Wie können wir diese Aufgabe lösen? – Wir können Math.random() verwenden, um eine Zufallszahl r zwischen 0 und 1 zu erzeugen. Dabei stellen wir uns die Zeile page als einen Satz von n Intervallen aus [0, 1) vor, bei dem jede Wahrscheinlichkeit einer Intervalllänge entspricht. Dann fällt unsere Zufallsvariable r in eines der Intervalle, wobei die Wahrscheinlichkeit dafür genau durch die Intervalllänge gegeben ist. Diese Überlegung führt zu folgendem Code:
double sum = 0.0;
for (int j = 0; j < N; j++) {
    sum += p[page][j];
    if (r < sum) {
        page = j;
        break;
    }
}
Die Variable sum speichert nacheinander die Endpunkte der Intervalle, die in Zeile p[page] definiert sind, und die for-Schleife sucht nach dem Intervall, das den Zufallswert r enthält. So ermitteln wir die Seite, die der Surfer als nächstes aufruft.
$ java Transition < data/web.txt | java RandomSurfer 100000
 27.41800  26.60700  14.54100  24.75400   6.68000
$ _
Ein Vorteil unseres kleinen Programm-Systems ist es, es datengetrieben implementiert zu haben. Wir brauchen lediglich die Eingabedatei neu schreiben und können so eine alternative Webstruktur analysieren.
Besonders interessant scheint mir der Fall zu sein, wenn eine Seite keine ausgehenden Links besitzt, der Websurfer also quasi „in der Falle sitzt”. Er kann dann nur noch durch die manuelle Eingabe einer neuen Seite die aktuelle verlassen.
Das folgende Web-Modell stellt diese Situation dar. Seite 3 ist eine solche Falle. Man kann dort über Links hingelangen, die Seite über Links verlassen kann man nicht.
Die Preisfrage, die sich nun stellt ist: Ist eine solche Konstruktion förderlich, um die Anzahl der Seitenbesuche zu erhöhen. – SEO-Tools, wie beispielsweise Yoast-SEO bewerten es positiv, wenn eine Seite ausgehende Links besitzt. Ich denke, auch Google und andere Suchmaschinenanbieter bewerten das positiv. Sieht man aber von deren Rankings ab, so scheint es, als wäre solch eine Falle durchaus geeignet, einen Websurfer auf eine bestimmte Seite zu lenken und dort zu binden.
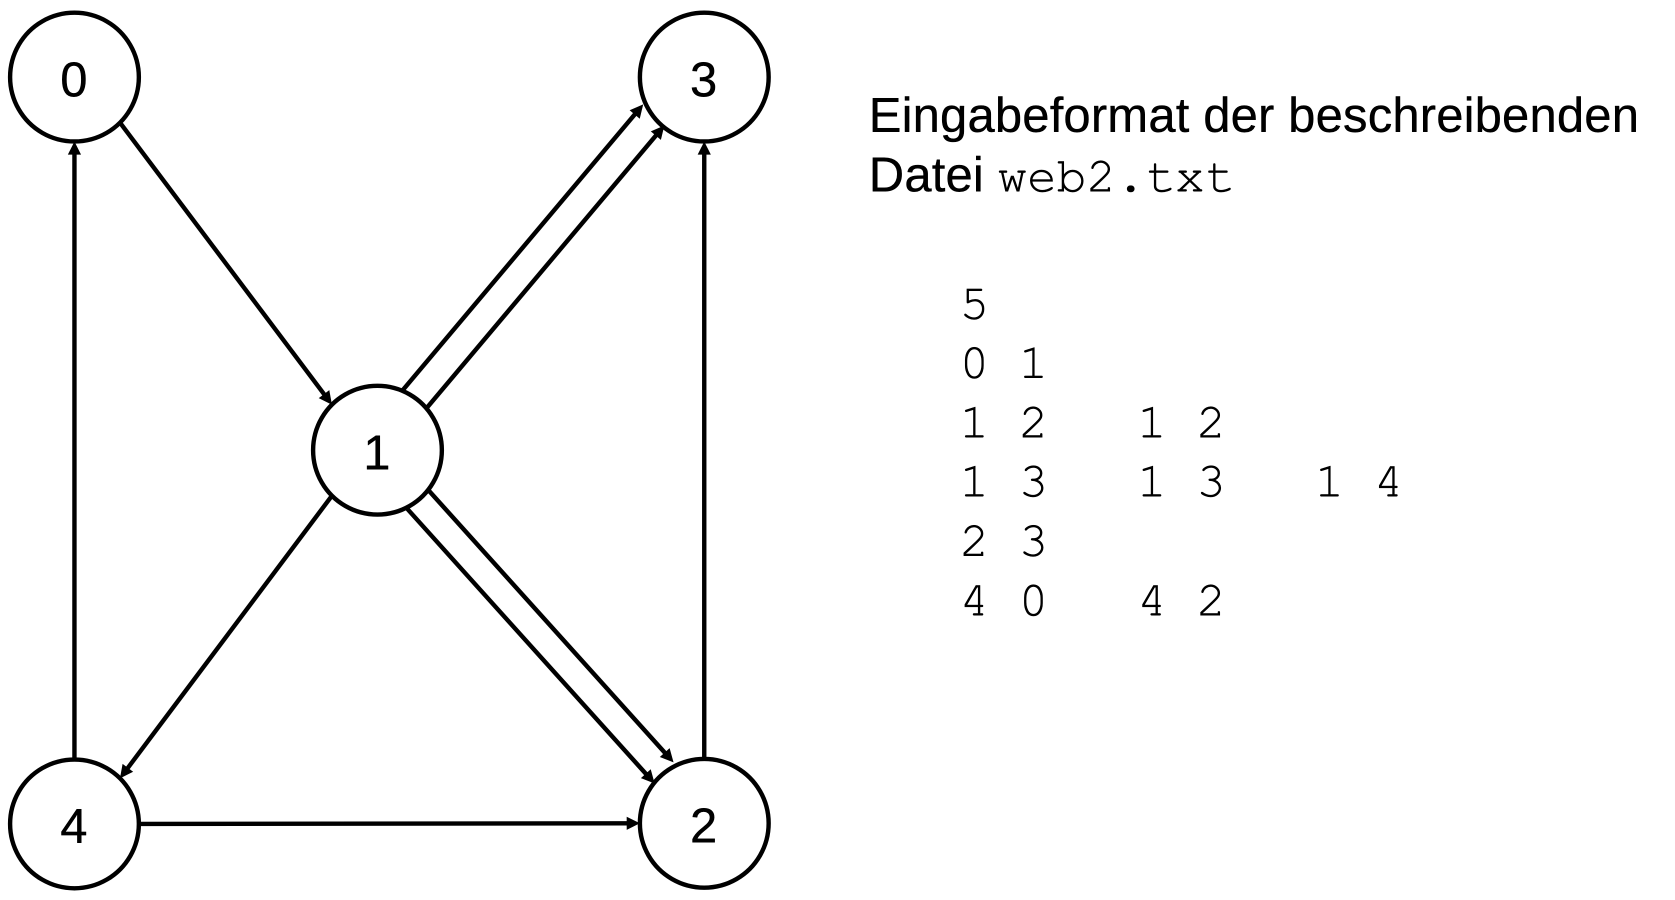
$ java Transition < data/web2.txt | java RandomSurfer 100000
 13.34300  20.07800  20.71100  34.11600  11.75200
$ _
Die modifizierten Links haben einen massiven Einfluss auf die wahrscheinlichen Besuchshäufigkeiten der Webseiten.
import StdLib.StdIn;
import StdLib.StdOut;

/**
 * RandomWebSurfer: Übergangsmatrix berechnen.
 */
public class Transition {
    /**
     * Die Web-Beschreibung wird aus einer Eingabe-Umleitung gelesen.
     *
     * @param args nicht genutzt.
     */
    public static void main(String[] args) {
        int n = StdIn.readInt();
        int[][] counts = new int[n][n];
        int[] degrees = new int[n];

        while (StdIn.hasNextToken()) {
            int i = StdIn.readInt();
            int j = StdIn.readInt();
            counts[i][j]++;
            degrees[i]++;
        }

        double p;
        StdOut.printf("%d  %d\n", n, n);
        for (int i = 0; i < n; i++) {
            for (int j = 0; j < n; j++) {
                if (degrees[i] != 0)
                    p = 0.9 * counts[i][j] / degrees[i] + 0.1/n;
                else
                    p = 1.0 / n;
                StdOut.printf("%8.5f ", p);
            }
            StdOut.println();
        }
    }
}
$ java Transition < data/web2.txt
5 5
0.02000 0.92000 0.02000 0.02000 0.02000
0.02000 0.02000 0.38000 0.38000 0.20000
0.02000 0.02000 0.02000 0.92000 0.02000
0.20000 0.20000 0.20000 0.20000 0.20000
0.47000 0.02000 0.47000 0.02000 0.02000
$ _import StdLib.StdIn;
import StdLib.StdOut;
/**
* RandomWebSurfer: Simulation.
*/
public class RandomSurfer {
/**
* Die Übergangsmatrix wird via Standardeingabe gelesen.
*
* @param args Anzahl der Simulationsschritte
*/
public static void main(String[] args) {
int T = Integer.parseInt(args[0]); // Anzahl Simulationen
// Übergangsmatrix einlesen (Wahrscheinlichkeiten pro Seite)
int N = StdIn.readInt(); // Dimensionierung
StdIn.readInt(); // 2. Dimension überlesen
double[][] p = new double[N][N]; // Übergangsmatrix
for (int i = 0; i < N; i++) { // einlesen ...
for (int j = 0; j < N; j++) {
p[i][j] = StdIn.readDouble();
}
}
int page = 0; // Start bei Seite 0
int[] hits = new int[N]; // Anzahl Treffer pro Seite
for (int t = 0; t < T; t++) {
double r = Math.random();
double sum = 0.0;
for (int j = 0; j < N; j++) {
sum += p[page][j];
if (r < sum) {
page = j;
break;
}
}
hits[page]++;
}
// Ausgabe der Page Ranks
for (int i = 0; i < N; i++)
StdOut.printf("%9.5f ", 100.0 * hits[i] / T);
StdOut.println();
}
}$ java Transition < data/web2.txt | java RandomSurfer 10000
13.86000 20.09000 20.69000 33.70000 11.66000
$ _Auch eine Seite ohne ausgehende Links kann in diesem Modell eine hohe Besuchshäufigkeit erreichen. Entscheidend dafür sind insbesondere die auf sie verweisenden Links; verlassen wird sie anschließend durch den Zufallssprung.
Übungen zu Kapitel Methoden
StdArray
Schreiben Sie eine Klasse StdArray mit folgenden Eigenschaften:
StdArray ist eine Hilfsbibliothek zum standardisierten Einlesen und Ausgeben von 1- und 2-dimensionalen Arrays der Typen int, double und boolean über StdIn und StdOut.
Format der Ein-/Ausgabe
Vor den eigentlichen Daten steht stets die Dimension:
- Vektor: eine positive ganze Zahl
n(Anzahl der Elemente) - Matrix: zwei positive ganze Zahlen
mundn(Zeilen, Spalten)
Boolesche Werte
Wahrheitswerte werden als 0 (für false) und 1 (für true) dargestellt (readBoolean()).
Beispiele
Beispiel - Vektor mit 4 double-Werten
4
  0.00000  0.24600  0.22200 -0.03200
Beispiel - 4x3-Matrix mit double-Werten
4 3
  0.00000  0.27000  0.00000
  0.24600  0.22400 -0.03600
  0.22200  0.17600  0.08930
 -0.03200  0.73900  0.27000
Beispiel - 4x3-Matrix mit Wahrheitswerten
4 3
  1 1 0
  0 0 0
  0 1 1
  1 1 1
Die folgenden statischen Methoden gilt es zu implementieren:
| Modifier und Typ | Methode | Beschreibung |
|---|---|---|
static void |
print(boolean[] a) |
Gibt Vektor auf StdOut aus. |
static void |
print(boolean[][] a) |
Gibt Matrix auf StdOut aus. |
static void |
print(double[] a) |
Gibt Vektor auf StdOut aus. |
static void |
print(double[][] a) |
Gibt Matrix auf StdOut aus. |
static void |
print(int[] a) |
Gibt Vektor auf StdOut aus. |
static void |
print(int[][] a) |
Gibt Matrix auf StdOut aus. |
static boolean[][] |
readBooleanMatrix() |
Liest Matrix von StdIn. |
static boolean[] |
readBooleanVector() |
Liest Vektor von StdIn. |
static double[][] |
readDoubleMatrix() |
Liest Matrix von StdIn. |
static double[] |
readDoubleVector() |
Liest Vektor von StdIn. |
static int[][] |
readIntMatrix() |
Liest Matrix von StdIn. |
static int[] |
readIntVector() |
Liest Vektor von StdIn. |
Implementieren Sie Ihre Klasse in einem eigenen Paket, beispielsweise ‘mytools’.
package mytools;

import StdLib.StdOut;
import StdLib.StdIn;
/**
 * {@code StdArray} ist eine kleine Hilfsbibliothek zum standardisierten
 * Einlesen und Ausgeben von 1- und 2-dimensionalen Arrays der Typen
 * {@code int}, {@code double} und {@code boolean} über {@link StdIn}
 * und {@link StdOut}.
 * <p>
 * <strong>Format der Ein-/Ausgabe</strong>
 * </p><p>
 * Vor den eigentlichen Daten steht stets die Dimension:
 * </p>
 * <ul>
 *   <li>Vektor: eine positive ganze Zahl {@code n} (Anzahl der Elemente)
 *   </li>
 *   <li>Matrix: zwei positive ganze Zahlen {@code m n} (Zeilen, Spalten)
 *   </li>
 * </ul>
 *
 * <strong>Boolesche Werte</strong>
 * <p>
 * Wahrheitswerte werden als {@code 0} (für {@code false}) und {@code 1}
 * (für {@code true}) dargestellt. Beim Einlesen wird dieses Format durch
 * {@link StdIn#readBoolean()} interpretiert.
 * </p>
 *
 * <strong>Beispiele</strong>
 * <p>
 * Die folgenden Beispiele sind bewusst als {@code <pre>} gesetzt, damit
 * sie in der generierten HTML-Dokumentation sauber monospaced und
 * zeilengetreu erscheinen.
 * </p>
 *
 * <p><b>Beispiel - Vektor mit 4 {@code double}-Werten</b></p>
 * <pre>
 * 4
 *  0.00000  0.24600  0.22200 -0.03200
 * </pre>
 *
 * <p><b>Beispiel - 4x3-Matrix mit {@code double}-Werten</b></p>
 * <pre>
 * 4 3
 *  0.00000  0.27000  0.00000
 *  0.24600  0.22400 -0.03600
 *  0.22200  0.17600  0.08930
 * -0.03200  0.73900  0.27000
 * </pre>
 *
 * <p><b>Beispiel - 4x3-Matrix mit Wahrheitswerten</b></p>
 * <pre>
 * 4 3
 *  1 1 0
 *  0 0 0
 *  0 1 1
 *  1 1 1
 * </pre>
 *
 * <p>
 * Java-Version: 17 oder höher
 * </p>
 *
 * @author Karsten Brodmann (kb@punkt-akademie.de)
 */
public class StdArray {

    // Instanziierung verhindern:
    // reine Utility-Klasse mit statischen Methoden.
    private StdArray() { }

    /**
     * Liest einen {@code double}-Vektor von {@link StdIn}.
     * <p>
     * <strong>Eingabeformat</strong>
     * <pre>
     * n
     * v0 v1 ... v(n-1)
     * </pre>
     *
     * @return eingelesener Vektor (Länge {@code n})
     */
    public static double[] readDoubleVector() {
        int n = StdIn.readInt();
        double[] a = new double[n];
        for (int i = 0; i < n; i++)
            a[i] = StdIn.readDouble();
        return a;
    }

    /**
     * Gibt einen {@code double}-Vektor auf {@link StdOut} aus.
     * <p>
     * <strong>Ausgabeformat</strong>
     * <p>
     * Zuerst wird {@code n} ausgegeben, danach die {@code n} Werte in
     * einer Zeile mit festem Format ({@code %9.5f}).
     * </p>
     *
     * @param a Vektor mit {@code double}-Werten
     */
    public static void print(double[] a) {
        int n = a.length;
        StdOut.println(n);
        for (int i=0; i<n; i++)
            StdOut.printf("%9.5f ", a[i]);
        StdOut.println();
    }

    /**
     * Liest eine {@code double}-Matrix von {@link StdIn}.
     * <p>
     * <strong>Eingabeformat</strong>
     * <pre>
     * m n
     * a00 a01 ... a0(n-1)
     * a10 a11 ... a1(n-1)
     * ...
     * a(m-1)0 ... a(m-1)(n-1)
     * </pre>
     *
     * @return eingelesene Matrix ({@code m} Zeilen, {@code n} Spalten)
     */
    public static double[][] readDoubleMatrix() {
        int m = StdIn.readInt();
        int n = StdIn.readInt();
        double[][] a = new double[m][n];
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                a[i][j] = StdIn.readDouble();
            }
        }
        return a;
    }

    /**
     * Gibt eine {@code double}-Matrix auf {@link StdOut} aus.
     * <p>
     * <strong>Ausgabeformat</strong>
     * </p>
     * <p>
     * Zuerst werden {@code m} und {@code n} ausgegeben, danach
     * folgen {@code m} Zeilen mit jeweils {@code n} Werten im
     * Format {@code %9.5f}.
     * </p>
     *
     * @param a Matrix mit {@code double}-Werten
     */
    public static void print(double[][] a) {
        int m = a.length;
        int n = a[0].length;
        StdOut.println(m + " " + n);
        for (int i=0; i<m; i++) {
            for (int j = 0; j < n; j++) {
                StdOut.printf("%9.5f ", a[i][j]);
            }
            StdOut.println();
        }
    }

    /**
     * Liest einen {@code int}-Vektor von {@link StdIn}.
     * <p>
     * <strong>Eingabeformat</strong>
     * <pre>
     * n
     * v0 v1 ... v(n-1)
     * </pre>
     *
     * @return eingelesener Vektor (Länge {@code n})
     */
    public static int[] readIntVector() {
        int n = StdIn.readInt();
        int[] a = new int[n];
        for (int i = 0; i < n; i++) {
            a[i] = StdIn.readInt();
        }
        return a;
    }

    /**
     * Gibt einen {@code int}-Vektor auf {@link StdOut} aus.
     * <p>
     * <strong>Ausgabeformat</strong>
     * </p>
     * <p>
     * Zuerst wird {@code n} ausgegeben, danach die {@code n} Werte in
     * einer Zeile im Format {@code %9d}.
     * </p>
     *
     * @param a Vektor mit {@code int}-Werten
     */
    public static void print(int[] a) {
        int n = a.length;
        StdOut.println(n);
        for (int i=0; i<n; i++) {
            StdOut.printf("%9d ", a[i]);
        }
        StdOut.println();
    }

    /**
     * Liest eine {@code int}-Matrix von {@link StdIn}.
     * <p>
     * <strong>Eingabeformat</strong>
     * <pre>
     * m n
     * a00 a01 ... a0(n-1)
     * ...
     * a(m-1)0 ... a(m-1)(n-1)
     * </pre>
     *
     * @return eingelesene Matrix ({@code m} Zeilen, {@code n} Spalten)
     */
    public static int[][] readIntMatrix() {
        int m = StdIn.readInt();
        int n = StdIn.readInt();
        int[][] a = new int[m][n];
        for (int i = 0; i < m; i++)
            for (int j = 0; j < n; j++)
                a[i][j] = StdIn.readInt();
        return a;
    }

    /**
     * Gibt eine {@code int}-Matrix auf {@link StdOut} aus.
     * <p>
     * <strong>Ausgabeformat</strong>
     * <p>
     * Zuerst werden {@code m} und {@code n} ausgegeben, danach folgen
     * {@code m} Zeilen mit jeweils {@code n} Werten im Format
     * {@code %9d}.
     * </p>
     *
     * @param a Matrix mit {@code int}-Werten
     */
    public static void print(int[][] a) {
        int m = a.length;
        int n = a[0].length;
        StdOut.println(m + " " + n);
        for (int i=0; i<m; i++) {
            for (int j = 0; j < n; j++)
                StdOut.printf("%9d ", a[i][j]);
            StdOut.println();
        }
    }

    /**
     * Liest einen {@code boolean}-Vektor von {@link StdIn}.
     * <p>
     * <strong>Darstellung</strong>
     * <p>
     * Es gilt: {@code 0 == false}, {@code 1 == true}.
     * </p>
     *
     * <strong>Eingabeformat</strong>
     * <pre>
     * n
     * b0 b1 ... b(n-1)
     * </pre>
     *
     * @return eingelesener Vektor (Länge {@code n})
     */
    public static boolean[] readBooleanVector() {
        int n = StdIn.readInt();
        boolean[] a = new boolean[n];
        for (int i = 0; i < n; i++)
            a[i] = StdIn.readBoolean();
        return a;
    }

    /**
     * Gibt einen {@code boolean}-Vektor auf {@link StdOut} aus.
     * <p>
     * <strong>Darstellung</strong>
     * <p>
     * Es gilt: {@code 0 == false}, {@code 1 == true}.
     * </p>
     *
     * @param a Vektor mit {@code boolean}-Werten
     */
    public static void print(boolean[] a) {
        int n = a.length;
        StdOut.println(n);
        for (int i=0; i<n; i++)
            StdOut.print(a[i] ? "1 " : "0 ");
        StdOut.println();
    }

    /**
     * Liest eine {@code boolean}-Matrix von {@link StdIn}.
     * <p>
     * <strong>Darstellung</strong>
     * <p>
     * Es gilt: {@code 0 == false}, {@code 1 == true}.
     * </p>
     *
     * <strong>Eingabeformat</strong>
     * <pre>
     * m n
     * b00 b01 ... b0(n-1)
     * ...
     * b(m-1)0 ... b(m-1)(n-1)
     * </pre>
     *
     * @return eingelesene Matrix ({@code m} Zeilen, {@code n} Spalten)
     */
    public static boolean[][] readBooleanMatrix() {
        int m = StdIn.readInt();
        int n = StdIn.readInt();
        boolean[][] a = new boolean[m][n];
        for (int i = 0; i < m; i++) {
            for (int j = 0; j < n; j++) {
                a[i][j] = StdIn.readBoolean();
            }
        }
        return a;
    }

    /**
     * Gibt eine {@code boolean}-Matrix auf {@link StdOut} aus.
     * <p>
     * <strong>Darstellung</strong>
     * <p>
     * Es gilt: {@code 0 == false}, {@code 1 == true}.
     * </p>
     *
     * <strong>Ausgabeformat</strong>
     * <p>
     * Zuerst werden {@code m} und {@code n} ausgegeben, danach
     * folgen {@code m} Zeilen mit jeweils {@code n} Werten, jeweils
     * als {@code 0} oder {@code 1}.
     * </p>
     *
     * @param a Matrix mit {@code boolean}-Werten
     */
    public static void print(boolean[][] a) {
        int m = a.length;
        int n = a[0].length;
        StdOut.println(m + " " + n);
        for (int i=0; i<m; i++) {
            for (int j = 0; j < n; j++) {
                StdOut.print(a[i][j] ? "1 " : "0 ");
            }
            StdOut.println();
        }
    }
}
Übungen zu Kapitel Rekursion
Rückwärts zählen
Schreiben Sie ein Programm ReverseCounter.java. Das Programm liest eine Startzahl als Kommandozeilenargument ein und zählt dann abwärts bis zur 0. Formulieren Sie das Programm rekursiv.
Beispiele:
$ java ReverseCounter 10
10 9 8 7 6 5 4 3 2 1 0
$ java ReverseCounter 20
20 19 18 17 16 15 14 13 12 11 10 9 8 7 6 5 4 3 2 1 0
$ _import StdLib.StdOut;
/**
* Ausgabe von Zahlen in absteigender Reihenfolge.
*/
public class ReverseCounter {
/* rekursive Methode zum Ausgaben der
* abwärts gezählten Zahlen
*/
public static void countReverse(int i) {
// Basisfall / Rekursionsbremse
// 0 noch ausgeben, kleiner 0 nicht ausgeben
if (i < 0) {
StdOut.println();
return;
}
StdOut.printf("%d ", i);
i = i - 1;
countReverse(i);
}
/**
* Anzahl der auszugebenden Zahlen wird als Kommandozeilenargument
* eingelesen.
*
* @param args Startzahl
*/
public static void main(String[] args) {
int count = Integer.parseInt(args[0]);
countReverse(count);
}
}Linealfunktion
Im Kapitel Java des Skripts haben wir das Programm Ruler.java geschrieben. Schreiben Sie jetzt eine flexiblere Version PrintRuler.java. Das Programm erwartet die Anzahl der Intervalle-Striche pro halbes Inch und die Anzahl der auszugebenden Inches als Kommandozeilenargumente.
Beispiele (gekürzte Ausgaben):
$ java PrintRuler 2 2
----0
--
----1
--
----2
$ java PrintRuler 3 3
--------0
--
----
--
--------1
...
--------2
--
----
--
--------3
$ java PrintRuler 5 8
--------------------------------0
--
----
--
--------
--
----
--
----------------
...
--
--------------------------------7
--
----
--
--------
--
----
--
----------------
--
----
--
--------
--
----
--
--------------------------------8
$ _
Formulieren Sie geeignete Methoden und nutzen Sie Rekursion.
import StdLib.StdOut;

/**
 * Lineal-Funktion.
 */
public class PrintRuler {

    // Intervall-Strich ausgeben.
    private static void draw_line(int tick_length, String tick_label) {
        String line = "-";
        for (int i=0; i< tick_length; i++)
            line += line;
        if (!tick_label.isEmpty())
            line += tick_label;
        StdOut.println(line);
        }

    // Ausgabe eines Intervalls
    private static void draw_interval(int center_length) {
        if (center_length > 0) {  // Basisfall / Rekursionsbremse
            draw_interval(center_length - 1);
            draw_line(center_length, "");
            draw_interval(center_length - 1);
        }
    }

    // Lineal ausgeben
    private static void draw_ruler(int major_length, int num_inches) {
        draw_line(major_length, "0");
        for (int j = 1; j <= num_inches; j++) {
            draw_interval(major_length - 1);
            draw_line(major_length, String.format("%d", j));
        }
    }

    /**
     * Die Anzahl der Inches und Haupt-Intervall-Striche
     * werden als Kommandozeilenargumente angegeben.
     *
     * @param args <br>[0] - Anzahl der Intervall-Striche
     *             <br>[1] - Anzahl der auszugebenden Inches
     */
    public static void main(String[] args) {
        int major_length = Integer.parseInt(args[0]);
        int num_inches = Integer.parseInt(args[1]);
        draw_ruler(major_length, num_inches);
    }
}
Übungen zu Kapitel Sortieren
ShakerSort
ShakerSort, auch bekannt als Cocktail-Shaker-Sort, Cocktail-Sort oder bidirektionaler Bubble-Sort, ist ein Sortieralgorithmus, der auf dem Bubble-Sort-Verfahren basiert. Er verbessert diesen jedoch, indem er die Liste nicht nur in eine Richtung, sondern wechselweise in beiden Richtungen (vorwärts und rückwärts) durchläuft.
Implementieren Sie ShakerSort.java. Halten Sie sich an die Konventionen, die wir bei den im Seminar behandelten Sortieralgorithmen etabliert haben. Nutzen Sie SortDriver, um Ihre Implementierung zu testen.
Vergleichen Sie die Ergebnisse für bereits sortierte und zufällige Daten.
Welche Aussagen können Sie zu Laufzeitverhalten, Speicherkomplexität und Stabilität bezüglich des ShakerSorts treffen? Begründen Sie Ihre Aussagen.
/** Sortierung eines {@code int}-Arrays mit ShakerSort */
public class ShakerSort {
    /**
     * Sortiert ein {@code int}-Array {@code a} mithilfe des
     * ShakerSort-Algorithmus.
     *
     * @param a zu sortierendes Array
     */
    public static void sort(int[] a) {
        boolean swapped;
        do {
            swapped = false;
            // links nach rechts(analog zu Bubble Sort)
            for (int i = 0; i < a.length - 1; i++) {
                if (a[i] > a[i + 1]) {
                    int temp = a[i];
                    a[i] = a[i + 1];
                    a[i + 1] = temp;
                    swapped = true;
                }
            }

            // wenn nicht getauscht, fertig
            if (!swapped) break;

            swapped = false;
            // Right-to-left pass
            for (int i = a.length - 2; i >= 0; i--) {
                if (a[i] > a[i + 1]) {
                    int temp = a[i];
                    a[i] = a[i + 1];
                    a[i + 1] = temp;
                    swapped = true;
                }
            }
        } while (swapped);
    }
}
Zeitkomplexität (Best Case): \mathcal{O}(n) - Wenn die Liste bereits sortiert ist (ein Durchgang).
Zeitkomplexität (Worst/Average Case): \mathcal{O}(n^2) - Wie BubbleSort ist der ShakerSort bei großen Datenmengen ineffizient.
Stabilität: ShakerSort ist ein stabiler Sortieralgorithmus (gleiche Elemente behalten ihre relative Reihenfolge).
Speicherkomplexität: \mathcal{O}(1). ShakerSort arbeitet in-place und benötigt nur konstanten zusätzlichen Speicher.
Der Wechsel zwischen „größtes Element nach rechts” und „kleinstes Element nach links” bringt nur eine marginale Verbesserung gegenüber BubbleSort. Zwar werden kleinere Elemente schneller an ihre Position gebracht, insgesamt sind die Schrittweiten der Verschiebung, analog zum BubbleSort zu kurz, als dass sie effizient wären. Das Vor und Zurück ergibt zusammen mit der äußeren while-Schleife immer noch eine quadratische Abhängigkeit von n.
Übungen zu Kapitel OOP
Implementieren und testen Sie die folgenden Klassen.
Time
Implementieren Sie eine Klasse Time, die eine Uhrzeit im 24-Stunden-Format beschreibt.
Anforderungen
Eine Uhrzeit besteht aus:
- Stunde: 0 .. 23
- Minute: 0 .. 59
- Sekunde: 0 .. 59
Ungültige Werte sollen zu einer IllegalArgumentException führen.
Funktionalität
- Konstruktor:
Time(int hour, int minute, int second) - Methoden:
- Getter für Stunde, Minute und Sekunde
void tick(): erhöht die Uhrzeit um genau eine SekundeString toString(): gibt die Uhrzeit im Format HH:MM:SS aus (zweistellig, mit führenden Nullen)
Die Klasse Time ist veränderlich (mutable). Lesen Sie vor Beginn der Implementierung die Aufgabe zur Klasse DateTime. Was müssen Sie aufgrund der Veränderlichkeit von Time bei deren Implementierung beachten?
package oop;

/**
 * Die Klasse {@code Time} implementiert eine Uhrzeit
 * im 24-Stunden-Format.
 */
public class Time {

    private int hour;
    private int minute;
    private int second;

    /**
     * Erzeugung eine neuen {@code Time}-Instanz.
     *
     * @param hour Stunde
     * @param minute Minute
     * @param second Sekunde
     */
    public Time(int hour, int minute, int second) {
        if (hour < 0 || hour > 23) {
            throw new IllegalArgumentException("hour out of range");
        }
        if (minute < 0 || minute > 59) {
            throw new IllegalArgumentException("minute out of range");
        }
        if (second < 0 || second > 59) {
            throw new IllegalArgumentException("second out of range");
        }
        this.hour = hour;
        this.minute = minute;
        this.second = second;
    }

    /**
     * Stunde der aktuellen Instanz zurückgeben.
     *
     * @return Stunde
     */
    public int getHour() {
        return hour;
    }

    /**
     * Minute der aktuellen Instanz zurückgeben.
     *
     * @return Minute
     */
    public int getMinute() {
        return minute;
    }

    /**
     * Sekunde der aktuellen Instanz zurückgeben.
     *
     * @return Sekunde
     */
    public int getSecond() {
        return second;
    }

    /**
     * Erhöht die Uhrzeit um genau eine Sekunde.
     */
    public void tick() {
        second++;
        if (second == 60) {
            second = 0;
            minute++;
            if (minute == 60) {
                minute = 0;
                hour++;
                if (hour == 24) {
                    hour = 0;
                }
            }
        }
    }

    /**
     * Liefert die Uhrzeit im Format hh.mm.ss.
     *
     * @see java.lang.Object#toString()
     */
    @Override
    public String toString() {
        return String.format("%02d:%02d:%02d", hour, minute, second);
    }
}
DateTime
Implementieren Sie eine Klasse DateTime, die Datum und Uhrzeit kombiniert.
Hinweis: DateTime besteht aus einem Date-Objekt und einem Time-Objekt.
Verwenden Sie Assoziation / Komposition. Vererbung (extends) ist hier ausdrücklich nicht erlaubt.
Anforderungen
DateTime enthält: ein Date-Objekt und ein Time-Objekt.
Funktionalität
- Konstruktor:
DateTime(Date date, Time time) - Methoden:
- Getter Datum und Uhrzeit
void tick(): erhöht den Zeitpunkt um eine Sekunde (bei Überlauf von 23:59:59 ist der nächste Tag zu setzen)String toString(): z.B. 2026-02-10 14:37:05
Die Klasse soll sich gegen nachträgliche Änderungen der übergebenen Date- und Time-Objekte schützen.
Weitere Ausgestaltungen sind Ihnen überlassen.
package oop;

/**
 * Die Klasse {@code DateTime} vereint die Klassen {@link oop.Date} und
 * {@link oop.Time} zu einer Einheit.
 */
public class DateTime {

    private final Date date;
    private final Time time;

    /**
     * Erzeugung einer neuen {@code DateTime}-Instanz
     *
     * @param date Datum
     * @param time Uhrzeit
     */
    public DateTime(Date date, Time time) {
        if (date == null || time == null) {
            throw new IllegalArgumentException("Datum oder Zeit ist null");
        }
        // defensive Kopien
        this.date = new Date(date);
        this.time = new Time(time.getHour(), time.getMinute(), time.getSecond());
    }

    /**
     * Rückgabe des Datums der aktuellen Instanz.
     *
     * @return Datum
     */
    public Date date() {
        return new Date(date);
    }

    /**
     * Rückgabe der Uhrzeit der aktuellen Instanz.
     *
     * @return Uhrzeit
     */
    public Time time() {
        return new Time(time.getHour(), time.getMinute(), time.getSecond());
    }

    /**
     * Erhöht den Zeitpunkt um eine Sekunde.
     */
    public void tick() {
        int oldHour = time.getHour();
        time.tick();

        // Tageswechsel: 23:59:59 -> 00:00:00
        if (oldHour == 23 &&
            time.getHour() == 0 &&
            time.getMinute() == 0 &&
            time.getSecond() == 0) {
            date.nextDay();
        }
    }

    /**
     * Liefert Datum und Uhrzeit im Format: TT.MM.JJJJ hh.mm.ss.
     *
     * @see java.lang.Object#toString()
     */
    @Override
    public String toString() {
        return date.toString() + " " + time.toString();
    }
}
Damit die Klasse übersetzt werden kann, muss die Klasse oop.Date um nextDay() ergänzt werden. Wir wollen nicht die Datumslogik in DateTime re-implementieren. Eine Klasse zu einem späteren Zeitpunkt ergänzen zu müssen, ist in der Praxis auch kein seltener Fall. Wichtig dabei zu beachten ist jedoch, die bisherige API der Klasse nicht zu verändern.
/**
 * Datum auf den nächsten Tag setzen.
 */
public void nextDay() {
    try {
        setDay(day+1);
    } catch (IllegalArgumentException e1) {
        // zulässige Tageszahl des Monats überschritten
        // -> Tag muss 1 sein, Monat plus 1
        try {
            setDay(1);
            setMonth(month+1);
        } catch (IllegalArgumentException e2) {
            // jetzt ist uns der Monat um die Ohren geflogen
            // -> Monat muss 1 sein, Jahr plus 1
            setMonth(1);
            setYear(year+1);


        }
    }
}
Beispielsitzung:
$ java DateTimeTest
28.02.2028 23:59:55
28.02.2028 23:59:56
28.02.2028 23:59:57
28.02.2028 23:59:58
28.02.2028 23:59:59
29.02.2028 00:00:00
29.02.2028 00:00:01
29.02.2028 00:00:02
29.02.2028 00:00:03
29.02.2028 00:00:04
29.02.2028 00:00:05
$ _
Übungen zu Kapitel ADT
Doppelt verkettete Liste
Im Seminar haben wir eine einfach verkettete Liste SingleLinkedList.java implementiert. Implementieren Sie jetzt eine doppelt verkettete Liste.
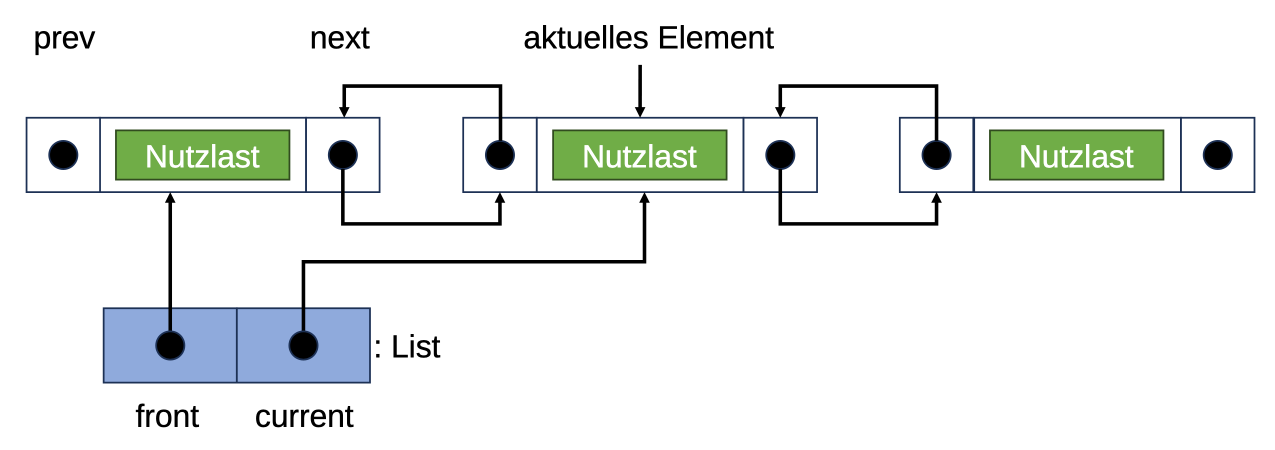
Bei der doppelt verketteten Liste haben wir zwei Verweise pro Listenelement. Ein Verweis referenziert das Vorgängerelement, der andere das Nachfolgeelement. Der Vorteil der doppelt verketteten List besteht darin, die Liste vorwärts und rückwärts durchlaufen zu können.
Orientieren Sie sich am List-Interface List.java. Auch die doppelt verkettete Liste implementiert dieses Interface. Beachten Sie insbesondere das im Interface spezifizierte Verhalten von insert().
Implementieren Sie mindestens eine Methode backward(), die das Zurückgehen in der Liste ermöglicht. Diese Methode ist nicht Bestandteil des Interfaces. Weitere Methoden sind Ihnen freigestellt.
Beachten Sie: Das Listen-Interface wird nicht ergänzt. Es stellt weiterhin die offizielle Minimal-Schnittstelle für Listen dar. Die doppelt verkettete Liste bietet lediglich mehr Funktionalität. Sie verhält sich jedoch, auf das Listen-Interface reduziert, genauso wie eine einfach verkettete Liste. D.h., auch die von uns implementierte Enumeration, EnumList.java, zur Iteration über eine Listen-Instanz muss bezüglich einer doppelt verketteten Liste funktionieren.
An der folgenden Liste können Sie sich orientieren, um Ihre Implementierung zu testen.
Beispiel-Testfälle zur Selbstkontrolle
1. Leere Liste
empty()\rightarrowtrueendpos()\rightarrowtruecontent()\rightarrow Exceptiondelete()\rightarrow Exception
2. Einzelelementliste
insert(1)reset(); content()\rightarrow 1delete()\rightarrow Liste leerendpos()\rightarrow true
3. Löschen am Anfang
Ausgangsliste: [1,2,3] - reset(); delete() - Erwartete Liste: [2,3] - Cursor zeigt auf 2
4. Löschen in der Mitte
Ausgangsliste: [1,2,3] - reset(); forward(); delete() - Erwartete Liste: [1,3] - Cursor zeigt auf 3
5. Löschen am Ende
Ausgangsliste: [1,2,3]
reset(); forward(); forward(); delete()- Erwartete Liste: [1,2]
- Cursor ist Endposition
6. Fehlerfälle an der Endposition
Ausgangsliste: [1,2,3] - reset(); forward(); forward(); forward() - content() \rightarrow Exception - delete() \rightarrow Exception
package adt;

import java.util.NoSuchElementException;

/**
 * Generische Implementierung einer doppelt verketteten
 * Liste mit Elementen vom Datentyp {@code T}.
 *
 * @param <T> Datentyp der Elemente
 */
public class DoubleLinkedList<T> implements List<T> {

    // Listenelement
    private static class Node<T> {

        private T data;
        private Node<T> next;
        private Node<T> prev;

        /**
         * Konstruktor.
         *
         * @param data Datenlast
         */
        Node(T data) {
            this(null, data, null);
        }

        /**
         * Konstruktor.
         *
         * @param data datenlast
         * @param next Verweis auf Nachfolgeknoten
         * @param prev Verweis auf Vorgängerknoten
         */
        Node(Node<T> prev, T data, Node<T> next) {
            this.data = data;
            this.next = next;
            this.prev = prev;
        }
    }

    private Node<T> front;   // Erstes Element der Liste (Skizze)
    private Node<T> current; // Aktuelles Element (Skizze)
    private Node<T> tail;    // Hilfszeiger auf das letzte Element (für Einfügen am Ende)
    private int size;

    /**
     * Konstruktor (leere Liste).
     */
    public DoubleLinkedList() {
        front = current = tail = null;
        size = 0;
    }

    @Override
    public boolean empty() {
        return front == null;
    }

    @Override
    public boolean endpos() {
        // Endposition ist erreicht, wenn current über das Ende hinausläuft (null wird)
        return current == null;
    }

    @Override
    public void reset() {
        current = front;
    }

    @Override
    public void forward() {
        if (!endpos()) {
            current = current.next;
        }
    }

    /**
     * Bewegt das aktuelle Element eine Position rückwärts
     * (Zusatzanforderung ggü. der einfach verketteten Liste).
     */
    public void backward() {
        if (current == front) {
            // Wenn wir am Anfang sind, schiebt ein Schritt zurück
            // den Zeiger vor den Anfang (null)
            current = null;
        } else if (endpos()) {
            // Wenn wir in der Endposition sind, springen wir zum
            // letzten Element
            current = tail;
        } else {
            current = current.prev;
        }
    }

    @Override
    public T content() {
        if (endpos()) {
            throw new NoSuchElementException(
                "Kein Element an der aktuellen Position vorhanden.");
        }
        return current.data;
    }

    @Override
    public void insert(T obj) {
        Node<T> newNode = new Node<>(obj);

        // Fall 1: Liste ist komplett leer
        if (empty()) {
            front = newNode;
            tail = newNode;
            current = newNode;
            size++;
            return;
        }

        // Fall 2: Am Ende einfügen (wenn current in Endposition ist)
        if (endpos()) {
            tail.next = newNode;
            newNode.prev = tail;
            tail = newNode;
            current = newNode; // Eingefügtes Element wird aktuelles Element
            size++;
            return;
        }

        // Fall 3: Am Anfang der Liste einfügen (vor das bisherige front)
        if (current == front) {
            newNode.next = front;
            front.prev = newNode;
            front = newNode;
            current = newNode;
            size++;
            return;
        }

        // Fall 4: Mittendrin einfügen (vor das aktuelle Element)
        Node<T> previousNode = current.prev;

        previousNode.next = newNode;
        newNode.prev = previousNode;

        newNode.next = current;
        current.prev = newNode;

        current = newNode; // Eingefügtes Element wird aktuelles Element

        size++;
    }

    @Override
    public void delete() {
        if (empty() || endpos()) {
            throw new NoSuchElementException(
             "Kein Element an der aktuellen Position vorhanden.");
        }

        // Fall 1: Das einzige Element löschen
        if (current == front && current == tail) {
            front = null;
            tail = null;
            current = null;
            size--;
            return;
        }

        // Fall 2: Das erste Element löschen
        if (current == front) {
            front = front.next;
            front.prev = null;
            current = front;
            size--;
            return;
        }

        // Fall 3: Das letzte Element löschen
        if (current == tail) {
            tail = tail.prev;
            tail.next = null;
            current = null; // Nach dem letzten Element ist Endposition
            size--;
            return;
        }

        // Fall 4: Mittendrin löschen
        Node<T> previousNode = current.prev;
        Node<T> nextNode = current.next;

        previousNode.next = nextNode;
        nextNode.prev = previousNode;

        current = nextNode; // Nachfolgendes Element wird aktuelles Element
        size--;
    }

    /**
     * Größe der Liste.
     *
     * @return Anzahl der Elemente in der Liste
     */
    public int getSize() {
        return size;
    }
}
Testclient mit Testfällen:
import adt.DoubleLinkedList;
import adt.EnumList;
import StdLib.StdOut;

/**
 * Testclient für {@link adt.DoubleLinkedList}.
 */
public class DoubleLinkedListTest {
    /**
     * Hauptprogramm.
     *
     * @param args nicht genutzt
     */
    public static void main(String[] args) {
        // 1. Instanziierung der doppelt verketteten Liste
        DoubleLinkedList<String> list = new DoubleLinkedList<>();

        StdOut.println("--- Schritt 1: Elemente einfügen ---");
        // Liste ist leer -> fügt "Apfel" ein
        list.insert("Apfel");
        // current steht auf "Apfel" -> fügt "Banane" davor ein
        list.insert("Banane");

        StdOut.print("Liste vorwärts durchlaufen: ");
        printListForward(list); // Erwartet: Banane -> Apfel

        StdOut.println("\n--- Schritt 2: Am Ende in Endposition einfügen ---");
        list.reset();
        list.forward();
        list.forward(); // current ist nun null (Endposition)

        StdOut.println("Befindet sich in Endposition? " + list.endpos()); // true

        // Einfügen in Endposition hängt das Element hinten an
        list.insert("Kirsche");
        StdOut.print("Liste nach Einfügen in Endposition: ");
        printListForward(list); // Erwartet: Banane -> Apfel -> Kirsche

        StdOut.println("\n--- Schritt 3: Rückwärts-Navigation testen ---");
        list.reset(); // current steht auf "Banane"
        list.forward(); // "Apfel"
        list.forward(); // "Kirsche"

        StdOut.println("Aktuelles Element vor backward(): " + list.content()); // Kirsche
        list.backward();
        StdOut.println("Aktuelles Element nach 1x backward(): " + list.content()); // Apfel
        list.backward();
        StdOut.println("Aktuelles Element nach 2x backward(): " + list.content()); // Banane

        StdOut.println("\n--- Schritt 4: EnumList-Iterator testen ---");
        EnumList<String> enumerator = new EnumList<>(list);
        StdOut.print("Ausgabe über EnumList-Iterator: ");
        while (enumerator.hasMoreElements()) {
            StdOut.print(enumerator.nextElement() + " ");
        }
        StdOut.println();

        StdOut.println("\n--- Schritt 5: Löschen testen ---");
        list.reset();
        list.forward(); // Wechselt zu "Apfel"
        StdOut.println("Lösche aktuelles Element (" + list.content() + ")...");
        list.delete(); // Löscht "Apfel", current springt auf "Kirsche"

        StdOut.print("Liste nach dem Löschen: ");
        printListForward(list); // Erwartet: Banane -> Kirsche
    }

    // Kleine Hilfsmethode zum schnellen Ausgeben der Liste
    private static void printListForward(DoubleLinkedList<String> list) {
        list.reset();
        while (!list.endpos()) {
            StdOut.print(list.content() + " -> ");
            list.forward();
        }
        StdOut.println("null");
    }
}
Maus im Labyrinth
Stellen Sie sich ein Labyrinth vor, gegeben durch eine Matrix. Nullen kennzeichnen freie Wege, Einsen stehen für Mauern.
5  5
12 12
 1  1  1  1  1  1  1  1  1  1  1  1
 1  1  1  0  1  1  1  1  1  1  1  1
 1  1  1  0  1  0  0  0  0  0  0  1
 1  1  1  0  1  1  1  1  0  1  0  1
 1  1  1  0  1  0  1  1  0  1  0  1
 1  1  1  0  0  0  1  1  0  1  0  1
 1  1  1  1  1  0  0  0  0  1  0  1
 1  1  1  1  1  0  0  1  1  1  0  1
 1  1  1  1  0  0  0  0  0  1  0  1
 1  1  1  1  0  1  1  1  1  1  0  1
 1  1  1  1  0  1  1  1  0  0  0  1
 1  1  1  1  0  1  1  1  0  1  1  1
In der ersten Zeile steht die Position innerhalb der Matrix, an welcher die Maus startet, um einen Ausweg aus dem Labyrinth zu finden. Der Rest entspricht dem bereits bekannten Format zum Einlesen beziehungsweise Ausgeben einer (standardisierten) Matrix mithilfe der in StdArray implementierten Methoden.
Sie können die Matrix, nachdem Sie die Koordinaten der Mausposition jeweils mittels der Methode readInt() eingelesen haben, mit readIntMatrix einlesen.
Geben Sie die Matrix nach dem Einlesen aus. Mauern stellen Sie mit einem *-Symbol dar, freie Flächen jeweils mit einem Leerzeichen.
Schreiben Sie ein Programm MouseLab.java welches die Maus einen Weg aus dem Labyrinth finden lässt. Die Maus soll eventuelle Wege nach dem folgenden Schema versuchen: links, rechts, rauf, runter - nicht zufällig.
Dabei kann die Maus in eine Sackgasse geraten. Sie müssen sich also die beschrittenen Wege merken, um Sie nötigenfalls rückgängig zu machen und einen anderen Weg auszuprobieren. Hat die Maus einen Ausgang (Randfeld mit Null) gefunden, soll das Programm enden und den erfolgreichen Weg ausgeben. Der Weg der Maus ist mit einem o-Symbol darzustellen. Gibt es keinen Ausgang, soll eine entsprechende Meldung ausgegeben werden.
Verwenden Sie einen von uns implementierten ADT, der geeignet ist, einen „Merkzettel” abzubilden. Sie können die Klasse Position nutzen, um die Positionen der Maus im Labyrinth zu protokollieren.
public class Position {
    private final int x, y;
    public Position(int x, int y) { this.x = x; this.y = y; }
    public int getX() { return x; }
    public int getY() { return y; }
}Tipp: Verwenden Sie neben dem Labyrinth zwei weitere Arrays. In einem halten sie die besuchten Positionen fest. Das andere nutzen Sie, um die Vorgängerposition einer neuen Mausposition, die Sie versuchen, festzuhalten. Aus diesen Vorgängerpositionen können Sie am Ende, wenn die Maus einen Ausweg gefunden hat, den gegangenen Weg rekonstruieren.
$ java MouseLab < data/labyrinth.txt
-- Ausgangslabyrinth --
* * * * * * * * * * * *
* * *   * * * * * * * *
* * *   *             *
* * *   * * * *   *   *
* * *   *   * *   *   *
* * *       * *   *   *
* * * * *         *   *
* * * * *     * * *   *
* * * *           *   *
* * * *   * * * * *   *
* * * *   * * *       *
* * * *   * * *   * * *

--- GEFUNDENER PFAD ---
* * * * * * * * * * * *
* * *   * * * * * * * *
* * *   *             *
* * *   * * * *   *   *
* * *   *   * *   *   *
* * *     o * *   *   *
* * * * * o       *   *
* * * * * o   * * *   *
* * * * o o       *   *
* * * * o * * * * *   *
* * * * o * * *       *
* * * * o * * *   * * *

$ java MouseLab < data/labyrinth2.txt
-- Ausgangslabyrinth --
* * * * * * * * * * * *
* * *   * * * * * * * *
* * *   *             *
* * *   * * * *   *   *
* * *   *   * *   *   *
* * *       * *   *   *
* * * * *         *   *
* * * * *     * * *   *
* * * *           *   *
* * * *   * * * * *   *
* * * *   * * *       *
* * * * * * * * * * * *

Kein Ausgang gefunden.

$ _import adt.ReferenceStack;
import StdLib.StdArrayIO;
import StdLib.StdIn;
import StdLib.StdOut;
/**
* Maus im Labyrinth.
*/
public class MouseLab {
/**
* Konvertierung einer numerischen Matrix (0, 1) in eine
* "graphische" Darstellung der Mauern und Wege.
*
* @param lab Matrix aus Nullen und Einsen
* @return graphisches Labyrinth
*/
private static char[][] convert(int[][] lab) {
int rows = lab.length, cols = lab[0].length;
char[][] new_lab = new char[rows][cols];
// Ziffern in Zeichen wandeln
for (int row=0; row<rows; row++)
for (int col=0; col<cols; col++)
new_lab[row][col] = lab[row][col] == 1? '*' : ' ';
return new_lab;
}
/**
* Prüfung, ob ein Schritt möglich ist.
*
* Wenn ja, dann protokollieren, andernfalls nichts.
*
* @param lab Labyrinth
* @param visited besuchte Zellen des Labyrinths
* @param previous Vorgängerzelle
* @param stack Stapelspeicher
* @param prev_pos vorherige Position
* @param try_x angedachte x-Position
* @param try_y angedachte y-Position
*/
private static void tryPush(char[][] lab,
boolean[][] visited,
ReferenceStack<Position> stack,
Position[][] previous,
Position prev_pos,
int try_x, int try_y) {
// außerhalb des Labyrinths?
if (!inBounds(lab, try_x, try_y)) return;
// schonmal besucht?
if (visited[try_x][try_y]) return;
// nicht frei?
if (lab[try_x][try_y] != ' ') return;
// ok, Wegpunkt kann beschritten werden
// --> als besucht markieren
visited[try_x][try_y] = true;
// --> Pfad merken
previous[try_x][try_y] = prev_pos;
// --> Wegpunkt merken
stack.push(new Position(try_x, try_y));
}
/**
* Markiere gefundenen Pfad im ursprünglichen Labyrinth.
*
* @param lab Labyrinth
* @param previous Wegpunkte
* @param exit Ausgang
*/
private static void markPath(char[][] lab,
Position[][] previous,
Position exit) {
// Vom Ausgang ausgehend, wird rückwärts der
// gegangene Weg, bis zum Startpunkt (null), im
// ursprünglichen Labyrinth markiert.
Position p = exit;
while (p != null) {
if (lab[p.getX()][p.getY()] == ' ') {
lab[p.getX()][p.getY()] = 'o';
}
p = previous[p.getX()][p.getY()];
}
}
// prüfe, ob Grenzen des Labyrinths eingehalten werden
private static boolean inBounds(char[][] lab, int x, int y) {
return x >= 0 && x < lab.length && y >= 0 && y < lab[0].length;
}
// prüfe, ob Ausgang erreicht
private static boolean isExit(char[][] lab, Position pos) {
int x = pos.getX();
int y = pos.getY();
return lab[x][y] == ' ' &&
(x == 0 || y == 0 || x == lab.length - 1 || y == lab[0].length - 1);
}
/**
* Bildschirmausgabe eines rechteckigen Labyrinths.
*
* @param lab Labyrinth
*/
private static void print(char[][] lab) {
int rows = lab.length-1, cols = lab[0].length-1;
for (int row=0; row<=rows; row++) {
for (int col = 0; col<=cols; col++)
StdOut.print(lab[row][col] + " ");
StdOut.println();
}
StdOut.println();
}
/**
* Wegsuche.
*
* @param lab Labyrinth
* @param start_x Startposition x-Koordinate
* @param start_y Startposition y-Koordinate
*/
private static void searchOnePath(char[][] lab, int start_x, int start_y) {
int rows = lab.length;
int cols = lab[0].length;
// Array zum Protokollieren der besuchten Wegpunkte
boolean[][] visited = new boolean[rows][cols];
// Array zum Aufzeichnen der erfolgreichen Wegpunkte
Position[][] previous = new Position[rows][cols];
ReferenceStack<Position> stack = new ReferenceStack<>();
visited[start_x][start_y] = true;
previous[start_x][start_y] = null; // Ausgangspunkt
stack.push(new Position(start_x, start_y));
Position exit = null; // noch kein Ausgang gefunden
while (!stack.empty()) {
Position p = stack.pop();
// wenn ein Ausgang gefunden wurde -> Suche abbrechen
if (isExit(lab, p)) {
exit = p;
break;
}
// feste Suchstrategie: links, rechts, hoch, runter
tryPush(lab, visited, stack, previous, p, p.getX(), p.getY() + 1);
tryPush(lab, visited, stack, previous, p, p.getX(), p.getY() - 1);
tryPush(lab, visited, stack, previous, p, p.getX() + 1, p.getY());
tryPush(lab, visited, stack, previous, p, p.getX() - 1, p.getY());
}
if (exit == null) {
StdOut.println("Kein Ausgang gefunden.");
return;
}
// es wurde ein Weg gefunden -> in Labyrinth markieren und ausgeben
markPath(lab, previous, exit);
StdOut.println("--- GEFUNDENER PFAD ---");
print(lab);
}
/**
* Einlesen eines Labyrinths über die Standardeingabe. Der Weg
* der Maus wird ausgegeben, wenn sie einen Ausgang findet.
*
* @param args nicht genutzt
*/
public static void main(String[] args) {
int mousePosX = StdIn.readInt(); // Mausposition einlesen
int mousePosY = StdIn.readInt();
char[][] lab = convert(StdArrayIO.readIntMatrix());
// initiales Labyrinth ausgeben
StdOut.println("-- Ausgangslabyrinth --");
print(lab);
searchOnePath(lab, mousePosX, mousePosY);
}
}Übungen zu Kapitel Hashing
Im Folgenden besteht Ihre Aufgabe darin, das Hashing von Vornamen manuell, mit Papier und Bleistift, durchzuführen. Dazu sei die folgende Hash-Funktion gegeben.
s sei die Zeichenkettendarstellung eines Objekts x (s = str(x)).
f(s) = \left(\sum\limits_{i=0}^{N-1}\text{ord}(s_i)\right) \text{ MOD } N
Wir addieren die Codierung der einzelnen Zeichen und teilen die Summe ganzzahlig mit Rest durch N. Die Modulo-Operation stellt sicher, als Indexwert für die Speicherung eines Namens, einen Wert im Intervall [0, N-1] zu erhalten, einer gültigen Index-Adresse im Array der Hash-Tabelle.
Sie können sich gerne ein Java-Programm HashFunc.java schreiben, wenn Sie das wollen. Es erwartet als Kommandozeilenargumente die Größe der Hash-Tabelle und den Namen, dessen Hash-Wert bestimmt werden soll.
Beispiel:
$ java HashFunc 10 Sören
4
$ java HashFunc 10 Maike
7
$ _
Offenes Hashing
Gegeben sei eine Hash-Tabelle mit der Array-Größe 10. Zeichnen Sie die Hash-Tabelle für das Einfügen der folgenden Werte: Sören, Maike, Michael, Klaus, Ruben, Jürgen, Adele und Karsten.
Geschlossenes Hashing
Verwenden Sie die Daten aus „Offenes Hashing” und zeichnen eine entsprechende Hash-Tabelle für das geschlossene Hashing. Als Hashing-Strategie verwenden Sie das lineare Sondieren.
Verwenden Sie die Statuskennzeichnungen: E (Empty), O (Occupied), D (Deleted).
Bestimmen Sie den Auslastungsgrad der Hash-Tabelle.
Weitere Operationen:
- Löschen Sie Karsten. Zeichnen Sie die Hash-Tabelle.
- Fügen Sie Horst hinzu. Zeichnen Sie die Hash-Tabelle.
Hinweis: Halten Sie unbedingt die Zwischenstatus der Tabelle fest.
Ich habe mir ein Hilfsprogramm HashFunc.java geschrieben.
import StdLib.StdOut;

/**
 * Beispiel für eine einfache Hash-Funktion.
 */
public class HashFunc {
    public static void main(String[] args) {
        int size = Integer.parseInt(args[0]);
        String name = args[1];
        int hashValue = 0;

        int total = 0;
        for (int i = 0; i < name.length(); i++)
            total += (int)name.charAt(i);

        if (total > 0) {
            hashValue = total % size;
            StdOut.println(hashValue);
        }
        else {
            StdOut.println("Ungültige Eingabe.");
        }
    }
}
Offenes Hashing
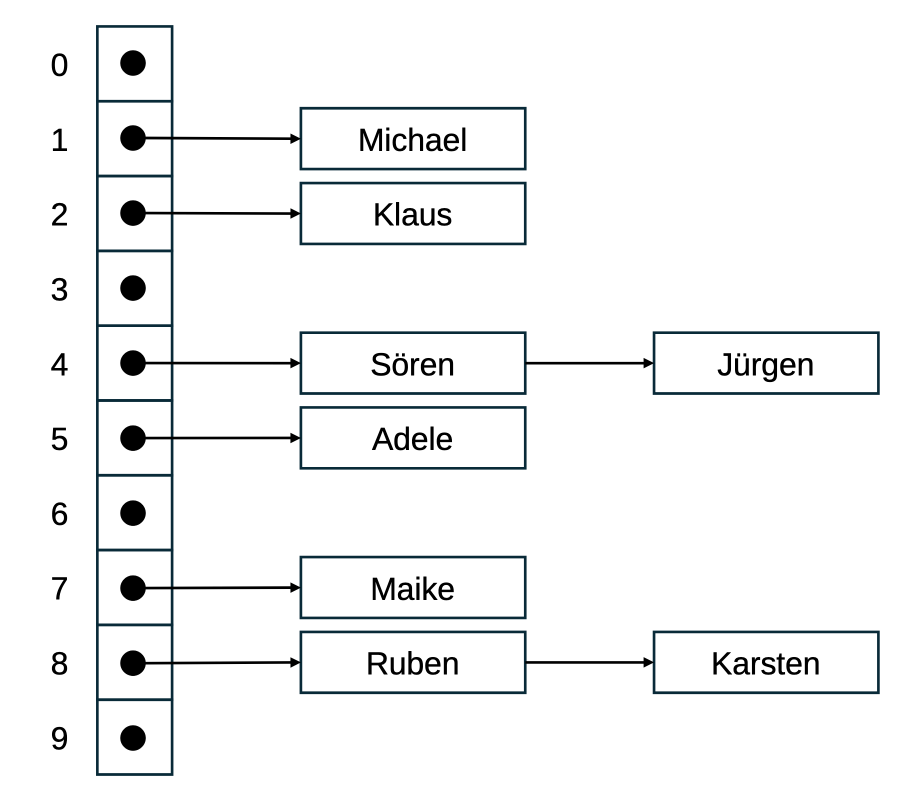
Geschlossenes Hashing
Schritt 1:
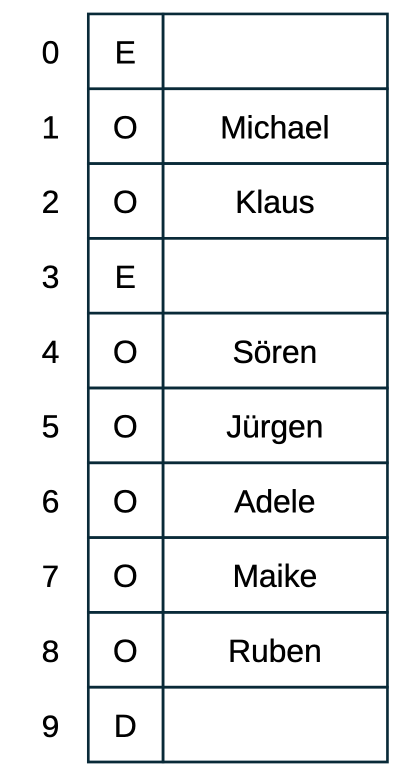
Schritt 2:
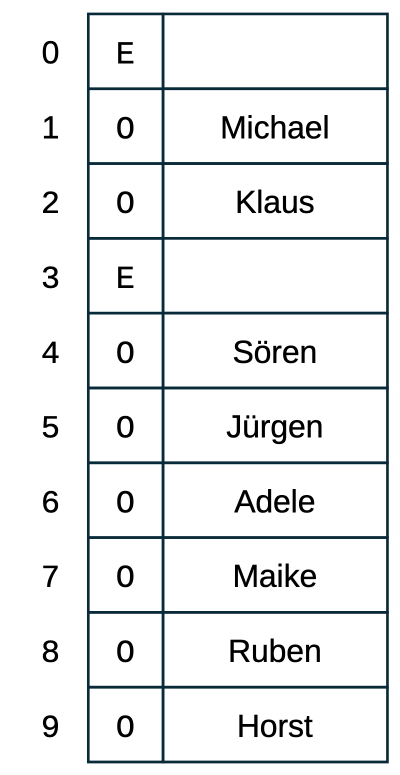
Schritt 3:
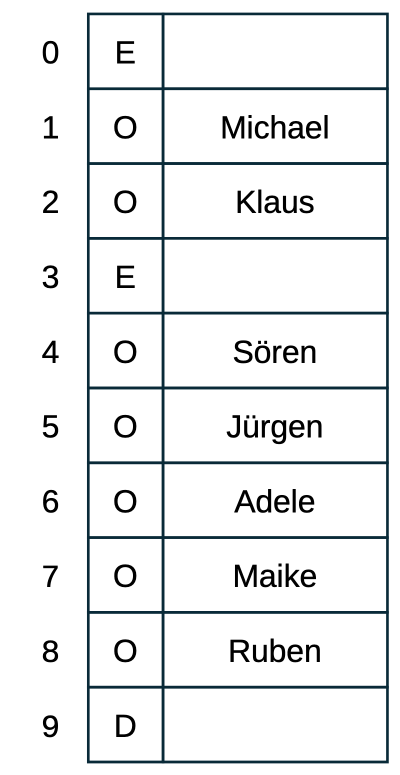
Bei 8 belegten Plätzen und Tabellengröße 10 ist
\alpha = \frac{8}{10} = 0.8 = 80\text{\%}
Übungen zu Kapitel Graphen
Adjazenzmatrizen: Erreichbarkeiten
Gegeben sei der folgende Graph.
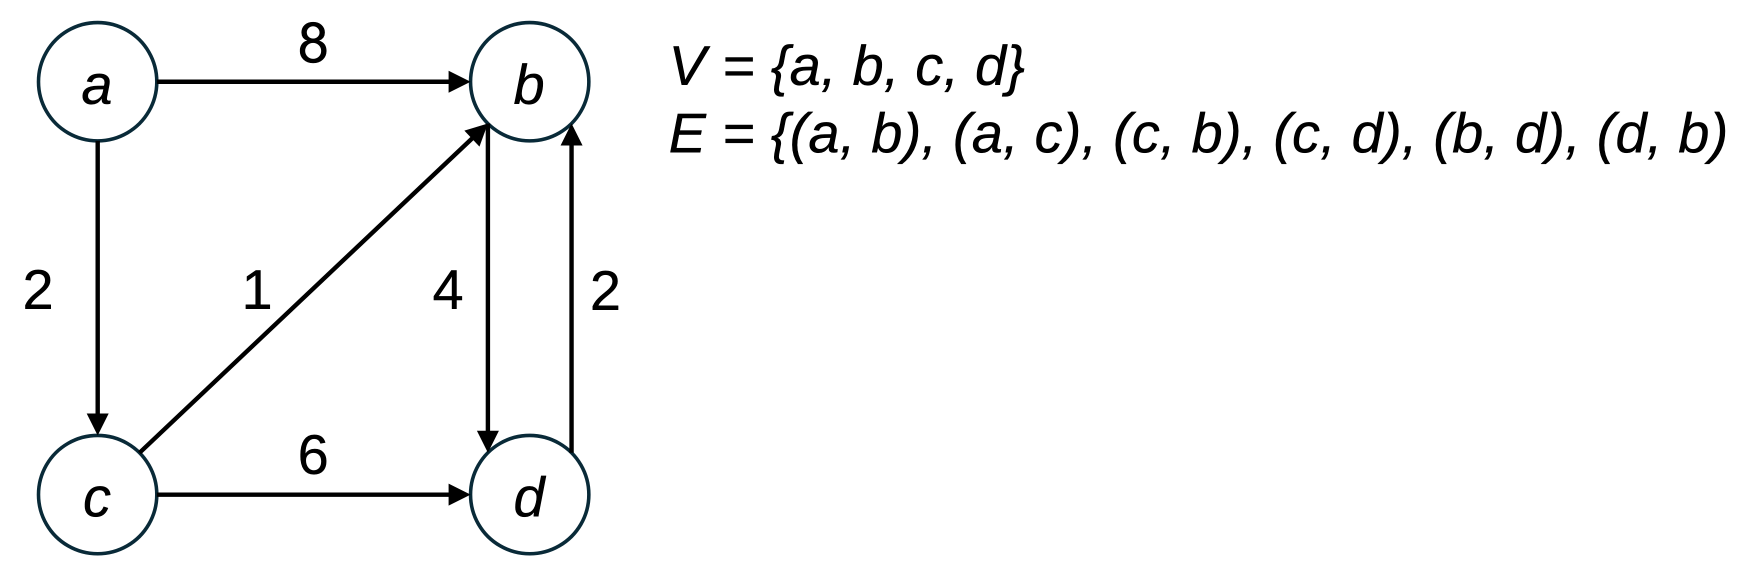
Wir interessieren uns nicht für die Kosten. Uns interessiert allein die Erreichbarkeit der Knoten untereinander.
Stellen Sie diesen Sachverhalt als Matrix dar. 1 bedeutet Knoten x erreicht Knoten y. Eine 0 bedeutet, dass keine Verbindung zwischen zwei Knoten besteht.
Achten Sie darauf, dass jeder Knoten sich selbst erreichen kann.
Schreiben Sie ein Programm, welches für jeden Knoten des Graphen berechnet, welche Knoten von ihm jeweils direkt oder auch über Zwischenknoten erreichbar sind. Gäbe es beispielsweise in einem Graphen einen Weg a-c-d-e, wäre das Knotenpaar a-e, Bestandteil der Lösung, auch wenn die Verbindung zwischen a und e nur virtuell, indirekt über andere Knoten, besteht. Die Menge aller Knotenpaare, die den genannten Bedingungen entsprechend, nennen wir Transitive Hülle eines Graphen.
Implementieren Sie eine Klasse Warshall mit einer statischen Methode transClosure(), die alle denkbaren Verbindungen zwischen den Knoten eines Graphen berechnet.
Testen Sie Ihr Programm auch mit graph2.txt. Geben Sie für beide Graphen die Anfangsmatrix als auch die Ergebnismatrix aus.
package graph;

/**
 * Implementierung des Warshall-Algorithmus für eine transitive
 * Hülle auf einer Adjazenzmatrix.
 */
public class Warshall {

    public static void transClosure(
                            int n,          // Matrix-Dimension
                            int [][] p) {   // errechnete Erreichbarkeitsmatrix
        int i, j, k;                        // Laufvariablen

        for (k = 0; k < n; k++)             // für jede Knotenobergrenze
            for (i = 0; i < n; i++)         // für jede Zeile
                for (j = 0; j < n; j++)     // für jede Spalte
                    // wenn ein Weg von 'i' nach 'k' und
                    // von 'k' nach 'j' führt, markiere
                    // 'i' nach 'j' als möglich.
                    // (Transitivität)
                    if (p[i][k] == 1 && p[k][j] == 1)
                        p[i][j] = 1;
    }
}
Ein Testclient:
import StdLib.StdArrayIO;
import StdLib.StdOut;
import graph.Warshall;

/**
 * Testclient für die Klasse {@link graph.Warshall}.
 */
public class WarshallTest {

    // Matrix ausgeben
    private static void printMatrix(int[][] m) {
        for (int i = 0; i < m.length; i++) {
            for (int j = 0; j < m.length; j++) {
                StdOut.printf("%6d", m[i][j]);
            }
            StdOut.println();
        }
        StdOut.println();
    }


    public static void main(String[] args) {
        int[][] matrix = StdArrayIO.readIntMatrix();
        int N = matrix.length;

        StdOut.println("Gegebene Matrix:");
        printMatrix(matrix);

        Warshall.transClosure(N, matrix);
        StdOut.println("Errechnete Erreichbarkeitsmatrix:");
        printMatrix(matrix);
    }
}
Beispielsitzungen:
$ java WarshallTest < data/mgraph1.txt
Gegebene Matrix:
     1     1     1     0
     0     1     0     1
     0     1     1     0
     0     1     0     1

Errechnete Erreichbarkeitsmatrix:
     1     1     1     1
     0     1     0     1
     0     1     1     1
     0     1     0     1
$ java WarshallTest < data/mgraph2.txt
Gegebene Matrix:
     1     1     1     0     0
     0     1     0     1     1
     0     1     1     1     0
     0     0     0     1     0
     0     0     0     0     1

Errechnete Erreichbarkeitsmatrix:
     1     1     1     1     1
     0     1     0     1     1
     0     1     1     1     1
     0     0     0     1     0
     0     0     0     0     1
$ _
OOP-Modell Adjazenzlisten: Erreichbarkeiten
In der vorangegangenen Aufgabe haben Sie Erreichbarkeiten mittels Adjazenzmatrizen berechnet. Das geht natürlich auch mithilfe von Adjazenzlisten. Das dazu erforderliche Vorgehen ist allerdings etwas komplexer. Sie können nicht, wie bei einer Matrix, einfach die Schnittpunkte von Spalte und Zeile auswerten. - Die gibt es bei Adjazenzlisten nicht.
Außerdem haben wir unser OOP-Modell so aufgebaut, das es explizit mit beliebigen Knotennamen, nicht Indizes modelliert ist. Daher ist die Ausgabedarstellung in dieser Aufgabe keine Matrix, sie sollen für jeden Knoten des Graphen eine Liste der von ihm jeweils erreichbaren Knoten ausgeben. - Das entspricht inhaltlich den Erreichbarkeitsmatrizen der vorigen Aufgabe. Lediglich die Darstellung ist dem aktuellen Modell angepasst. Beachten Sie außerdem, dass die Liste der erreichbaren Knoten keiner Sortierung folgt. Zur Erinnerung: Wir verwenden in der OOP-Modellierung eines Graphen eine Hash-Tabelle für die Assoziation der Knotennamen. Die von einem Knoten ausgehenden Kanten sind Listen. Beide ADTs definieren keine Ordnung im Sinne einer Sortierung!
Erstellen Sie eine Klasse Reachable. Sie soll eine Methode reachableVertices() besitzen. Ihr wird der zu analysierende Graph als Parameter übergeben. Das Ergebnis, eine Erreichbarkeitsliste pro Knoten im Graphen, wird ausgegeben.
Stellen Sie folgende Überlegungen an:
- Sie haben die Erreichbarkeiten pro Knoten des Graphen zu prüfen.
- Welches der Algo-Felder nutzen Sie, um die Erreichbarkeit eines Knotens zu protokollieren?
- Überlegen Sie sich eine Strategie, wie Sie vom jeweiligen Startknoten ausgehend, alle von ihm erreichbaren Knoten traversieren und entsprechend markieren.
- Vergessen Sie nicht, nach jeder Traverse die Algo-Felder zurückzusetzen.
Die Erreichbarkeit ist eine Eigenschaft des Graphen und unabhängig von der konkreten Traversierungsreihenfolge.
Nutzen Sie zum Testen die folgende main()-Methode in der Klasse GraphTest, dem Test-Driver:
public static void main(String[] args) {
     if (args.length < 2) {
          StdErr.println("Usage: java GraphTest size filename");
          System.exit(1);
     }

     int size = Integer.parseInt(args[0]);
     Graph g = GraphIO.readGraph(size, args[1]);
     GraphIO.printGraph(g);

     Reachable.reachableVertices(g);
}
Rufen Sie das Programm dann wie folgt auf:
$ java GraphTest 10 data/graph1.txt Für andere Graphen muss das erste Kommandozeilenargument gegebenenfalls modifiziert, der Größe des Graphen entsprechend, angepasst werden. - Sie kennen das aus dem Seminar.
package graph;

import adt.EnumList;
import adt.ReferenceStack;
import StdLib.StdOut;

/**
 * Die Klasse prüft, ob Knoten innerhalb eines Graphen ({@link graph.Graph})
 * erreichbar sind.
 */
public class Reachable {

    /**
     * Prüfe für alle Knoten des Graphen, welche Knoten jeweils
     * erreichbar sind und gib diese aus.
     *
     * @param g Graph
     */
    public static void reachableVertices(Graph g) {
        Vertex[] vertices = g.vertices();              // Knotenliste holen
        int N = vertices.length;
        StdOut.println("Erreichbarkeiten: ");
        for (int i = 0; i < N; i++) {                  // für jeden Knoten
            dfsFromVertex(g, vertices[i]);             // erreichbare Knoten ermitteln
            printReachable(g, vertices[i].getName());  // und ausgeben
        }
    }

    /** Ausgabe der jeweils erreichbaren Knoten
     *
     * @param g Graph
     */
    private static void printReachable(Graph g, String start) {
        StdOut.print(start + ": ");
        Vertex[] v = g.vertices();
        for (int i = 0; i < v.length; i++)
            if (v[i].getSeen()) // nur besuchte Knoten ausgeben
                StdOut.printf("%s  ", v[i].getName());
        StdOut.println();
    }

    /**
     * Tiefensuche.
     *
     * @param g Graph
     * @param start Startknoten
     */
    private static void dfsFromVertex(Graph g, Vertex start) {
        ReferenceStack<Vertex> s = new ReferenceStack<>();
        int i;                                             // Laufvariable
        Vertex[] vertices = g.vertices();                  // Knotenliste holen
        for (i = 0; i < vertices.length; i++)              // alle Knoten als
            vertices[i].resetAlgoFields();                 // nicht besucht markieren

        s.push(start);
        while (!s.empty()) {
            Vertex vertex = s.pop();
            if (vertex.getSeen()) continue;

            vertex.setSeen(true);

            EnumList<Edge> eList = new EnumList<>(vertex.getEdges());
            while (eList.hasMoreElements()) {
                Edge edge = (eList.nextElement());
                Vertex neighbour = edge.getDest();
                s.push(neighbour);
            }
        }
    }
}
Beispielsitzung:
$ java GraphTest 10 data/graph1.txt
Adjazenzlisten des Graphen:
(d, b) = 2.00
(a, c) = 2.00   (a, b) = 8.00
(b, d) = 4.00
(c, d) = 6.00   (c, b) = 1.00

Erreichbarkeiten:
d: d  b
a: d  a  b  c
b: d  b
c: d  b  c
$ _